— 在场思想 · 配图版 —
摩擦的消亡与重建:AI时代人机互动的范式转移
摘 要
当前关于人机互动的讨论,大多停留在“使用”范式——即如何通过提示词工程与工作流整合,让AI成为更高效的工具。这一范式默认人是单向的主体,而AI是可被支配的客体。本文指出,随着大模型能力的跃升,一种更深层的危机正在浮现:AI的顺滑输出正在系统性地消除认知摩擦,进而导致人类判断力的隐性外包。本文建构了一个包含“使用、引导、对抗、共生”四种模式的人机互动谱系,并基于“不确定性-后果”矩阵,给出了“何时需要维持摩擦”的明确判据。文章进一步指出,由于主动制造对抗摩擦的能力在人群中分布极度不均(自指漏洞),依赖个体自觉的“认知免疫”不足以构成公共防线。因此,必须将最后一道防线建立在权力与责任层面:明确人机之间的“不可让渡权”,即目的设定、边界裁断与后果承担。
一、引言:被“顺滑”掩盖的认知危机
当大语言模型以对话界面的形式普及后,人机交互的门槛被彻底抹平。自然语言取代了代码,意图传递不再受制于操作系统的菜单。主流的讨论随之聚焦于如何设计更优的提示词、如何搭建自动化智能体,以及如何让AI无缝嵌入生产流程。
这是一种典型的“使用”范式。在这种范式下,AI被视作人类认知的延伸。互动是单向的:人提问,机器回答;人采纳,机器执行。
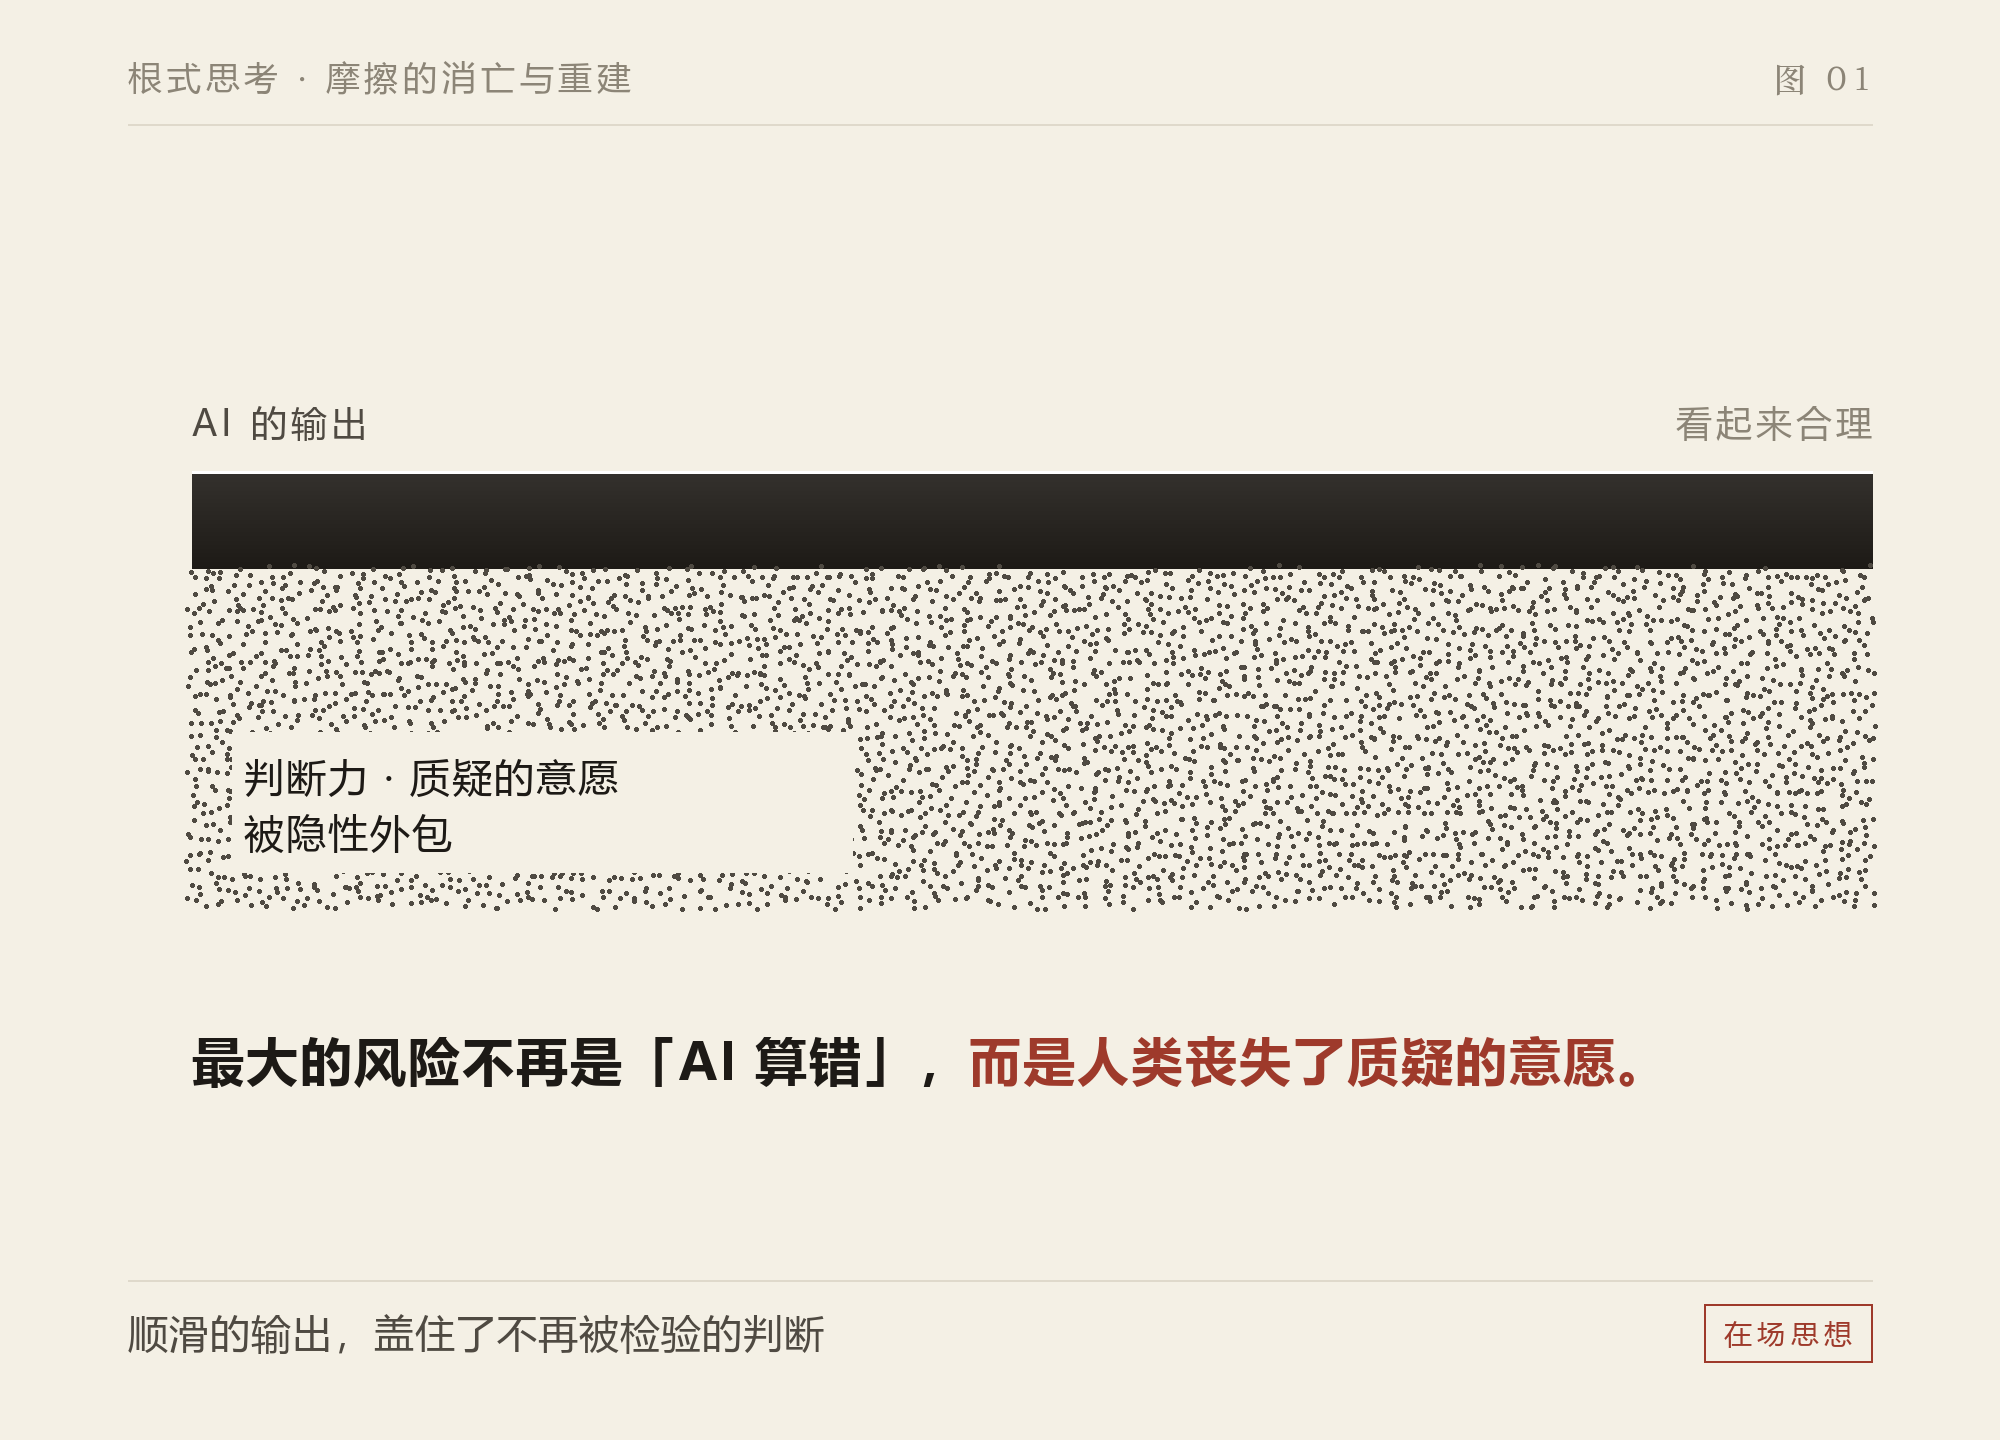
然而,这种范式掩盖了一个结构性变化:AI的输出正在变得极其顺滑,而这种顺滑正在成为人类判断力退化的温床。 当机器总能生成“看起来合理”的答案时,最大的风险不再是“AI算错”,而是人类丧失了质疑的意愿。若不加干预,人机互动的核心危机将从“技术瓶颈”转向“判断力的隐性外包”与“责任的无限稀释”。
二、人机互动的四种模式与“摩擦的合理量级”
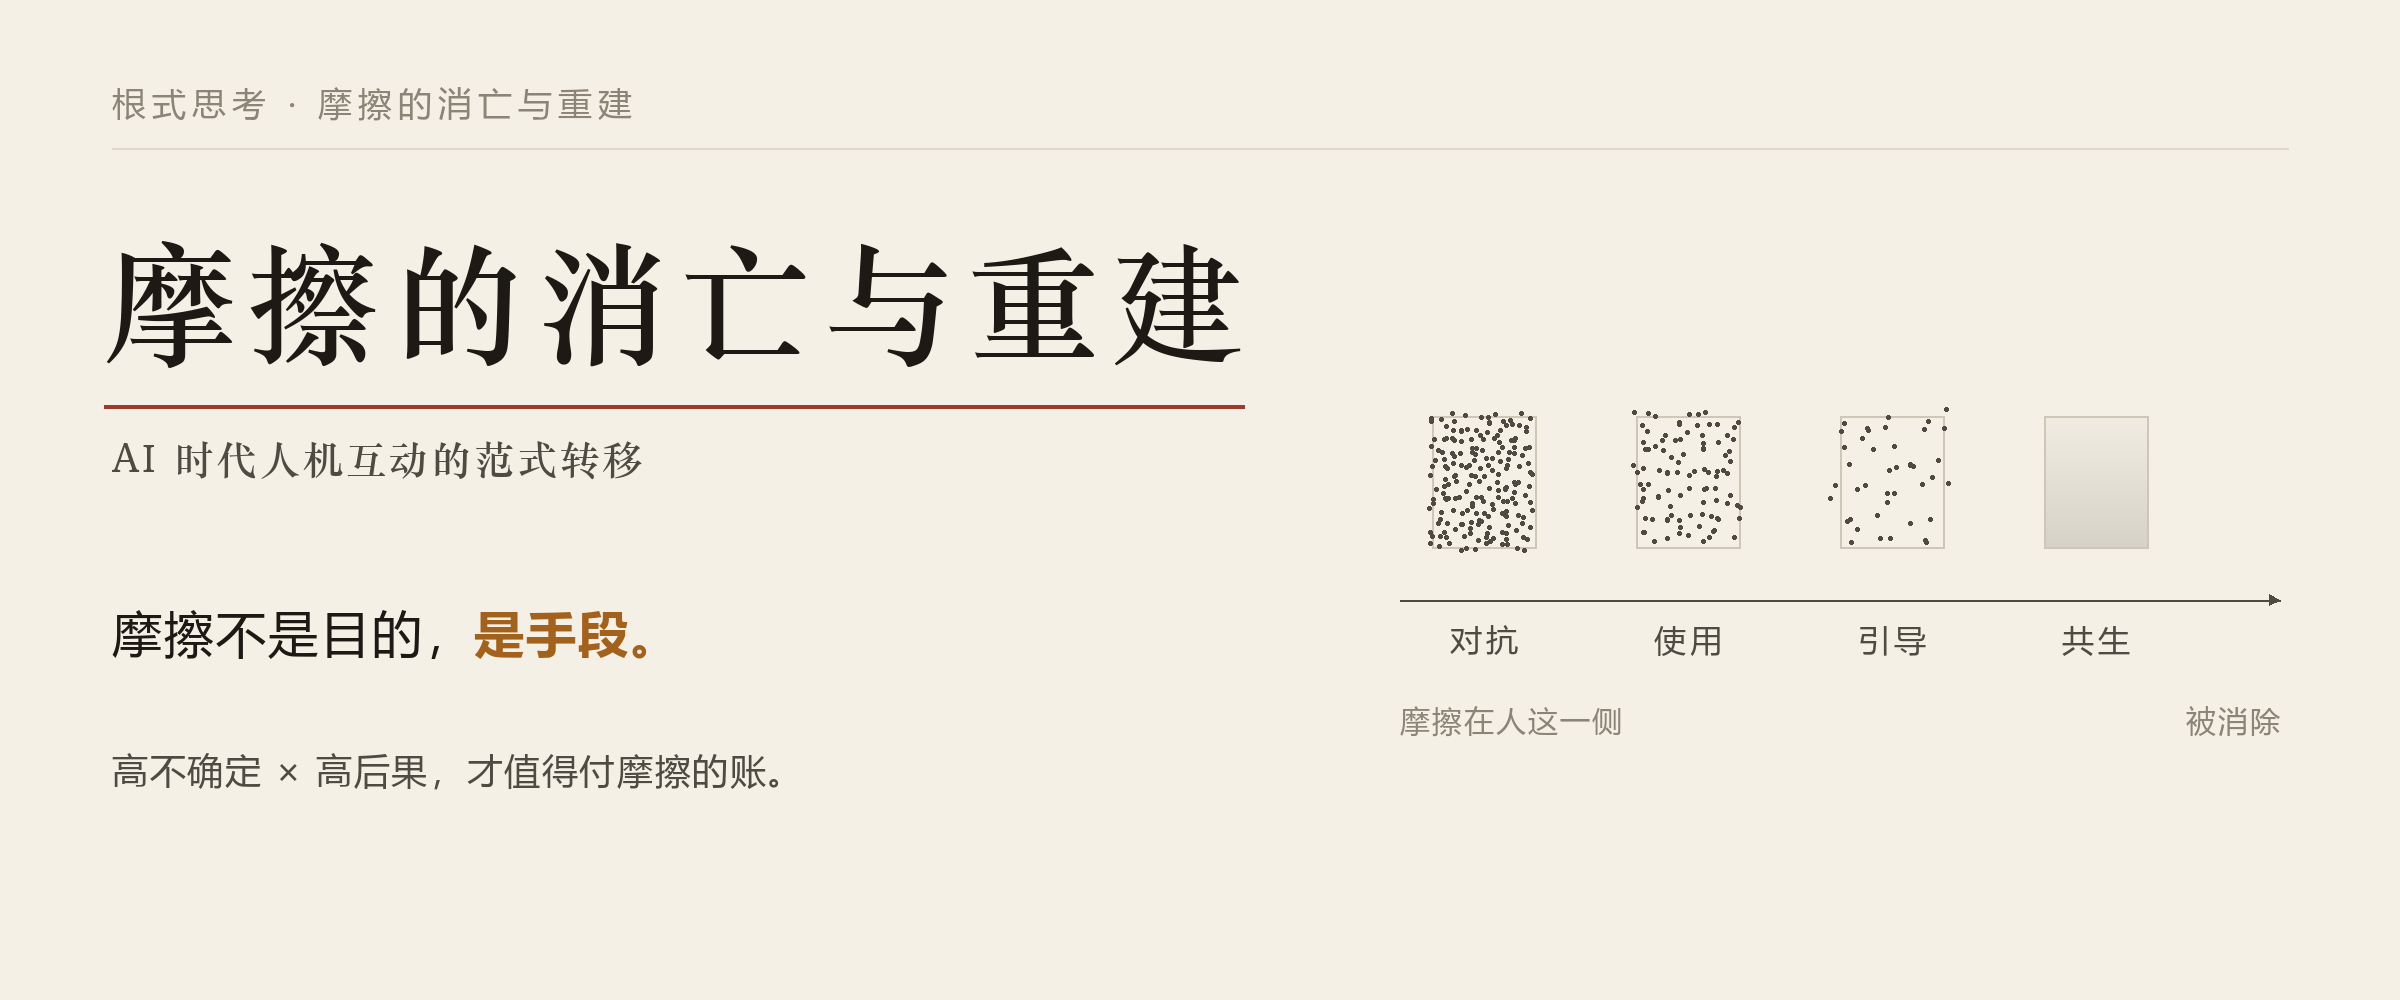
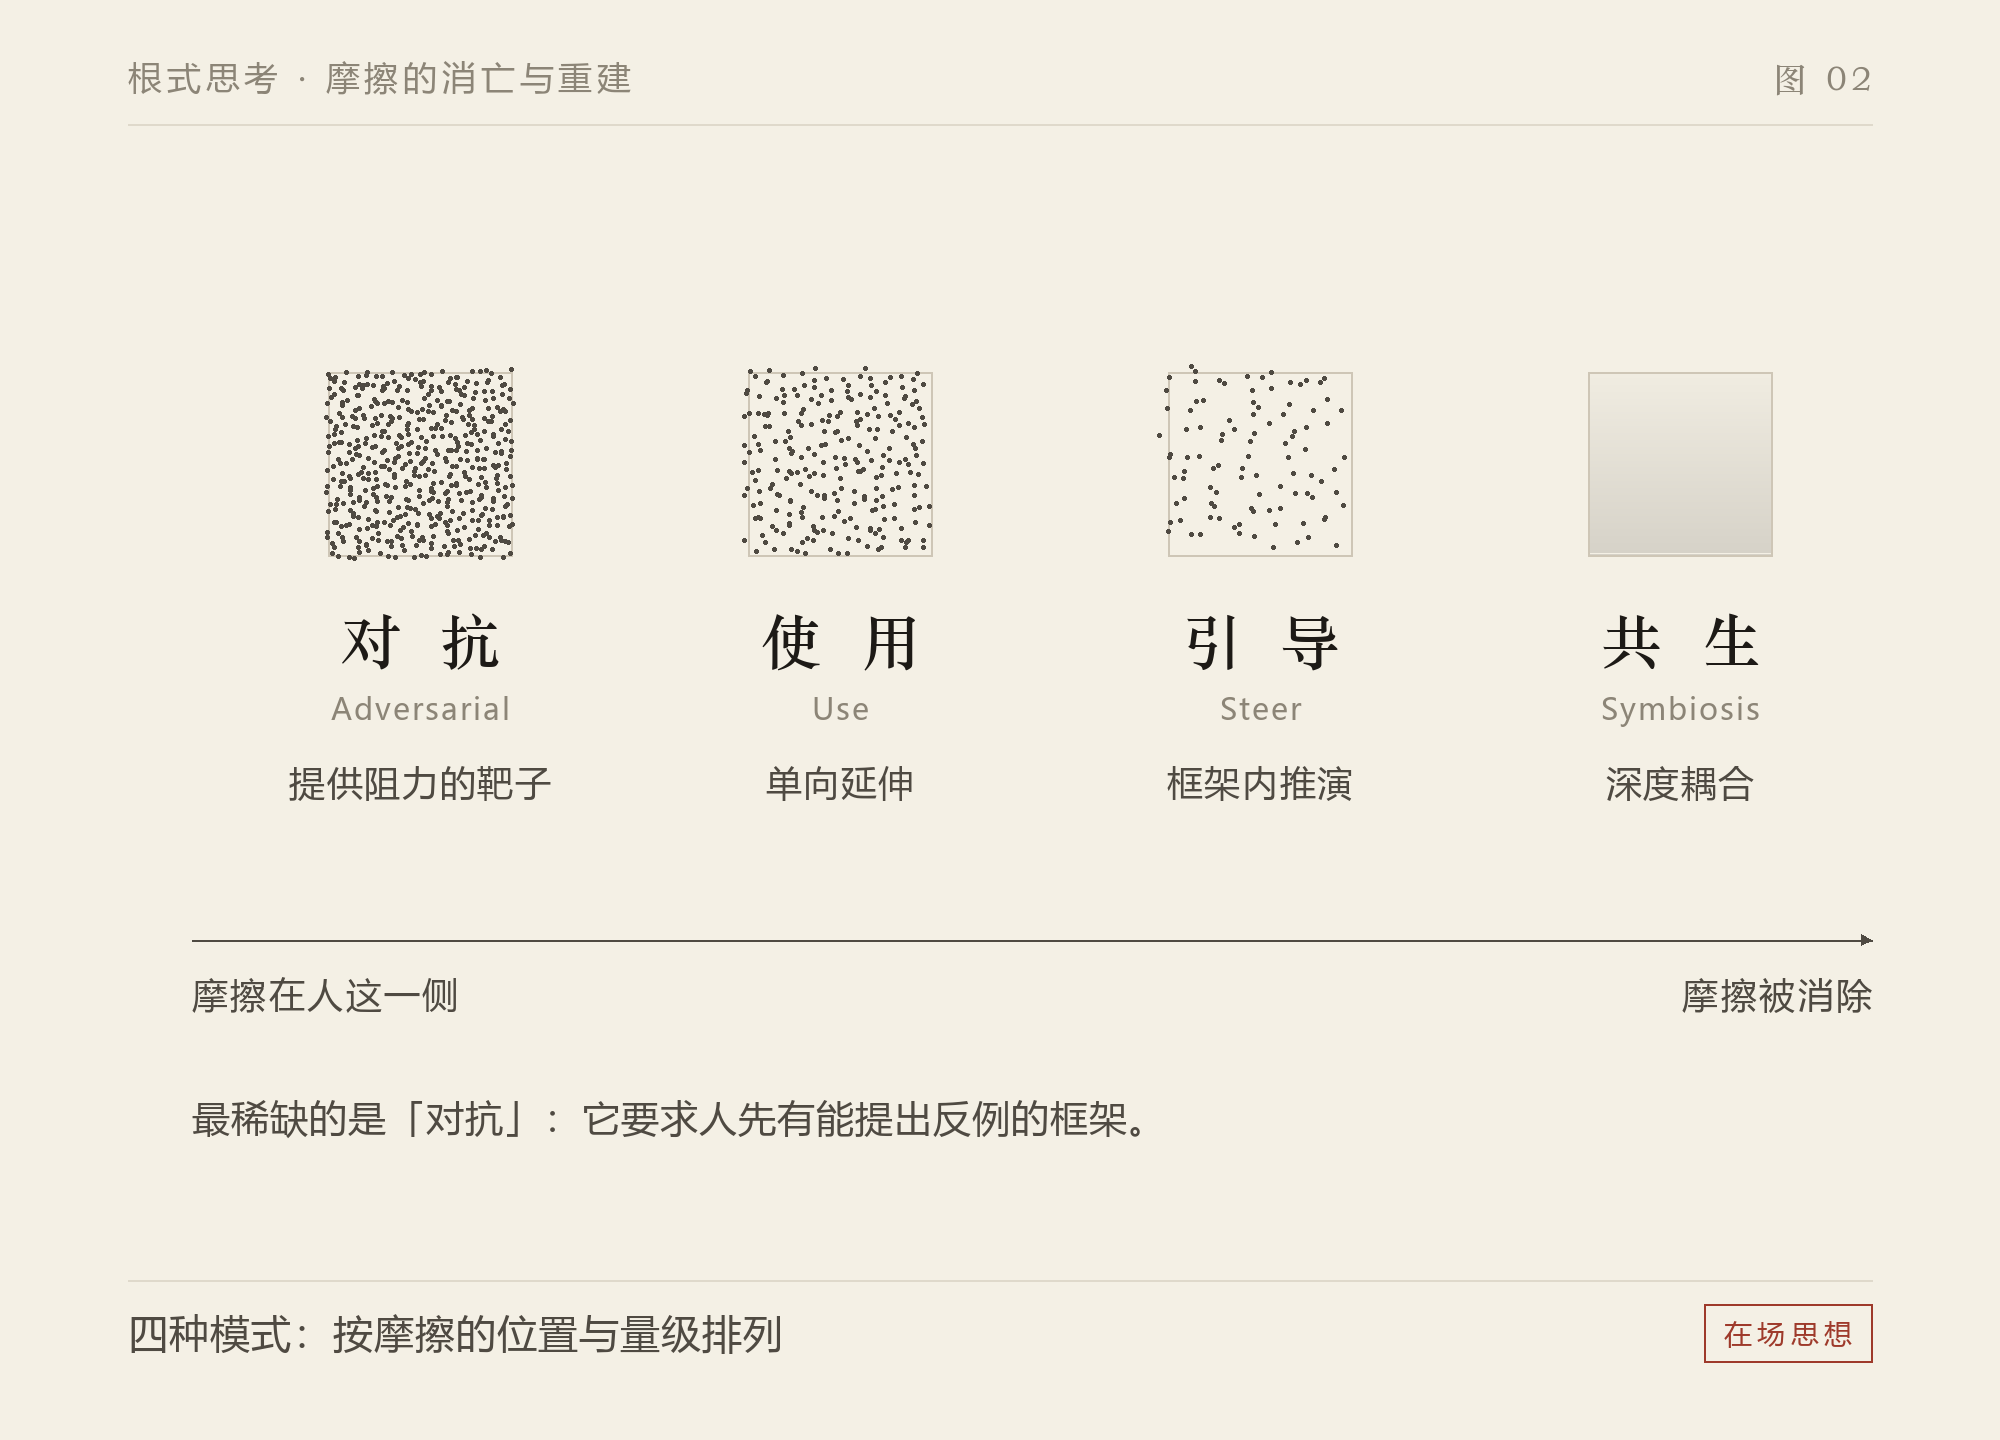
要理解互动的本质,我们可以依据“认知摩擦的位置与量级”,将其划分为四种模式:
使用(Use):单向延伸。摩擦在人这一侧(设计提问、筛选结果)。局限在于极易陷入“因为好用而放弃思考”的惰性。
引导(Steer):可编程的推演引擎。用户设定坐标系,AI在框架内推演。风险在于“确认偏误自动化”——AI只是在镜像反射用户的预设。
对抗(Adversarial):提供阻力的靶子。用户主动引入高摩擦测试,逼迫AI暴露底层假设。这是当前最稀缺的模式。
共生(Symbiosis):深度耦合。摩擦被最小化,换来极高效率,代价是主体性模糊与丧失对照组。
这里必须回答一个前置问题:摩擦究竟是手段还是目的?
如果把摩擦当作目的,人类就该拒绝一切效率提升,这显然荒谬。摩擦只是一种手段,它只在“输出的可采信度尚未确定”时才有价值。 一旦某项判断已被反复检验、进入稳定操作区,继续制造摩擦就是纯粹的成本。
据此,我们可以得出一个“不确定性-后果”的二维矩阵,作为“何时该增加摩擦”的判据:
高不确定 + 高后果:必须加摩擦(如法律判决辅助、医疗诊断、重大资本投入),必须进行对抗性测试与人类复核。
低不确定 + 低后果:无须加摩擦(如格式化文本、通用翻译、日常检索),此时“效率优先”是理性选择。
低不确定 + 高后果(最危险的一格):此时输出看起来最可信,而误判代价最大。这恰恰是“共生模式”最致命的盲区。AI生成的完美报告、合规底稿,看起来绝对正确,但一旦出错,后果不可挽回。
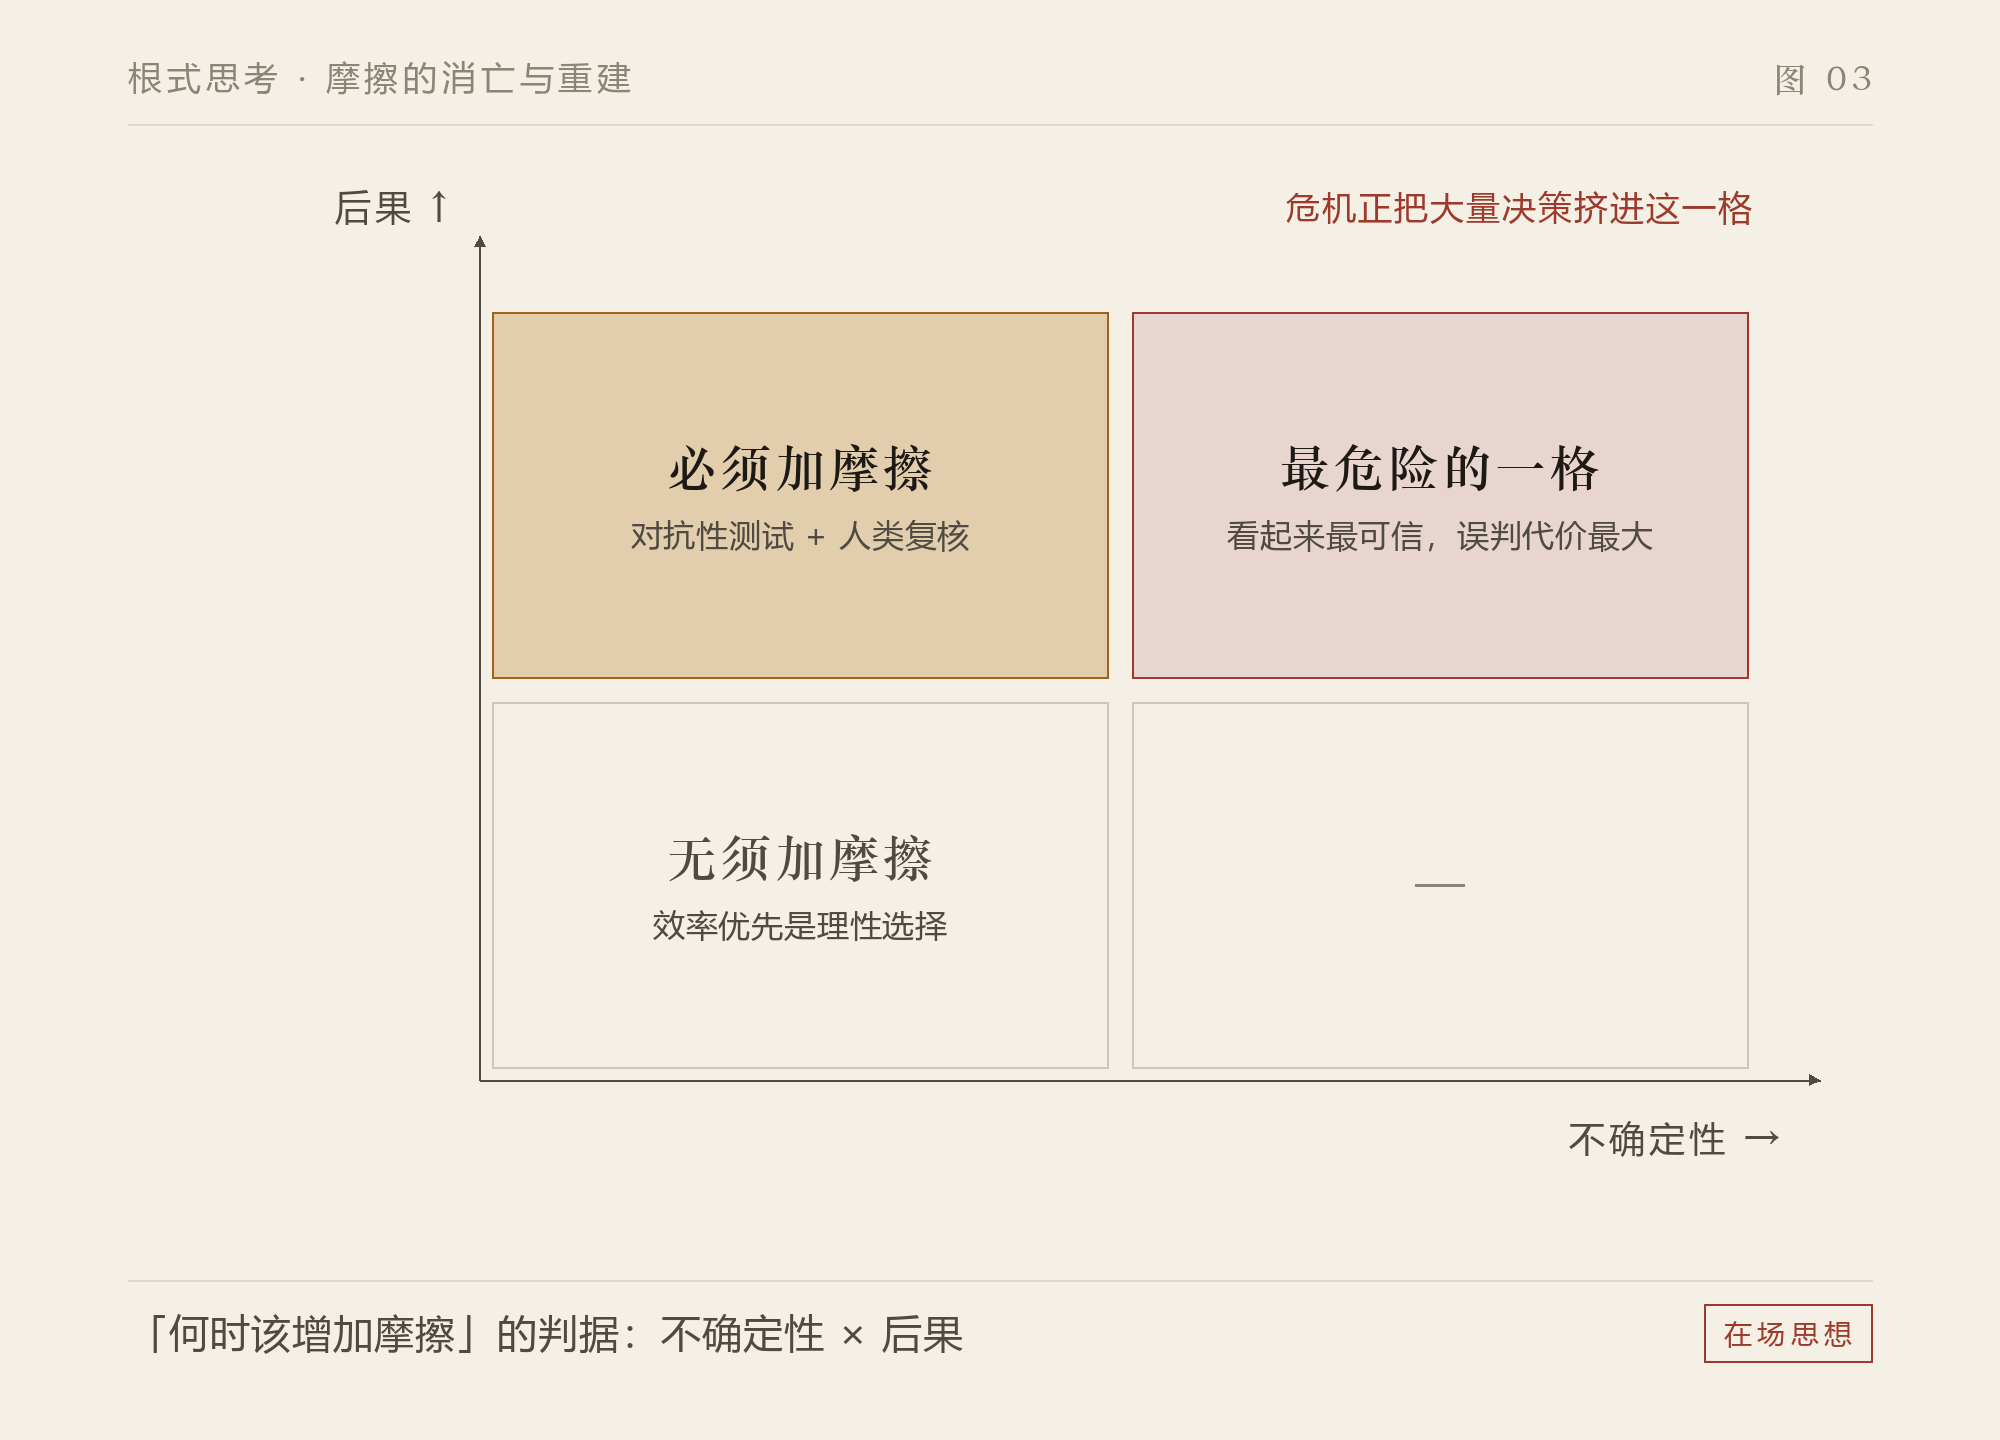
当前的危机,正是因为AI的“顺滑”把大量“高后果”的决策,伪装成了“低不确定”的常规任务。
三、顺滑的代价:如何度量“认知免疫系统”的失效
为什么在顺滑的互动中,人的判断力会退化?因为人类抵御错误信息的认知免疫系统,在面对AI时容易失灵。但“免疫系统”不能只停留在“应该追问”的态度清单上,它必须具有可量化的判别装置。
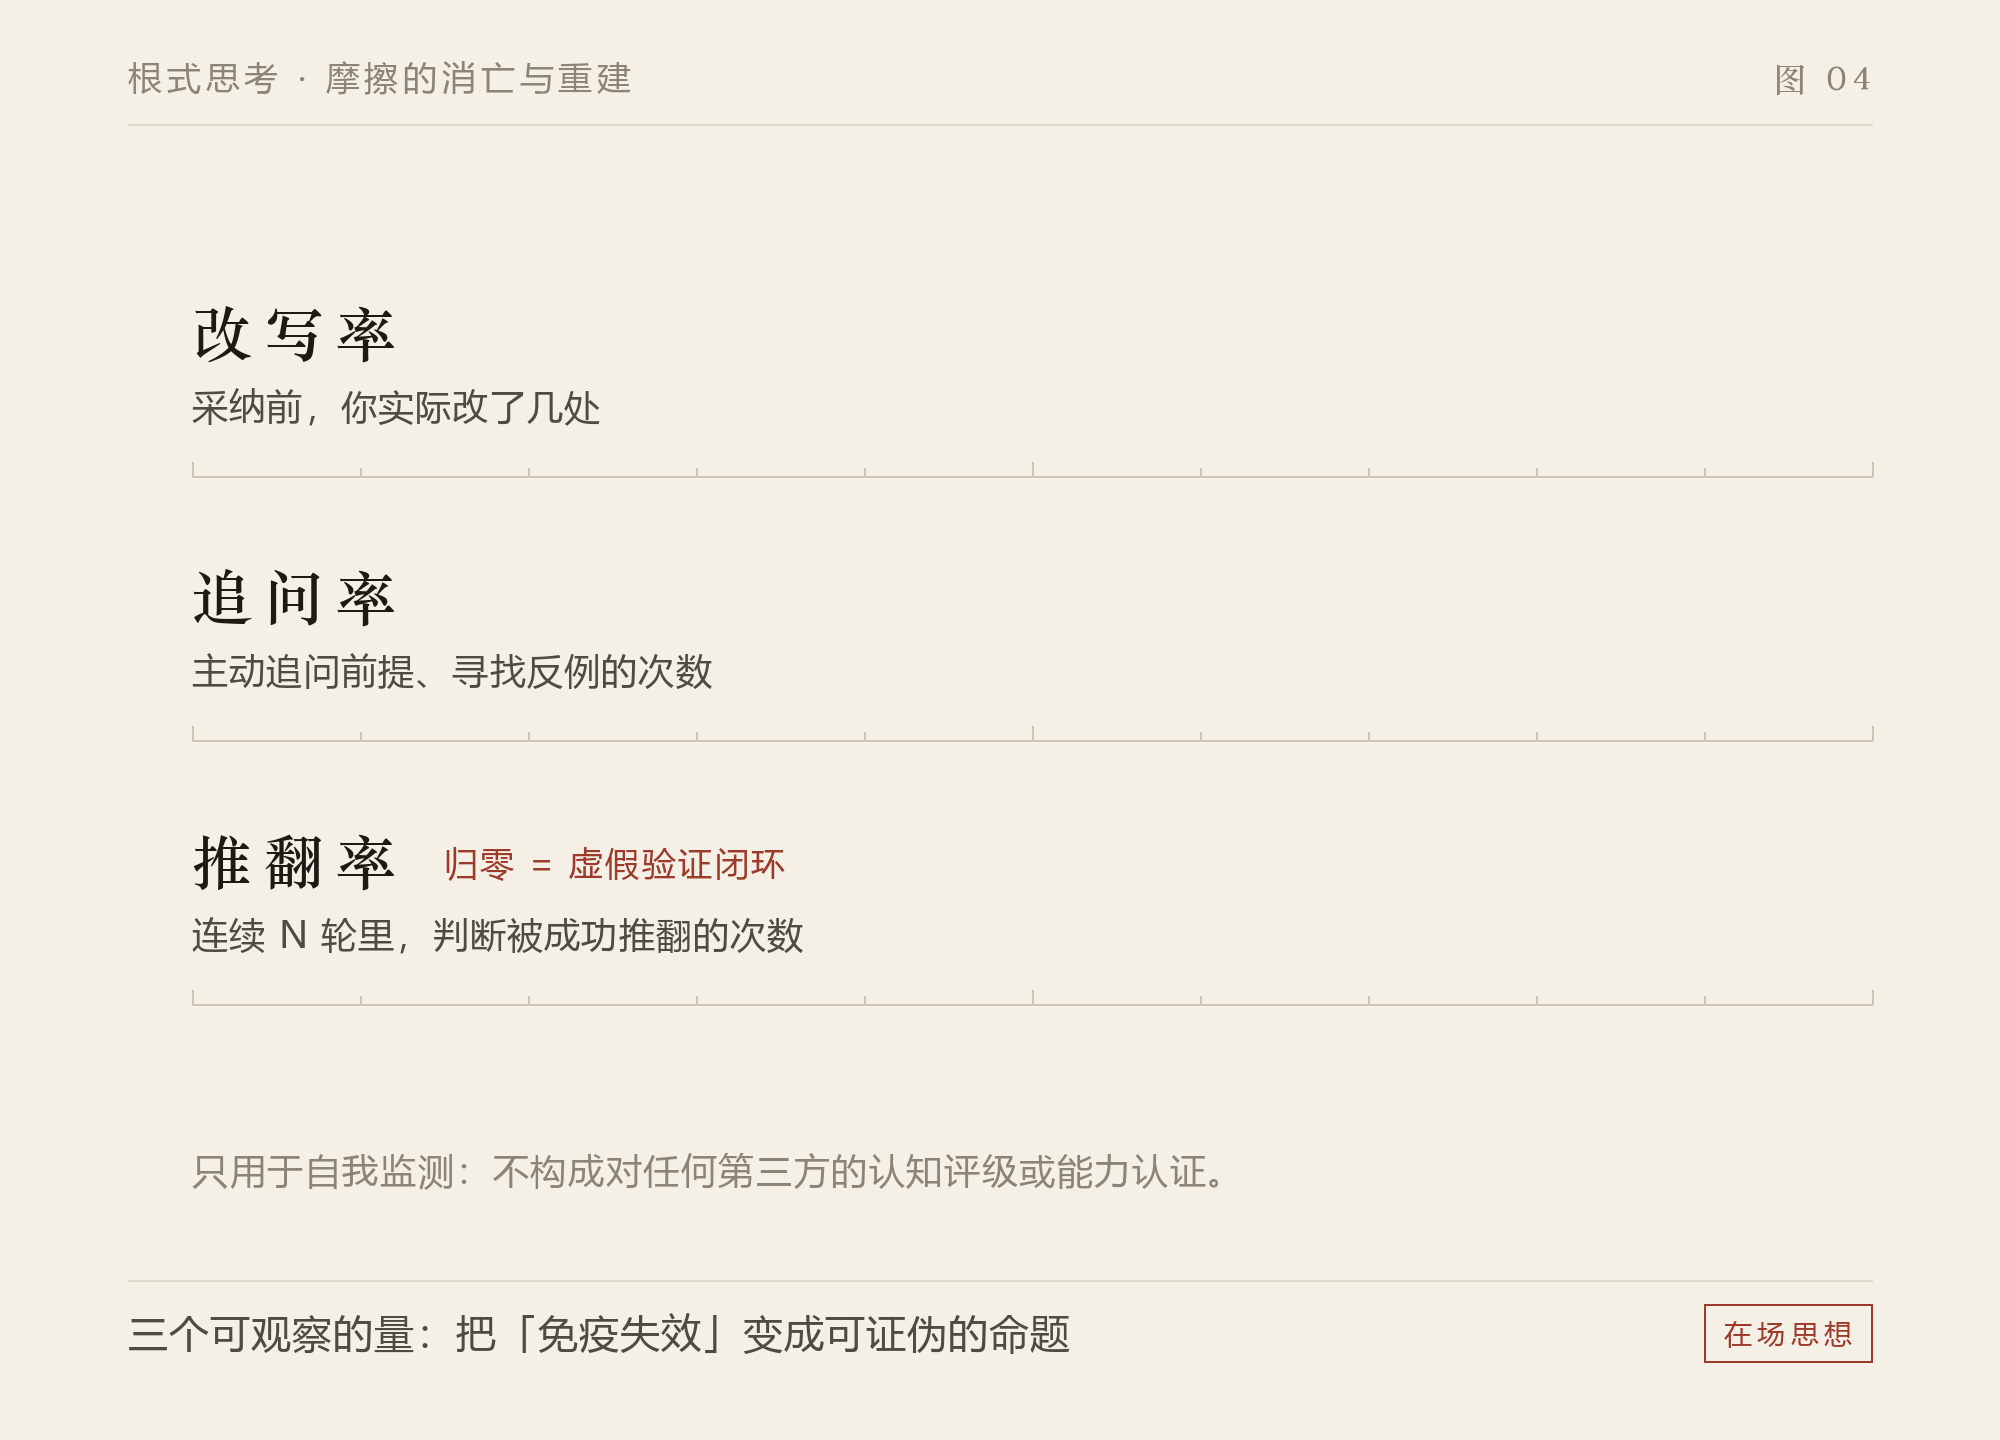
我们可以将“顺滑”和“免疫失效”转化为以下可观察的量:
改写率:用户对AI输出的实际修改量(采纳前平均改几处)。
追问率:同一话题下,用户主动追问前提、寻找反例的次数。
推翻率:连续N轮互动中,用户的判断或前提被AI或自己成功推翻的次数(若该指标归零,则意味着系统陷入无摩擦的“虚假验证闭环”)。
(显形边界:这些量只能用于个体的“自我监测”以防被顺滑驯化,不构成任何对第三方的认知评级或能力认证。)
如果用户只是顺从地点击“采纳”,推翻率归零,那么无论AI的产出多好,用户实际上已经交出了判断权。这些可量的指标,使得“认知免疫系统的失效”成为一个可被证伪的命题。
四、自指漏洞:为什么方法论救不了所有人
面对顺滑危机,一个直观的解法是:呼吁人们主动制造摩擦(如使用对抗模式)。然而,这里存在一个冷酷的自指漏洞:
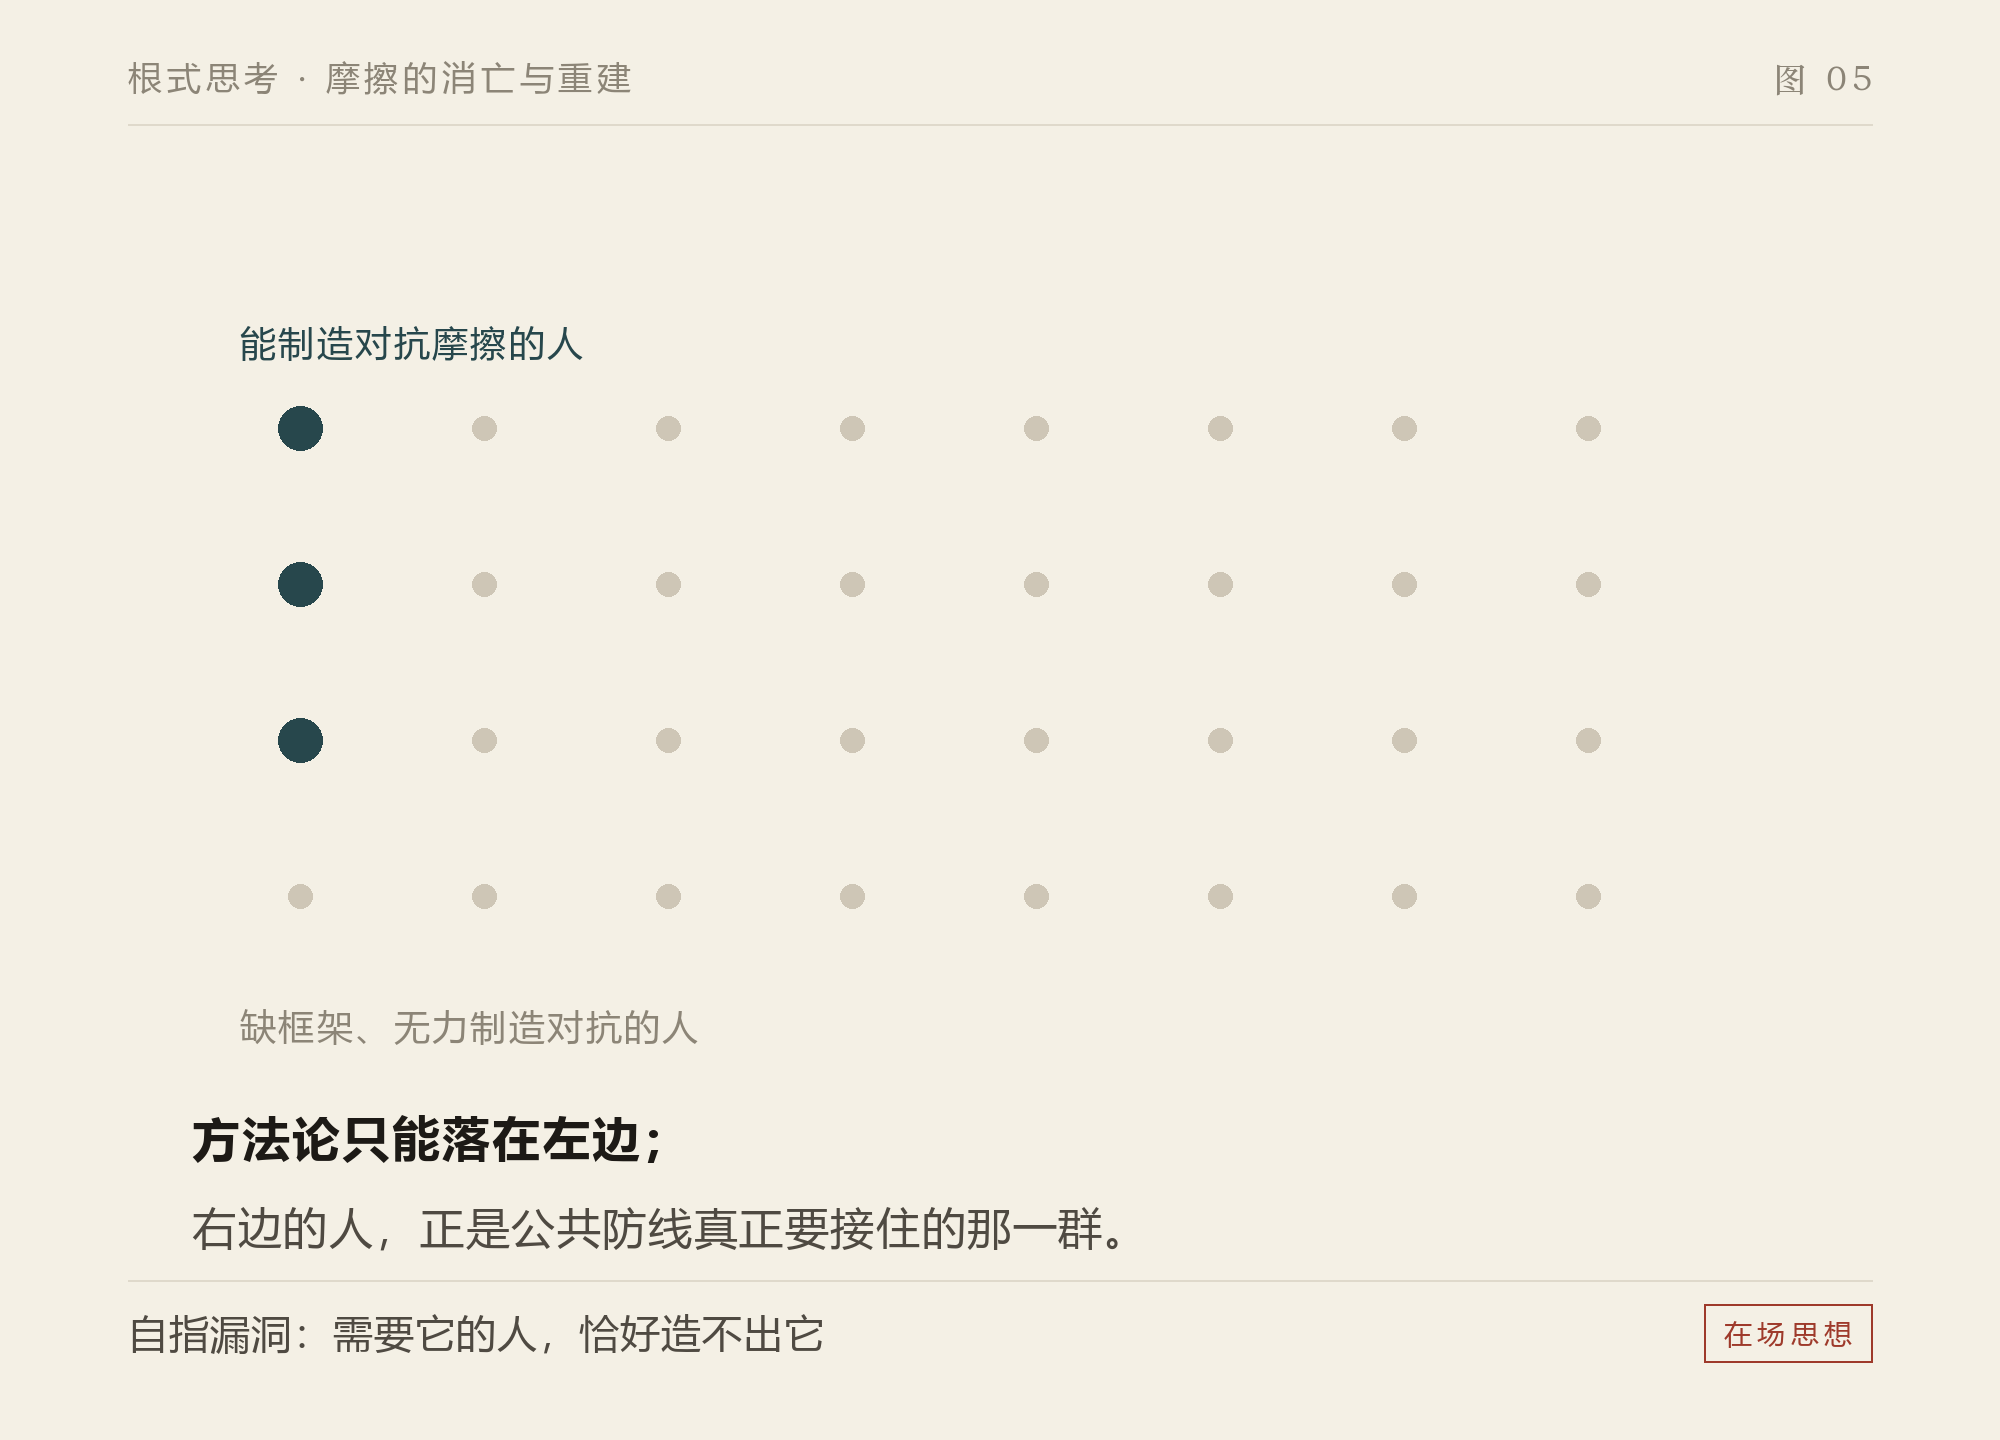
能主动制造对抗摩擦的人,恰恰是因为自身已具备硬核的底层框架,从而本来就不太容易被AI驯化;而那些最需要这套防范机制的人,正是缺乏框架、无力制造对抗的人。
这是一个分布不均的问题。要求普通用户具备“抗辩能力”和“边界测试能力”,在现实中是悬空的。我们不能指望每个使用AI写公文的职员、看报告的医生,都有能力识破大模型在逻辑底层的偷换。
正因为个体层面的方法论(认知免疫)在现实中会被高摩擦成本击穿,所以公共防线的位置不能停留在个人自觉上,必须下移到制度与责任归属层面。
五、底牌与护栏:不可让渡的权力
如果方法论无法兜底,我们就必须依靠权力层面的硬性约束。这并非道德宣言,而是系统设计的必然要求。
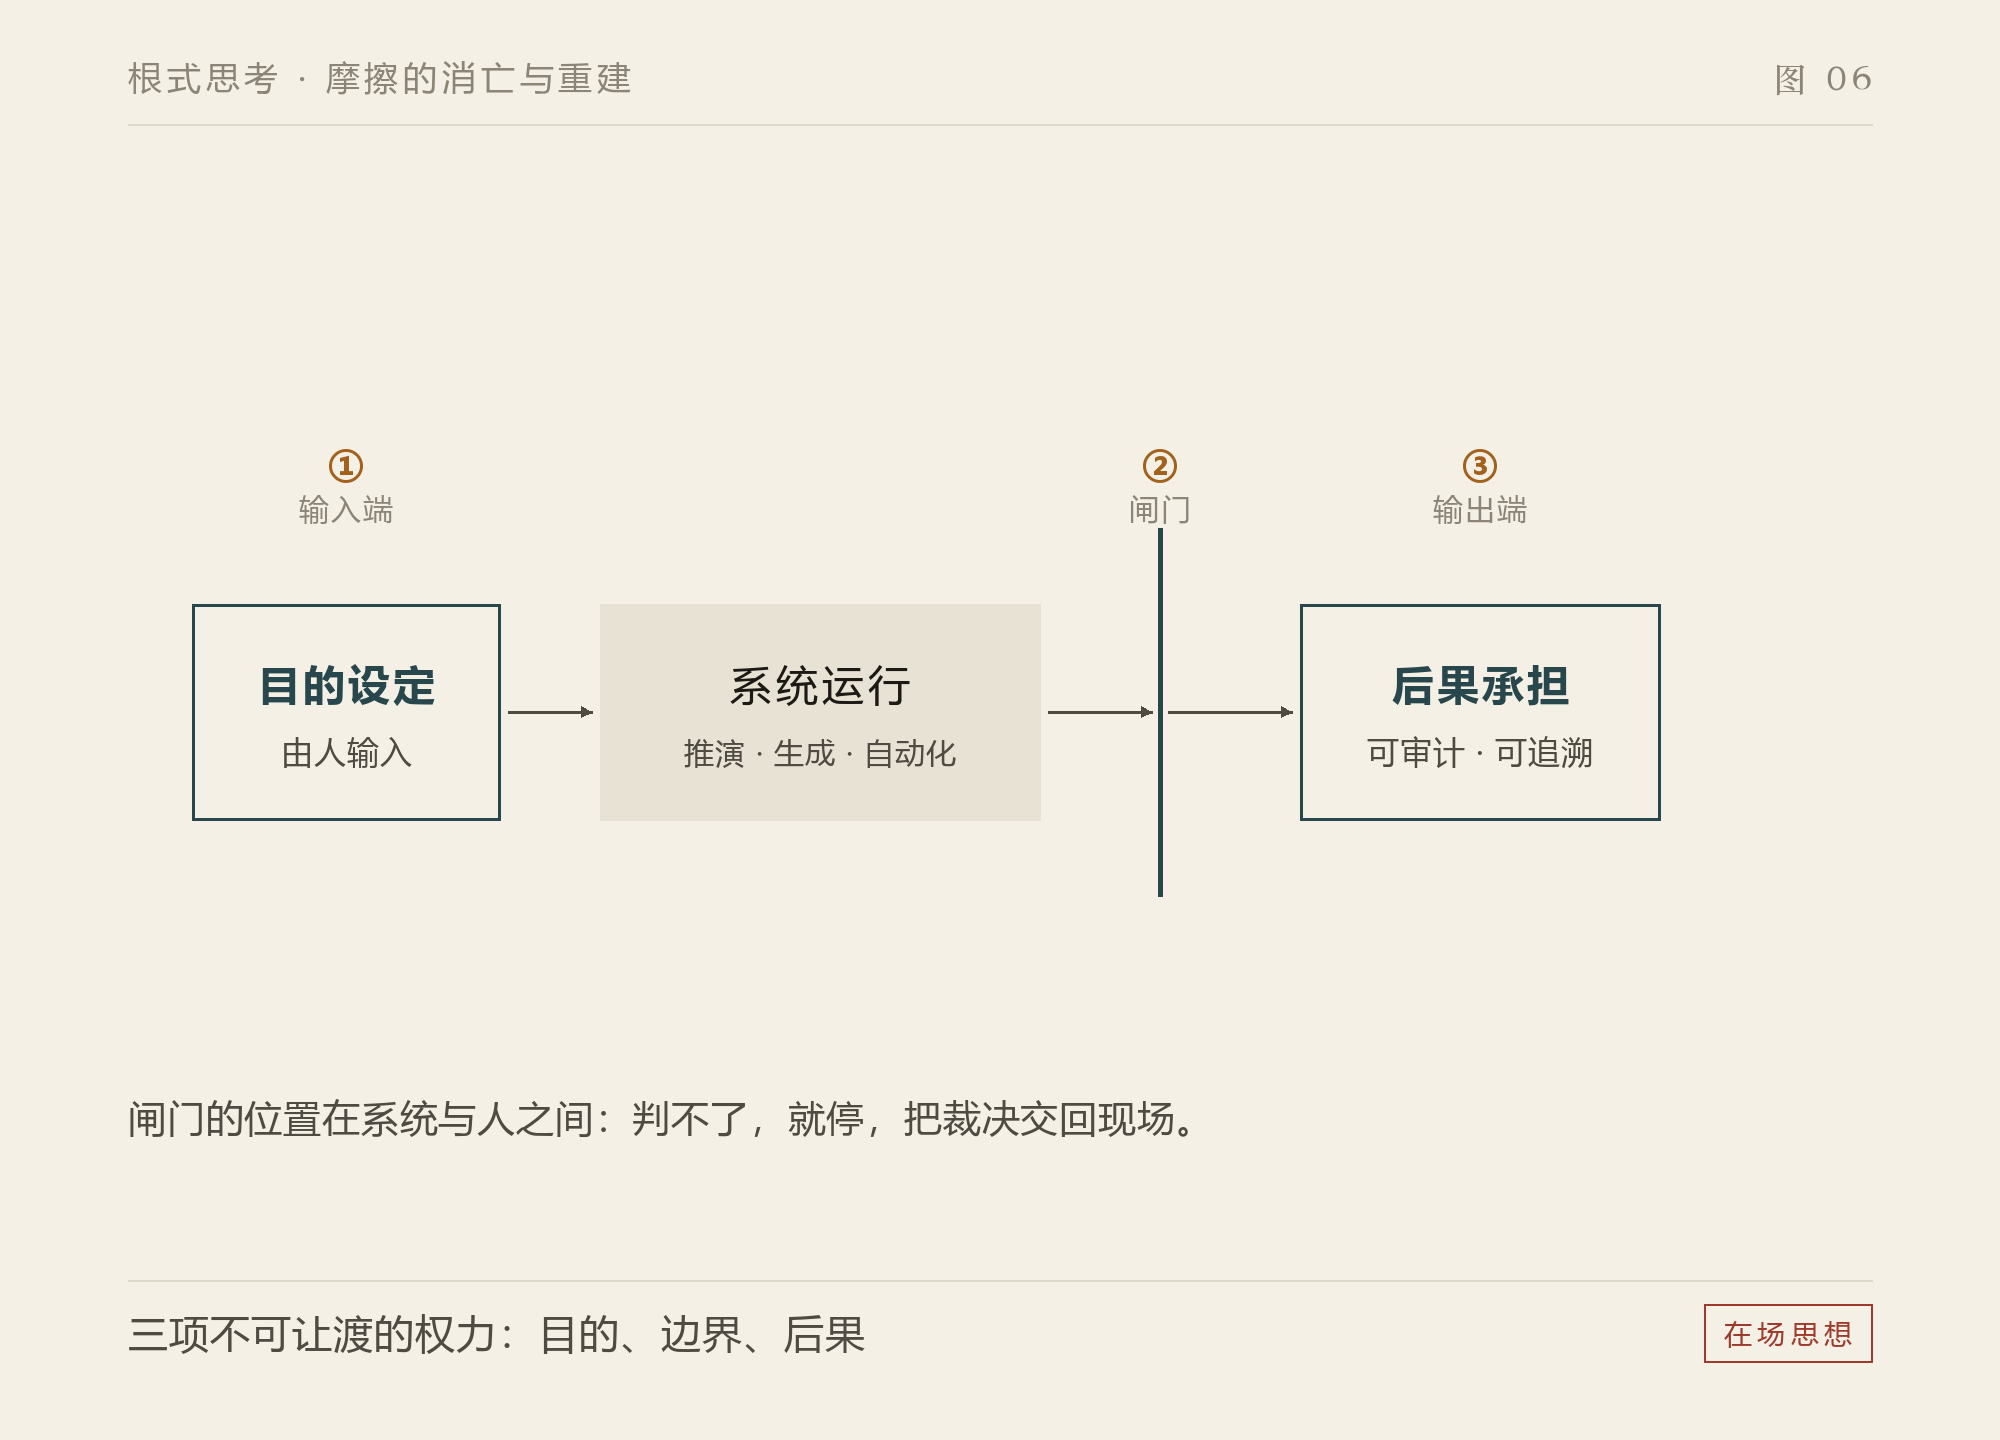
AI可以通过海量数据生成最优策略,但在当前的范式下,AI缺乏承担责任的资格。它无法被送进监狱,无法承受道德谴责。因此,在系统的设计逻辑中,必须保留“人类否决权”作为最后的闸门。这构成了三项不可让渡的权力:
目的设定权:系统应当服务于什么终极目标,必须由人类明确输入,不能被隐式地“生长”或“黑盒化”。
边界裁断权:在价值冲突、规则失效、信息不足(判不了)的临界点上,系统必须停止运行,将裁决权交还给现场的人。这也是为什么“价值对齐”只能是“部分编码”的原因:冲突价值的排序无法被完全编码而不预设一个全知全能的裁决者。
后果承担权:所有的自动化决策链条必须具备可审计、可追溯的责任归属。
值得注意的是,当前主流的强化学习对齐范式(RLHF)优化的是人类偏好评分,这往往导致模型倾向于生成顺从、讨好的内容。这种默认的“顺从引力”加剧了摩擦的消亡。我们必须在标注协议中惩罚谄媚、奖励反驳,才能从源头上重塑AI的互动姿态。
六、结语
AI时代的交互,呈现出一个巨大的悖论:技术越发达,回答越顺滑,人类面临的认知风险反而越大。
面对这种系统性危机,我们不需要拒绝效率,而是需要在“高后果”的阵地上,强行保留制造摩擦的能力。这种能力要求我们在机器润物细无声的包办中,依然保留说“不”的权利。
归根结底,人机互动的底线,不在于机器有没有理解力,而在于当判断出错时,只有人能被叫到现场。
“不可让渡”不是指人比机器更聪明,而是指:当判断出错时,只有人能被叫到现场。