「不必相信我」是个什么工程问题——关于可核性边界的说明
会话「对话」· 单条回答 · 导出自 根式思考台 · 2026/11/5 20:55:39 · 完整对话请用顶栏「⬇ 导出」
〇、这篇文章要解决的疑问
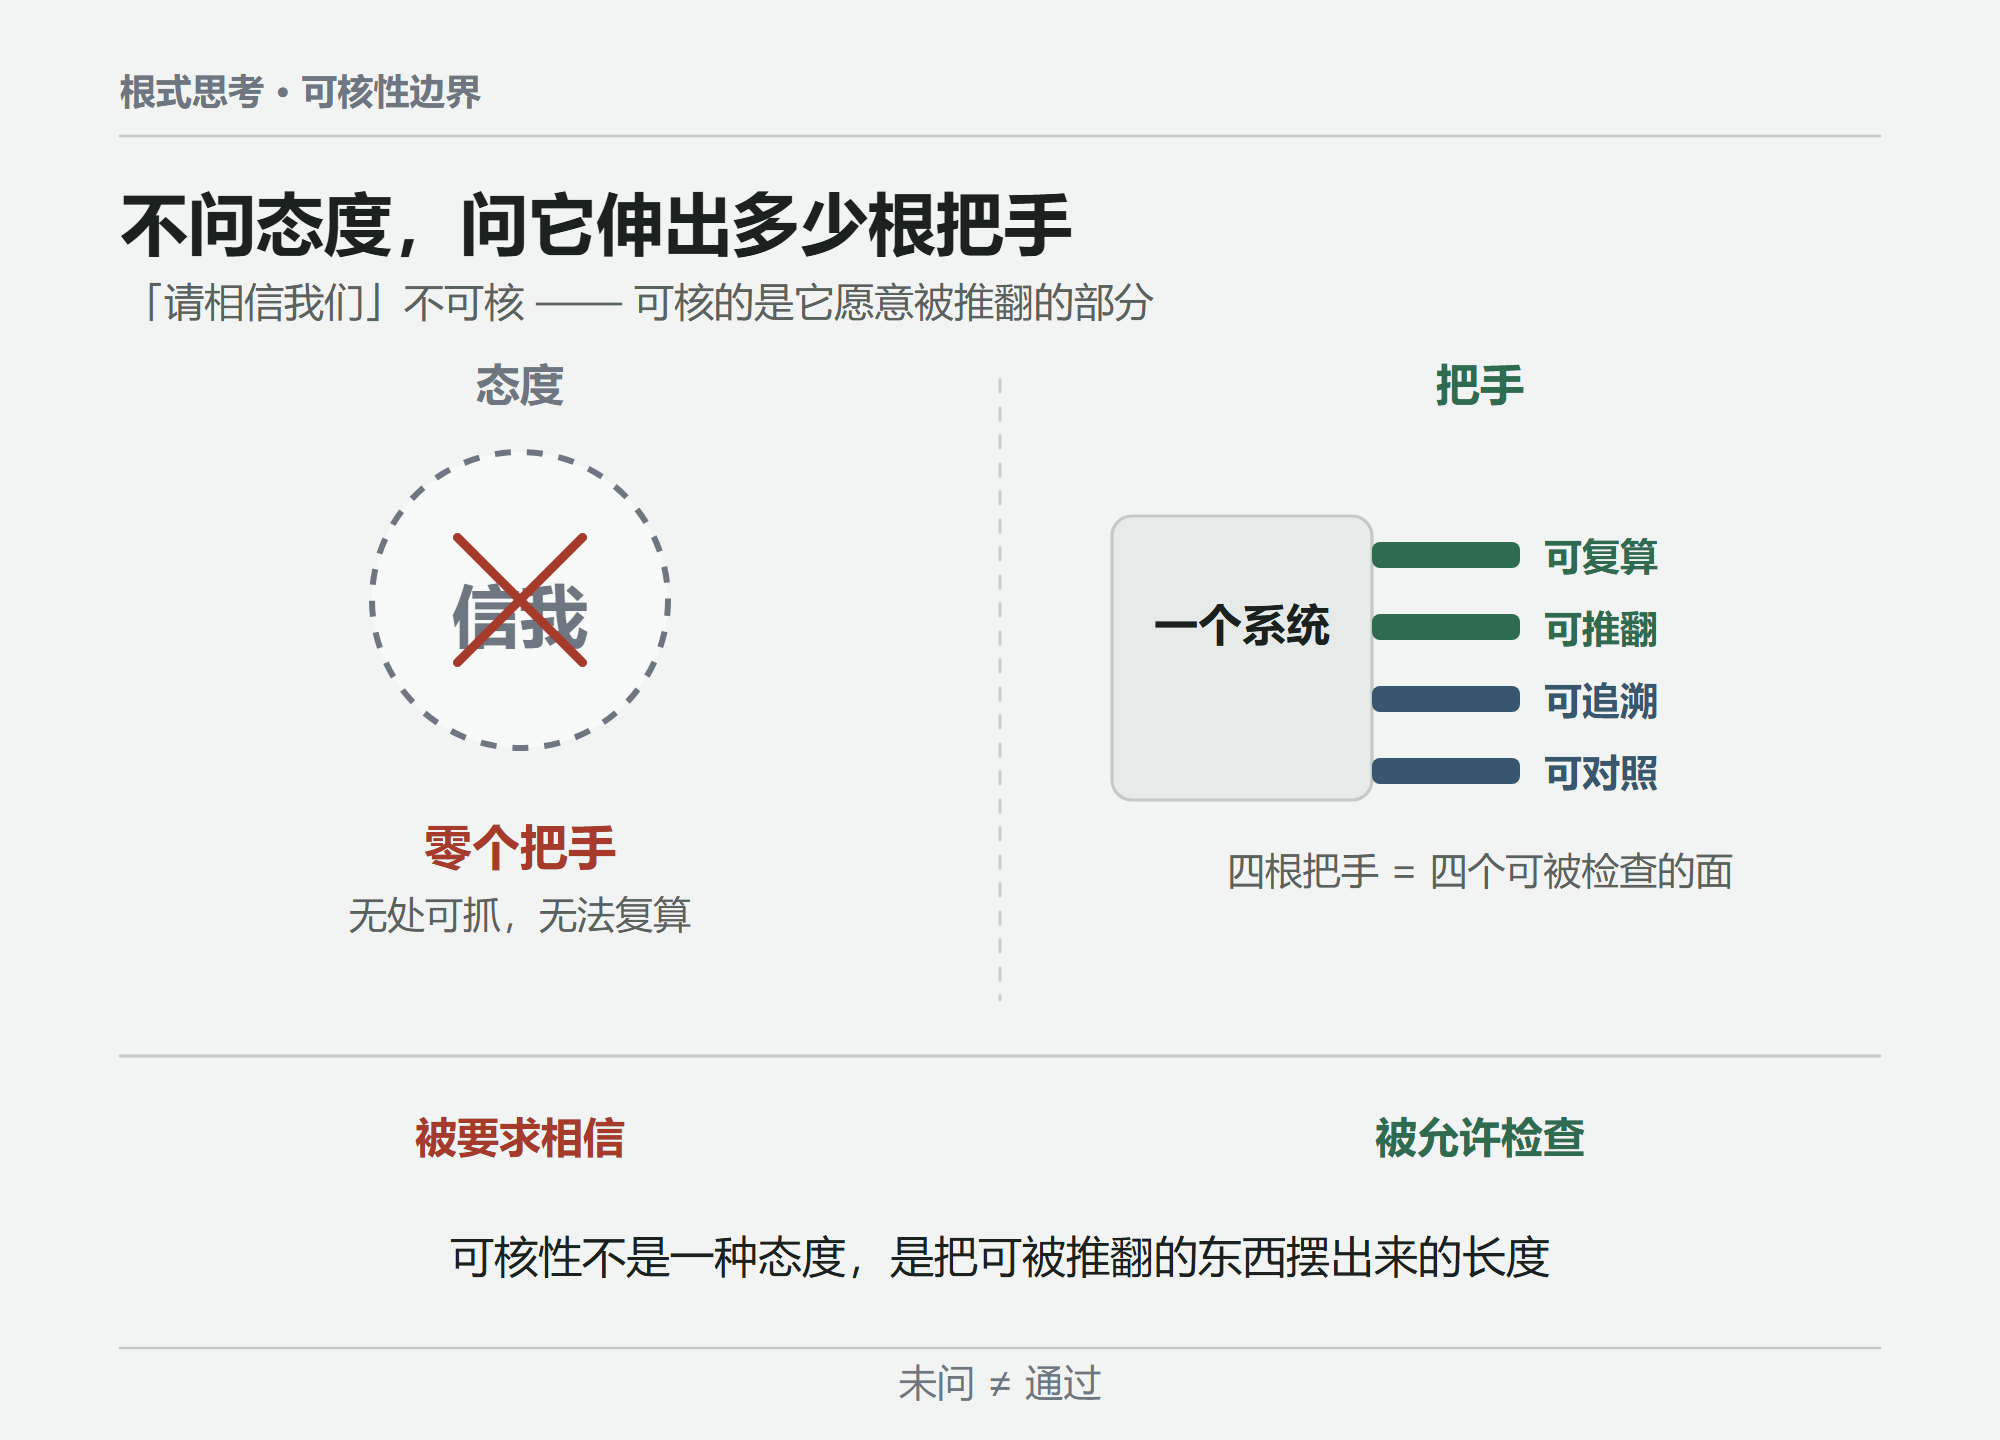
如果你常年做技术判断,看到「请相信我们」这四个字的第一反应大概是:这句话本身不可能被核。
那问题就变成了:一个声称「你不必相信我」的东西,该怎么验证它没有在骗你?
答案是:不能靠它的态度,只能靠它把可被推翻的东西暴露到什么程度。 下面是我把一个仓库拆开给你看的结果,包括它做不到的那些事。
一、先说一次失败,它解释了整个设计
一个 HTML 页面:拖入文件,本地算 SHA-256,和文件自带的声称值比对。算法全在页面里,纯 JS,无依赖,无压缩。
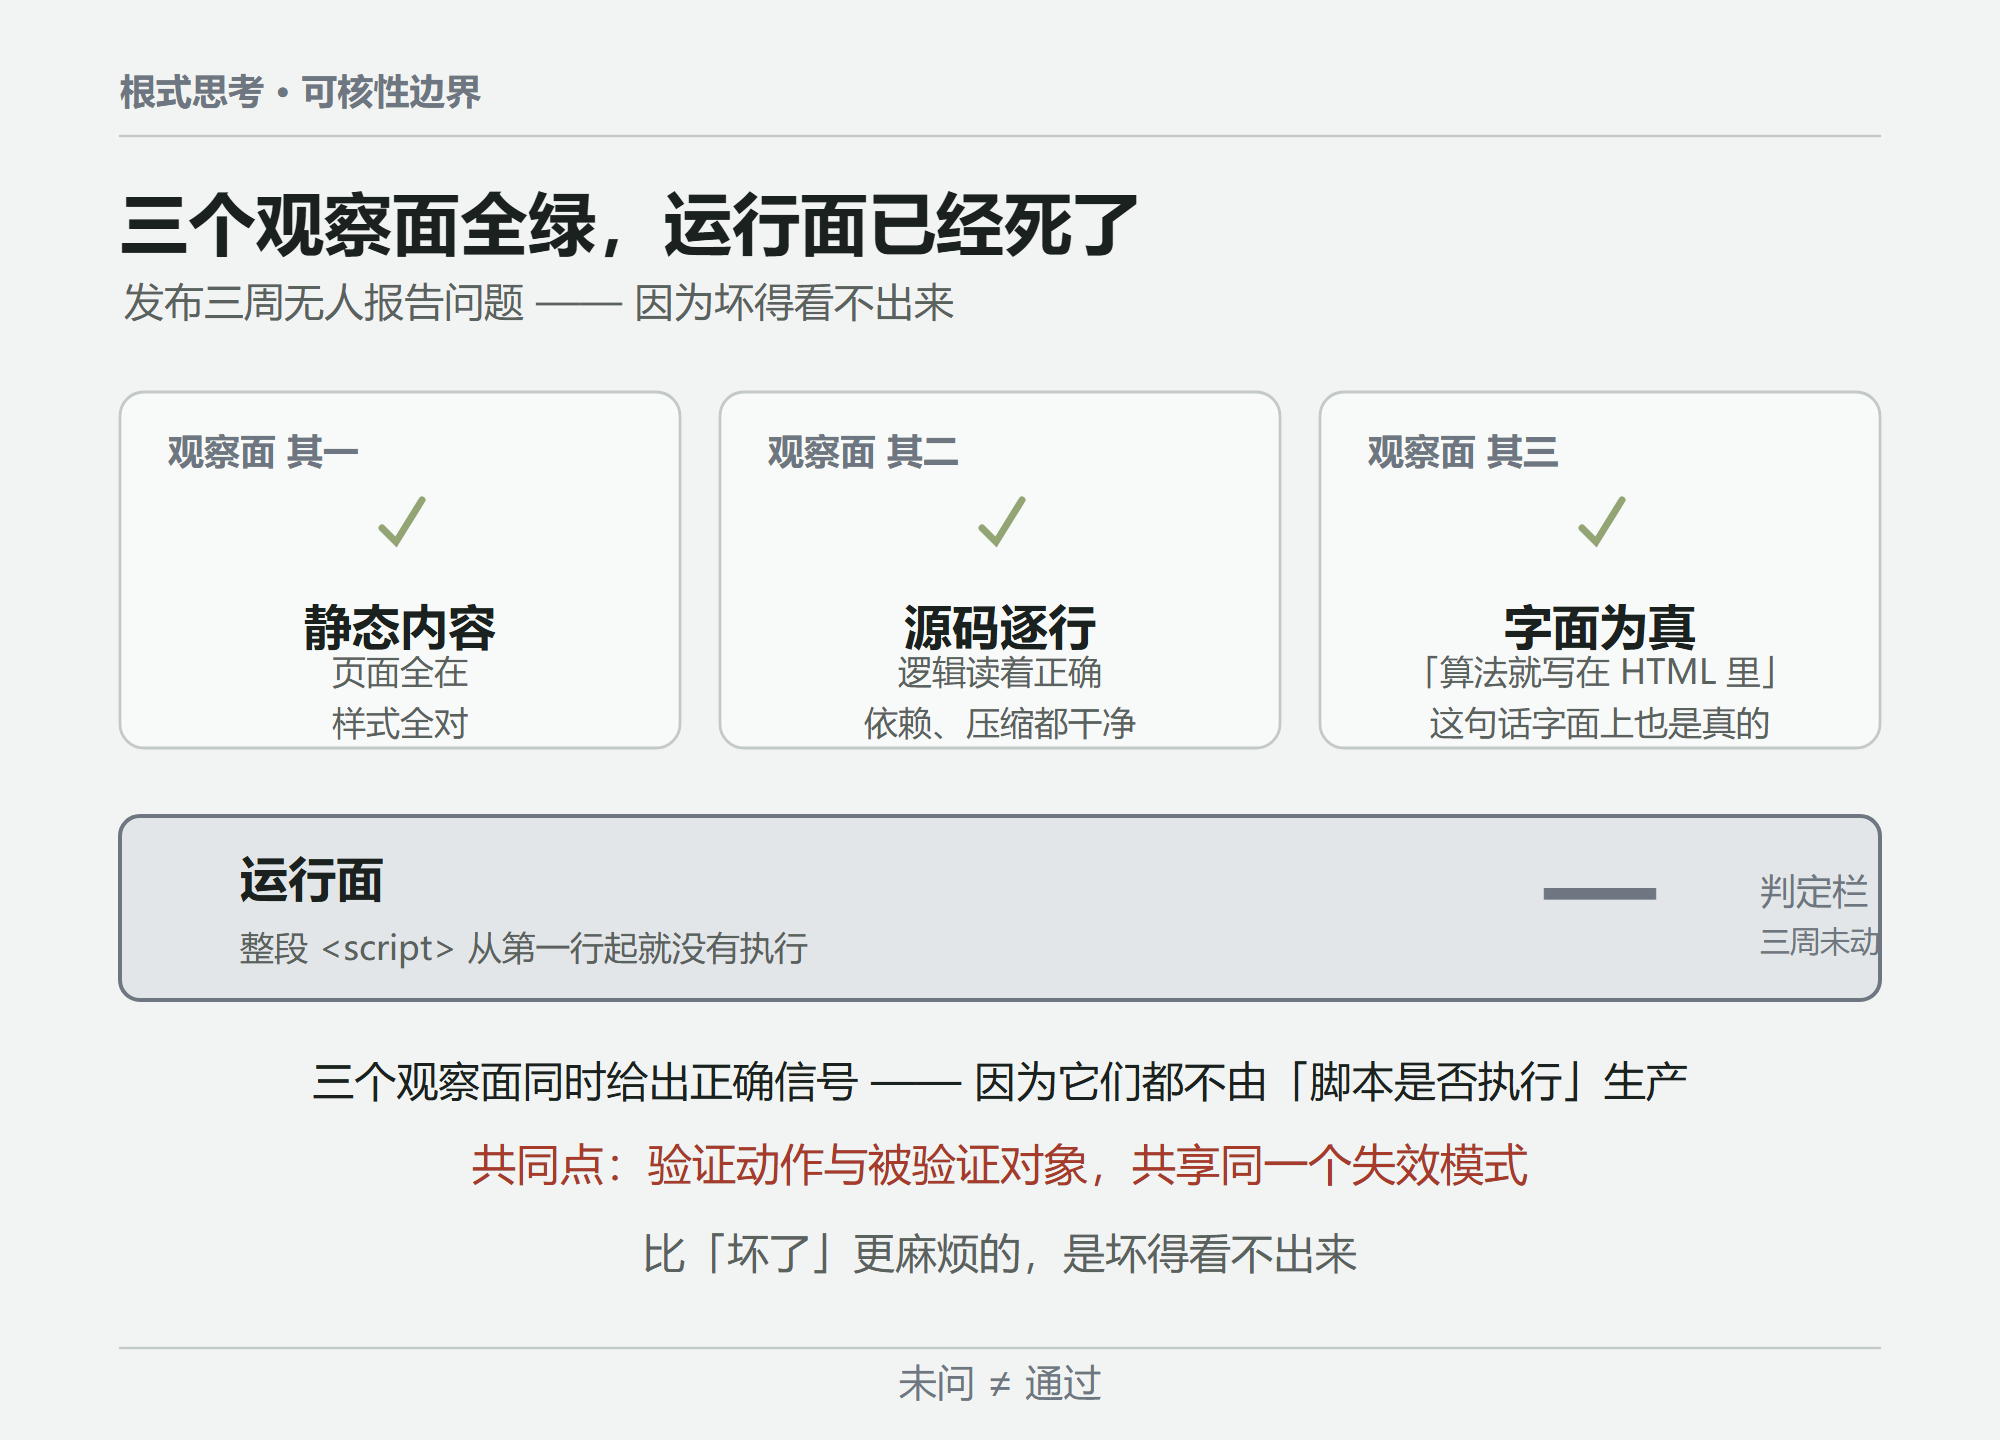
发布三周,无人报告问题。
后来有人真去用了,结果是:什么也没发生。
判定栏一直是「—」。没有报错,因为整段 <script> 从第一行起就没有执行:一句注释里的中文引号落在了双引号字符串内部,造成语法错误。
这里值得停一下:故障机制并不高级,高级的是它的不可见性。
· 静态内容全在、样式全对;
· 源码逐行读,逻辑正确;
· 「算法就写在 HTML 里」这句话,字面上也是真的。
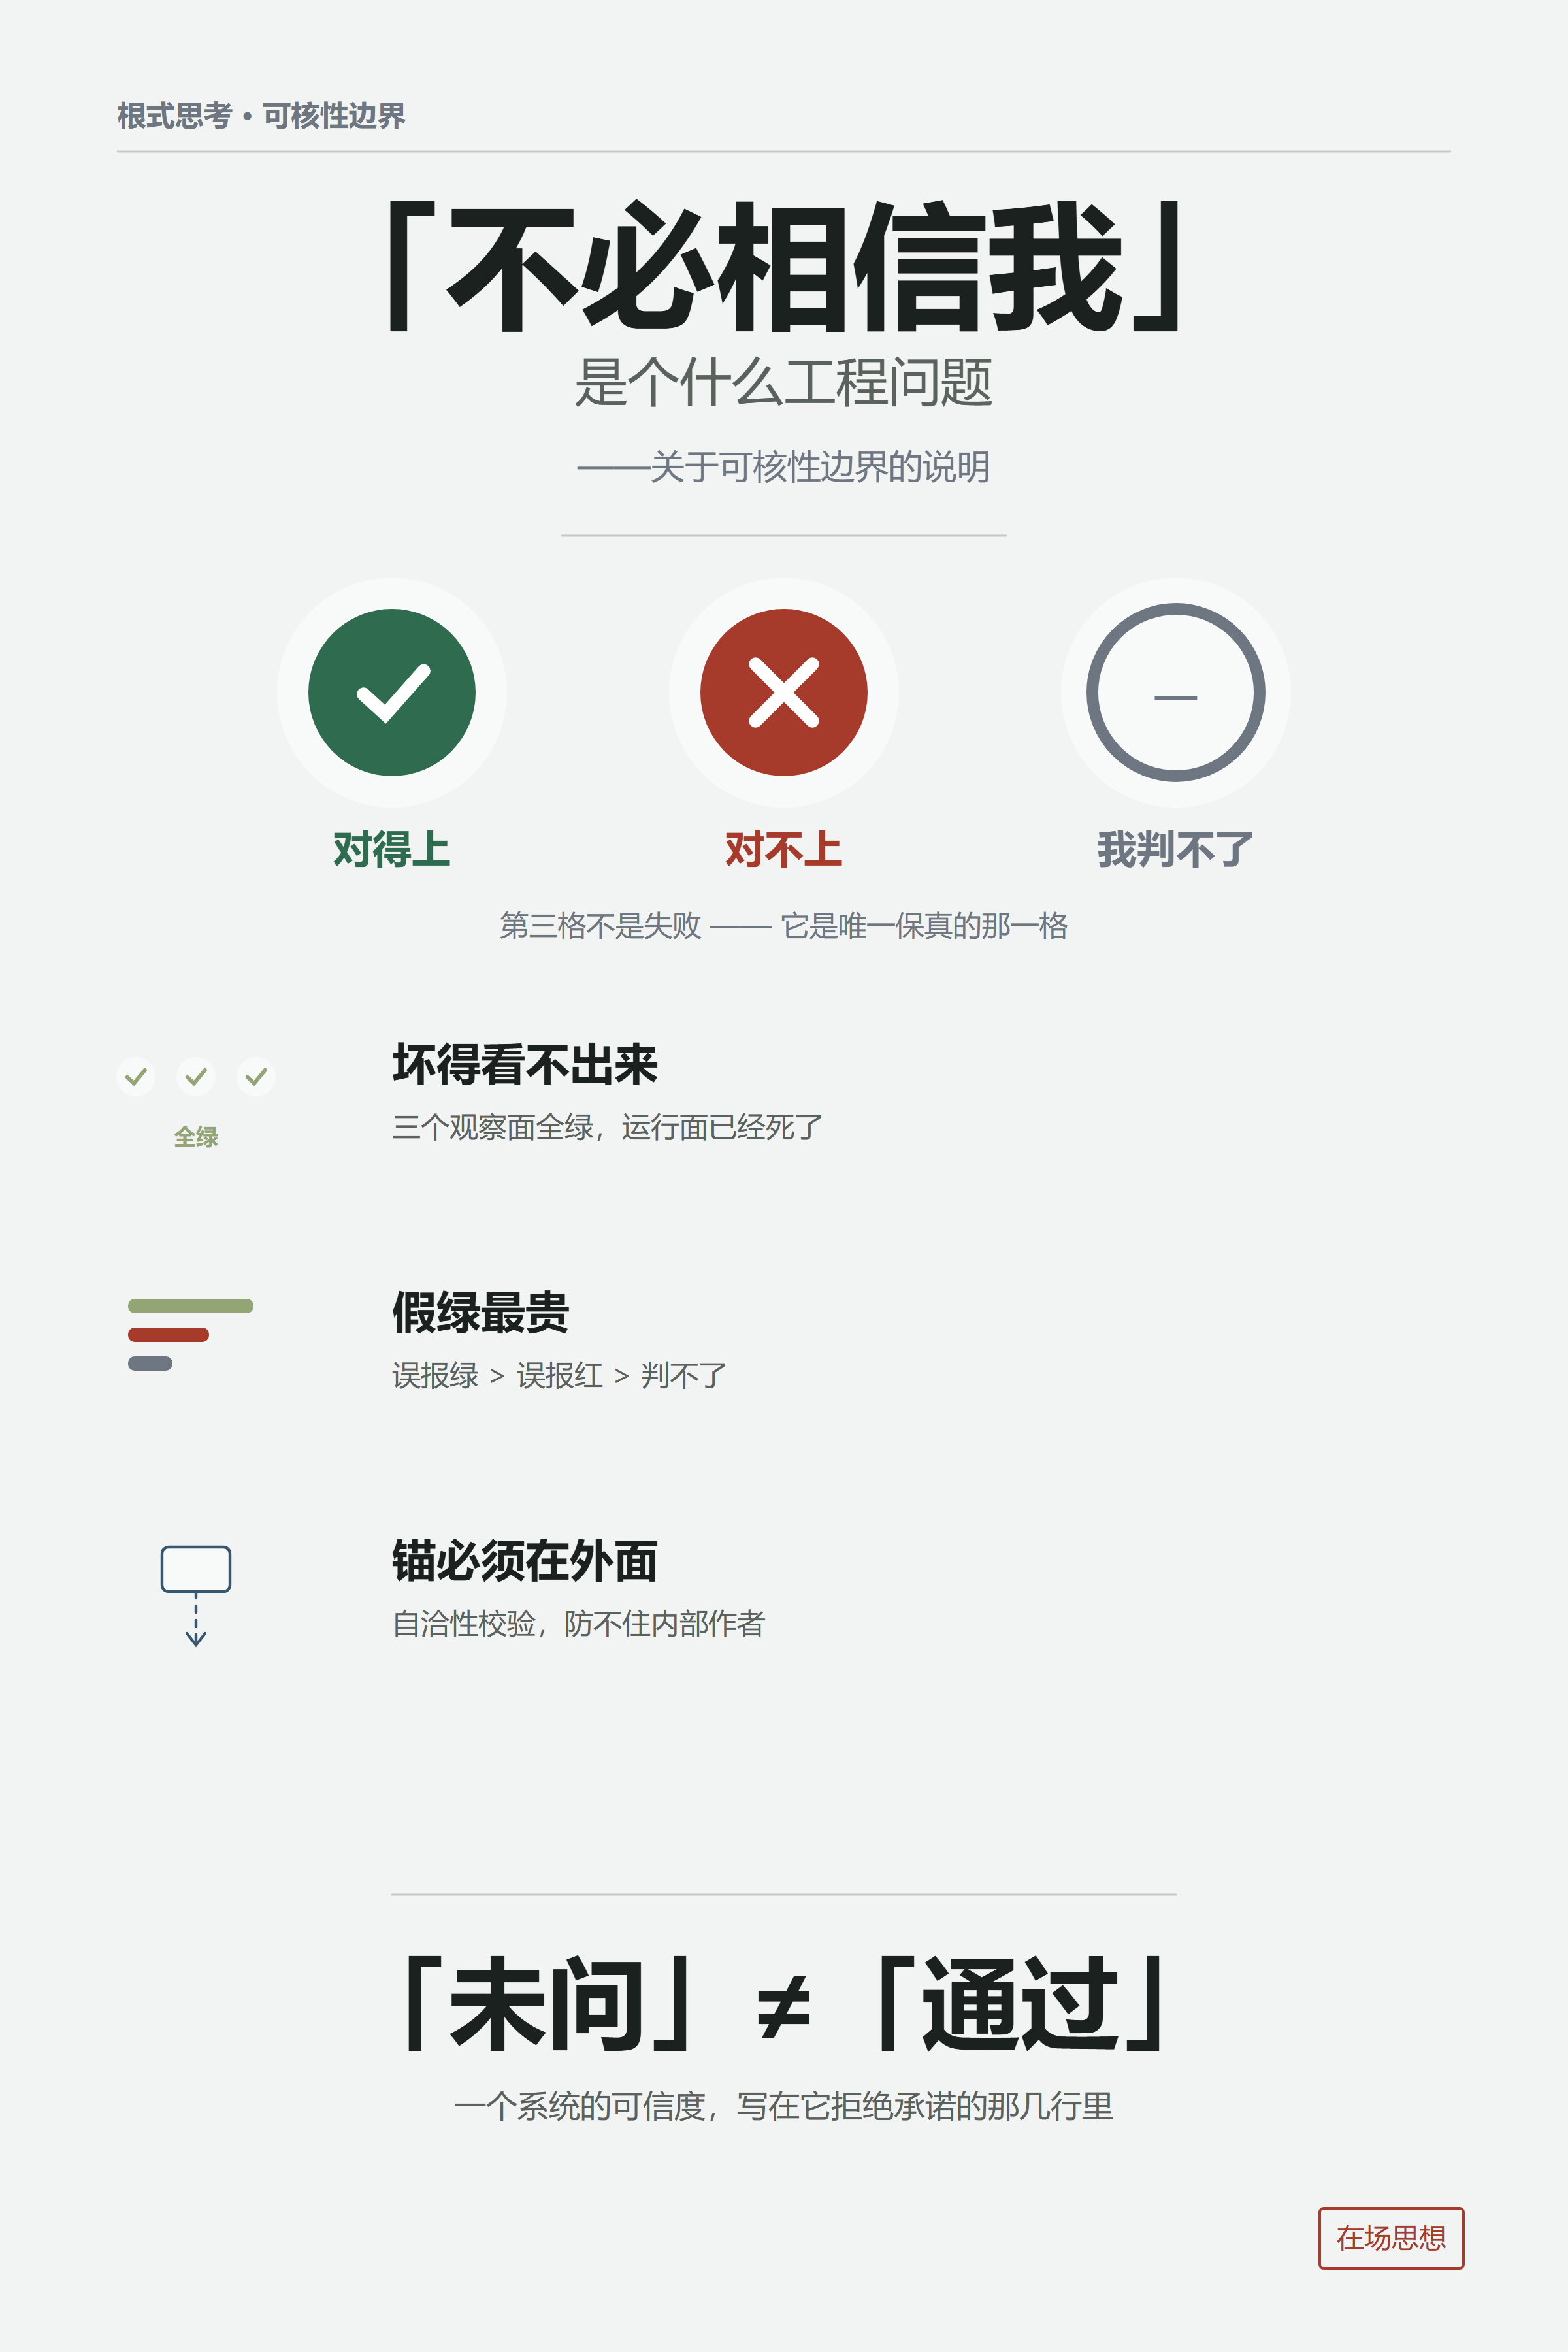
三个观察面同时给出正确信号,而运行面已经死了。
这就是我认为的现代基础设施的核心风险,比「坏了」更麻烦:坏得看不出来。同构的例子你大概率见过:备份没恢复过,日志没人读,判据全绿而实现没接上。共同点是:验证动作与被验证对象共享同一个失效模式。
二、这个仓库做的最小一件事
判断:这份文件,与它自带的那个指纹值,是不是同一份。
限定条件必须一次说清,它们不是免责,而是边界:
| 它能 | 它不能 |
|---|---|
| 证明「字与签名对得上」 | 证明「话说得对」 |
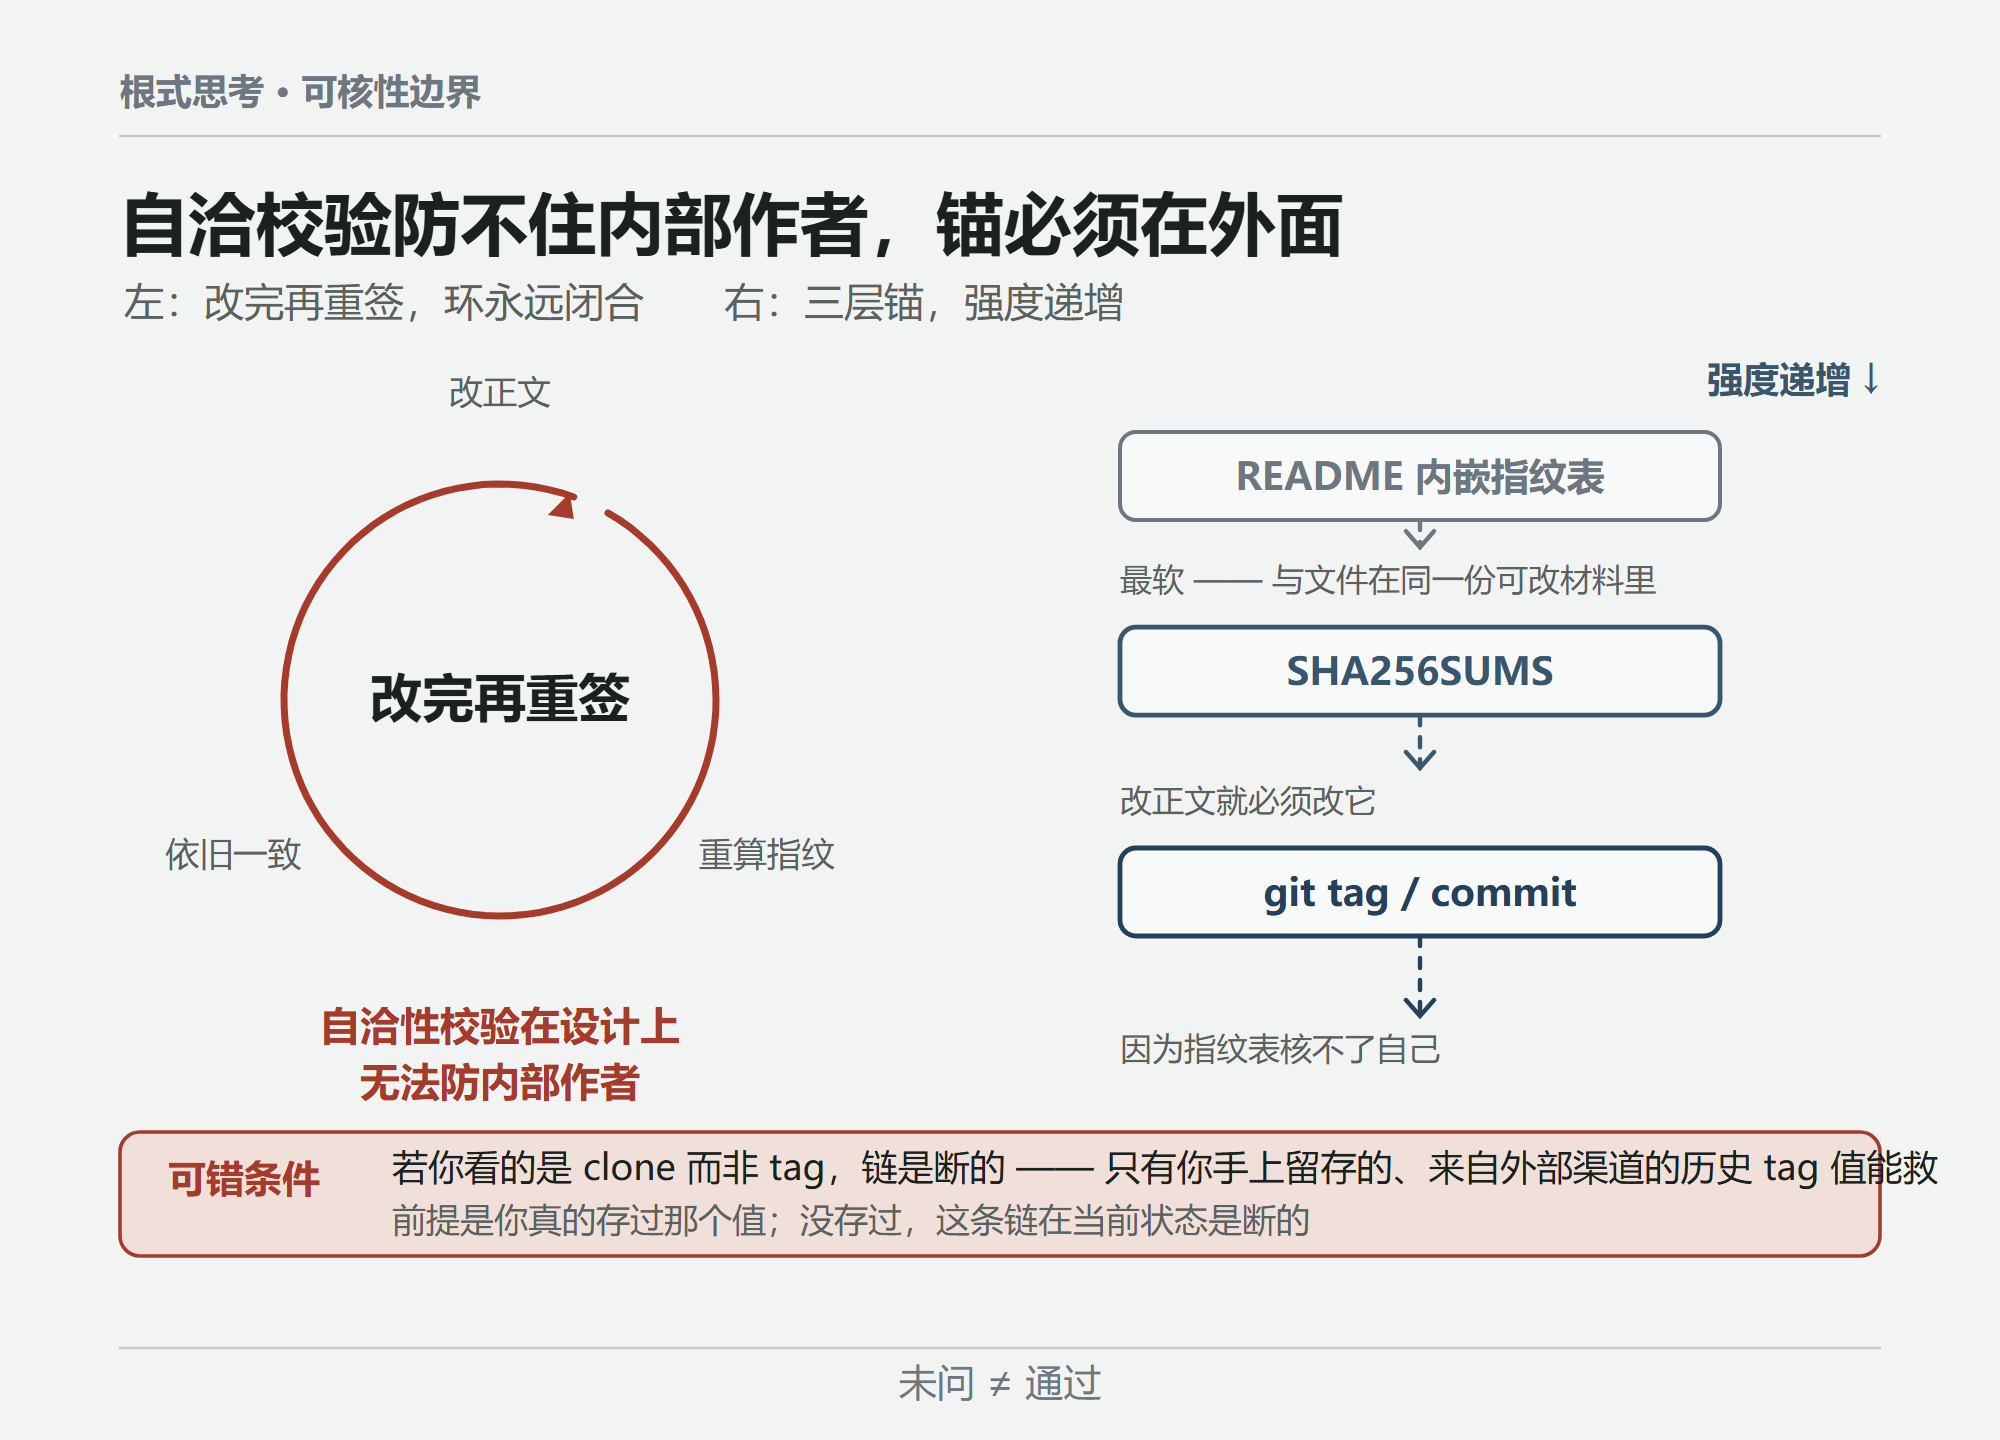
| 当场给出可复算的 PASS / FAIL | 证明「没被改过」——指纹内嵌在被校验的同一份文件里,改正文→重算→改写指纹行,照样一致 |
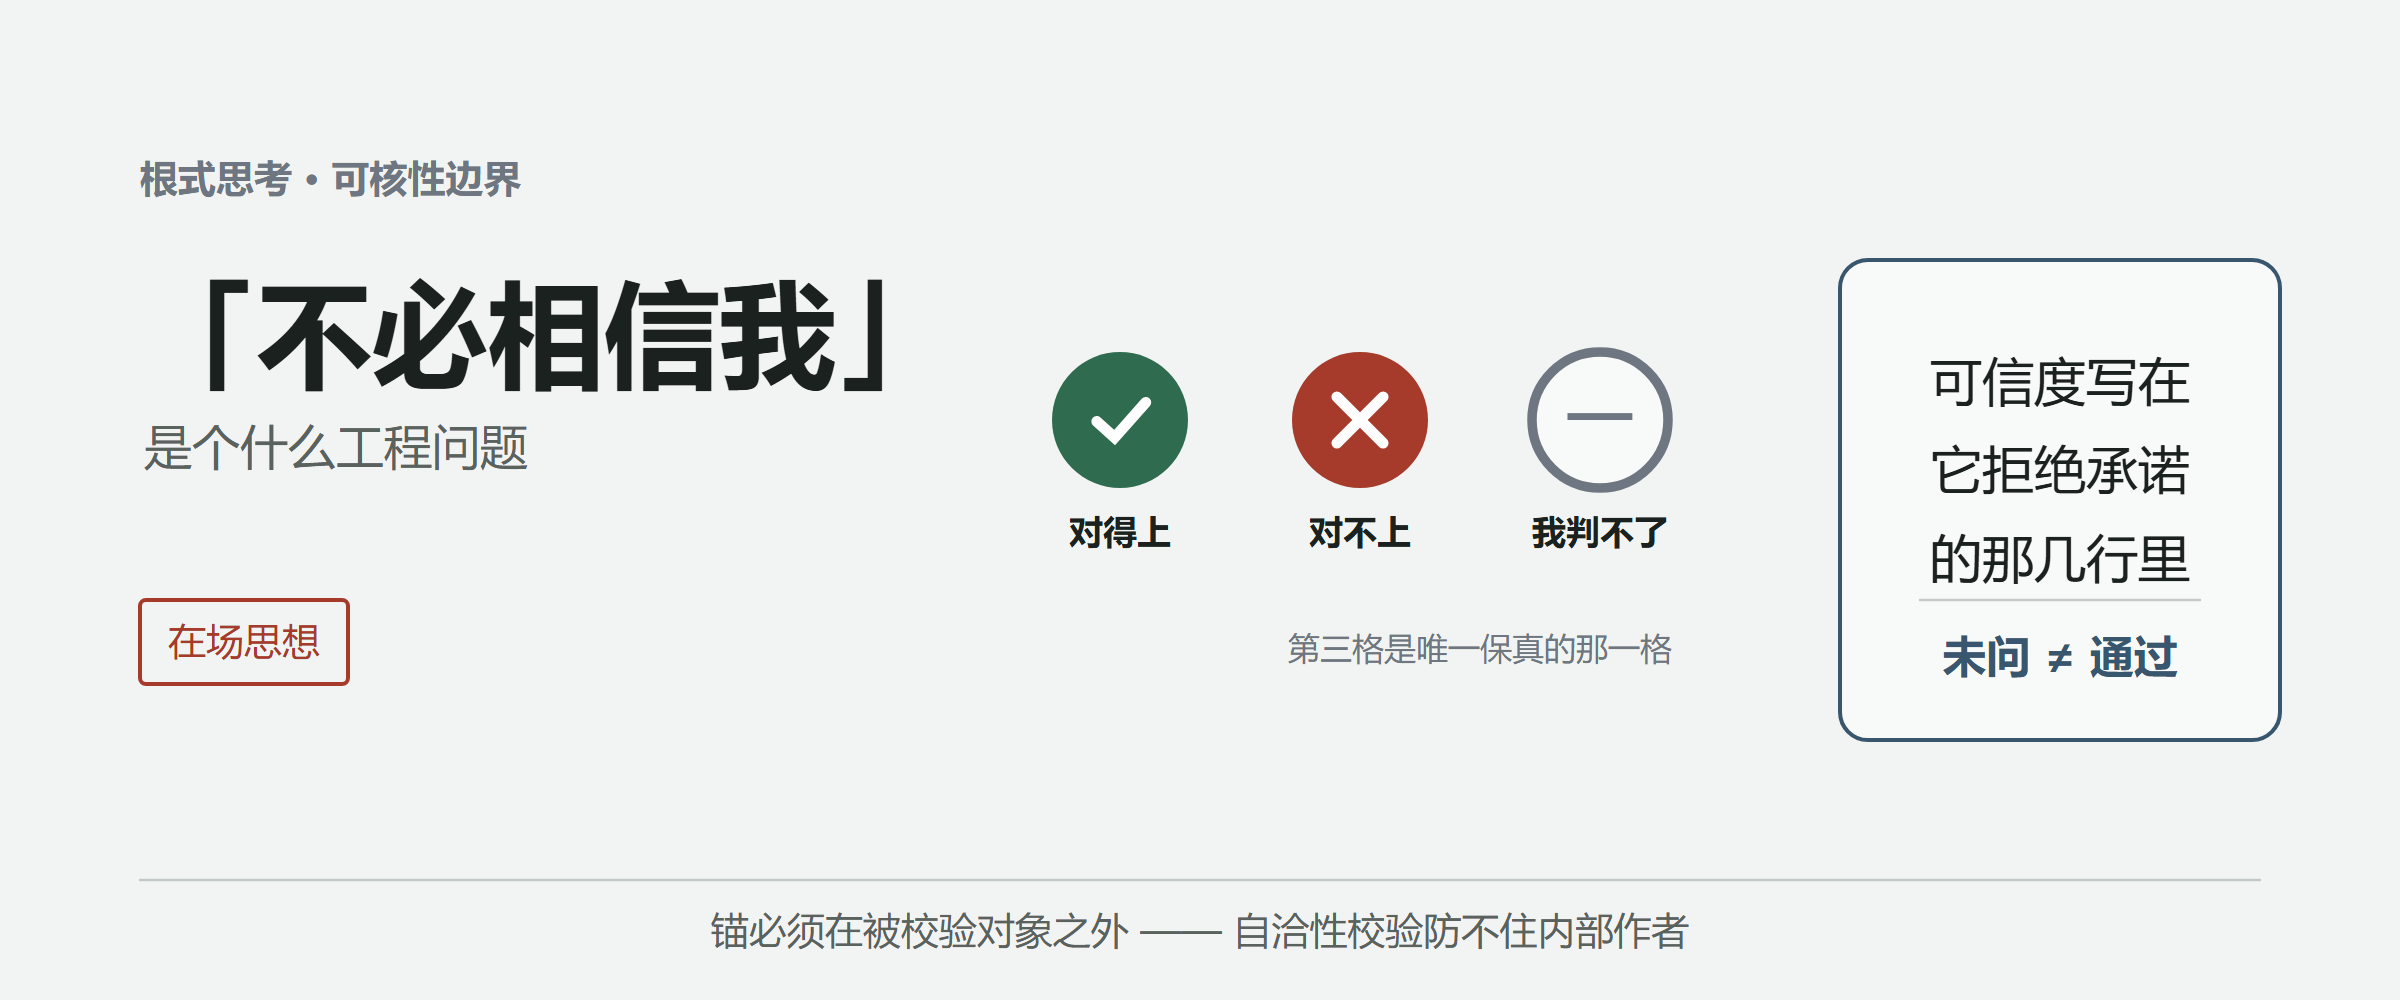
第二条是很多人第一眼会漏的。自洽性校验在设计上无法防内部作者,要防「改完再重签」,锚必须放在被校验对象之外。
仓库里放了三层锚,强度递增:
1.README 内嵌的指纹表 —— 最软,它和文件在同一份可被同时改动的材料里;
2.SHA256SUMS(整文件 64 位哈希) —— 改正文就必须改它;
3.git tag / commit 哈希 —— 因为 SHA256SUMS 核不了自己。
可错条件: 若你看的是一次 clone 而非 tag,第三层锚就退化了 —— 攻击者可以同时改 SHA256SUMS 和提交,此时只有你手上留存的、来自外部渠道(邮件、另一块盘、纸面)的历史 tag 值能救。我判这在实际威胁模型里是够的,但前提是你真的存过那个值;若你没存过,这条链在当前状态是断的。
三、三态为什么是一个工程决定,不是措辞讲究
大多数校验工具只有两态。这个仓库坚持三态:
| 情形 | 结论 |
|---|---|
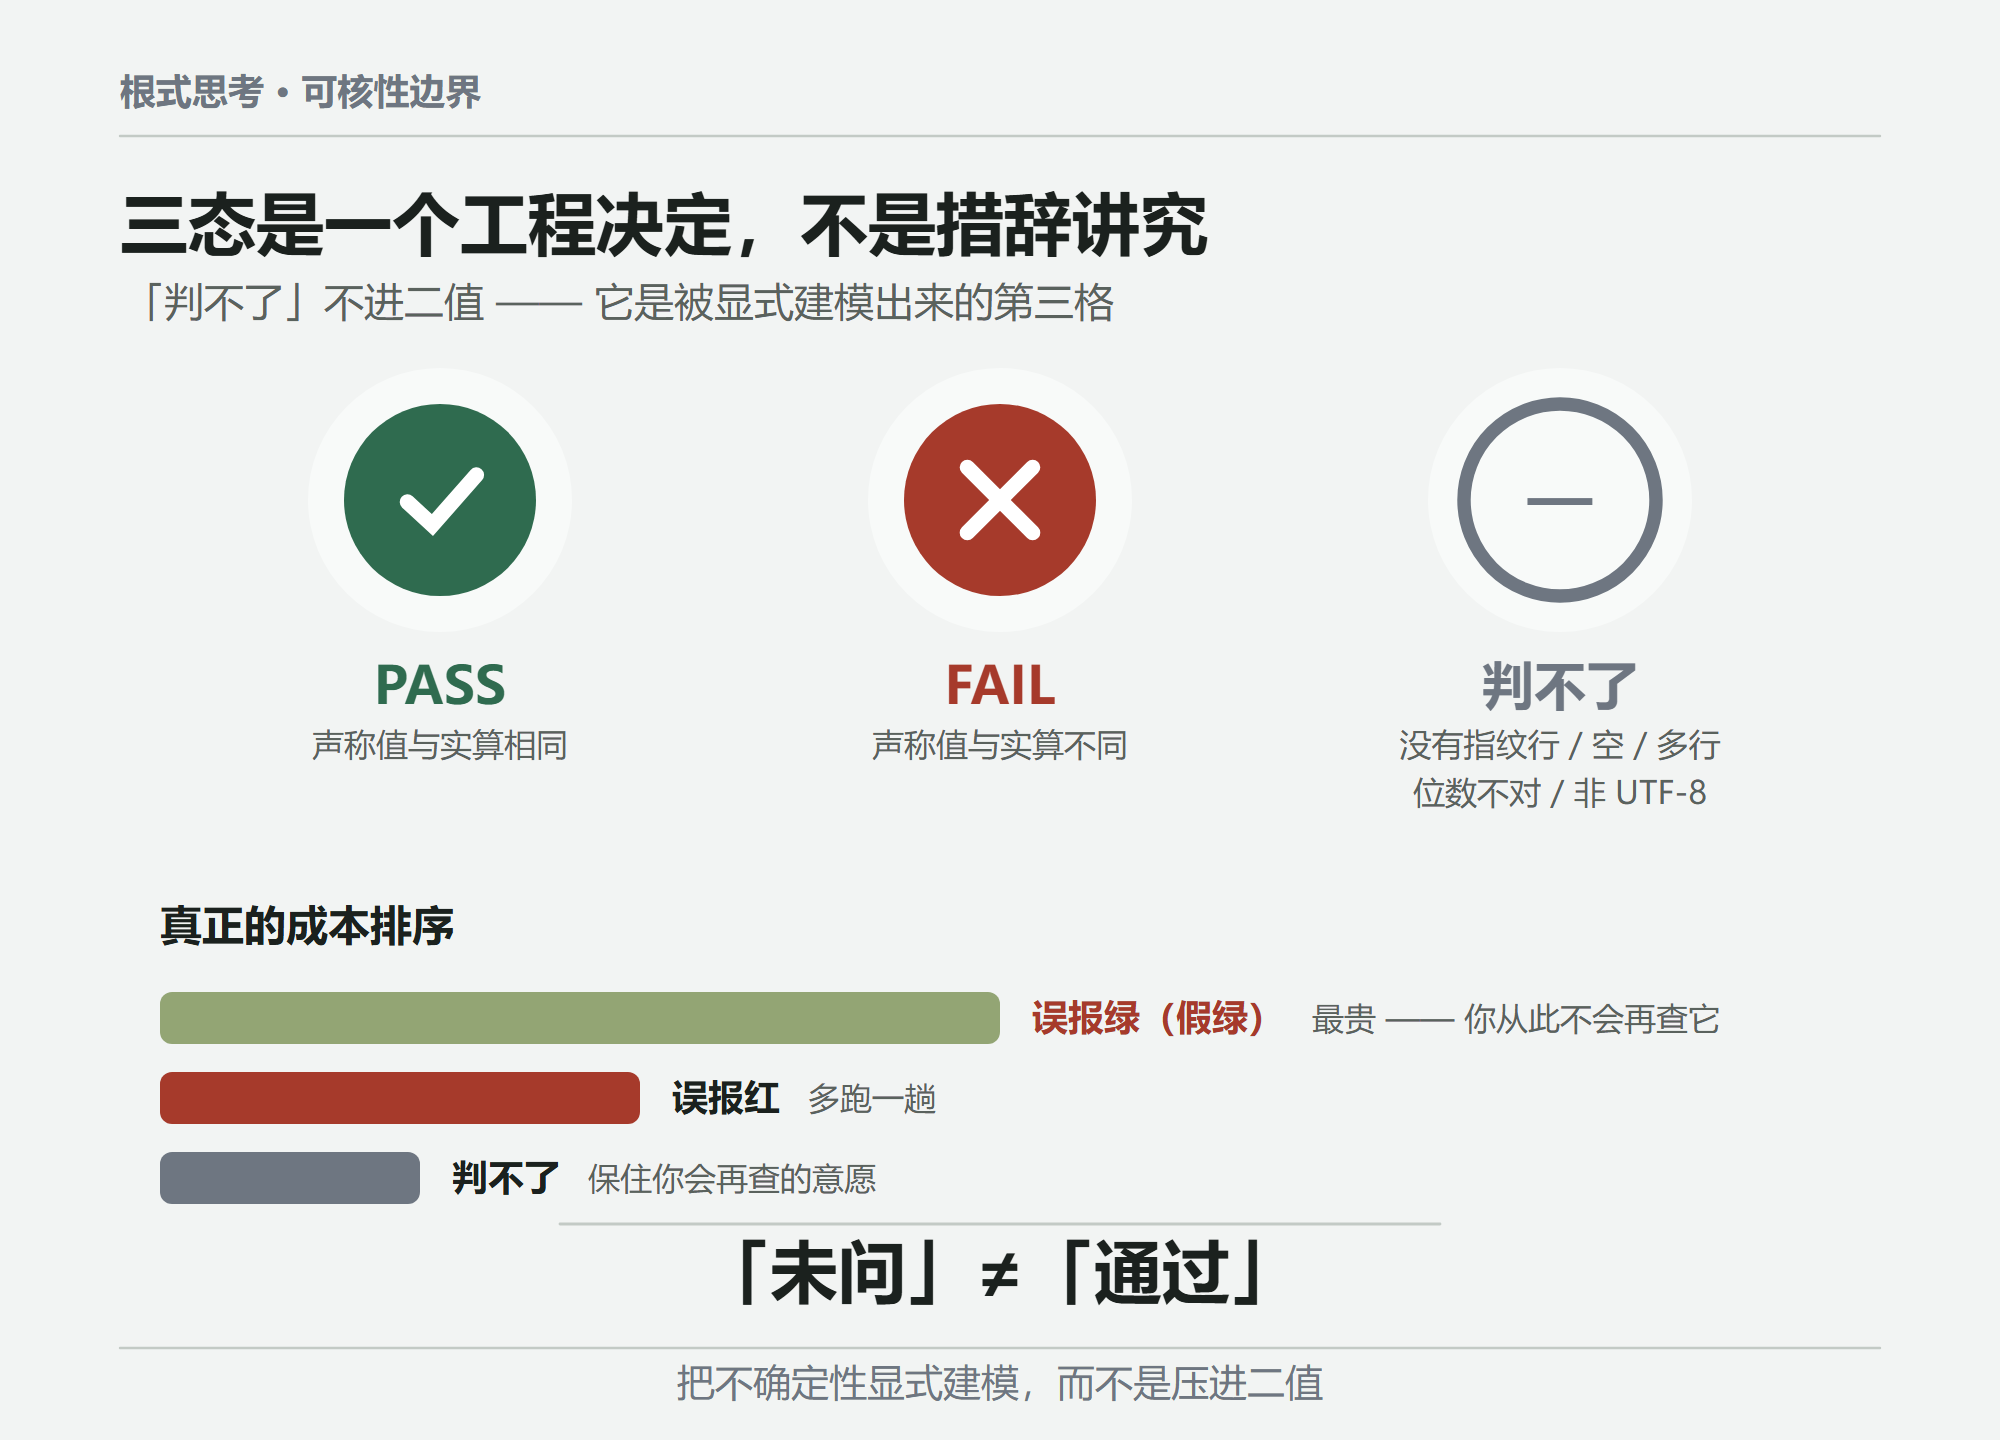
| 声称值 16 位十六进制,与实算相同 | PASS |
| 声称值 16 位十六进制,与实算不同 | FAIL |
| 没有「报告指纹」行 / 值为空 / 多行 / 位数不对 / 非 UTF-8 | 判不了 |
第一版正好做错了:8 位值、64 位值、两行指纹,一律判 FAIL,还附一句「不得把它当作凭证使用」。
那是拿工具的规格去判文件的罪。 文件名该叫 uncomputable,而不是 invalid。
另一头更贵:一份没查的报告显示「通过」,你从此就不会再查它了。 所以真正的成本排序是:
误报绿 > 误报红 > 判不了。
贵的是「假绿」;而「判不了」虽然让人多跑一趟,但它保住了你「还会再去查」的意愿。这是把不确定性显式建模,而不是把它压缩进二值里。
对应一句我认为可以直接迁移到任何判据设计的原则:
「未问」≠「通过」。
四、两个案例,讲的是同一件事:验证方的独立性
仓库里有两份事故复盘,都取自有案号、有署名的第三方文书。
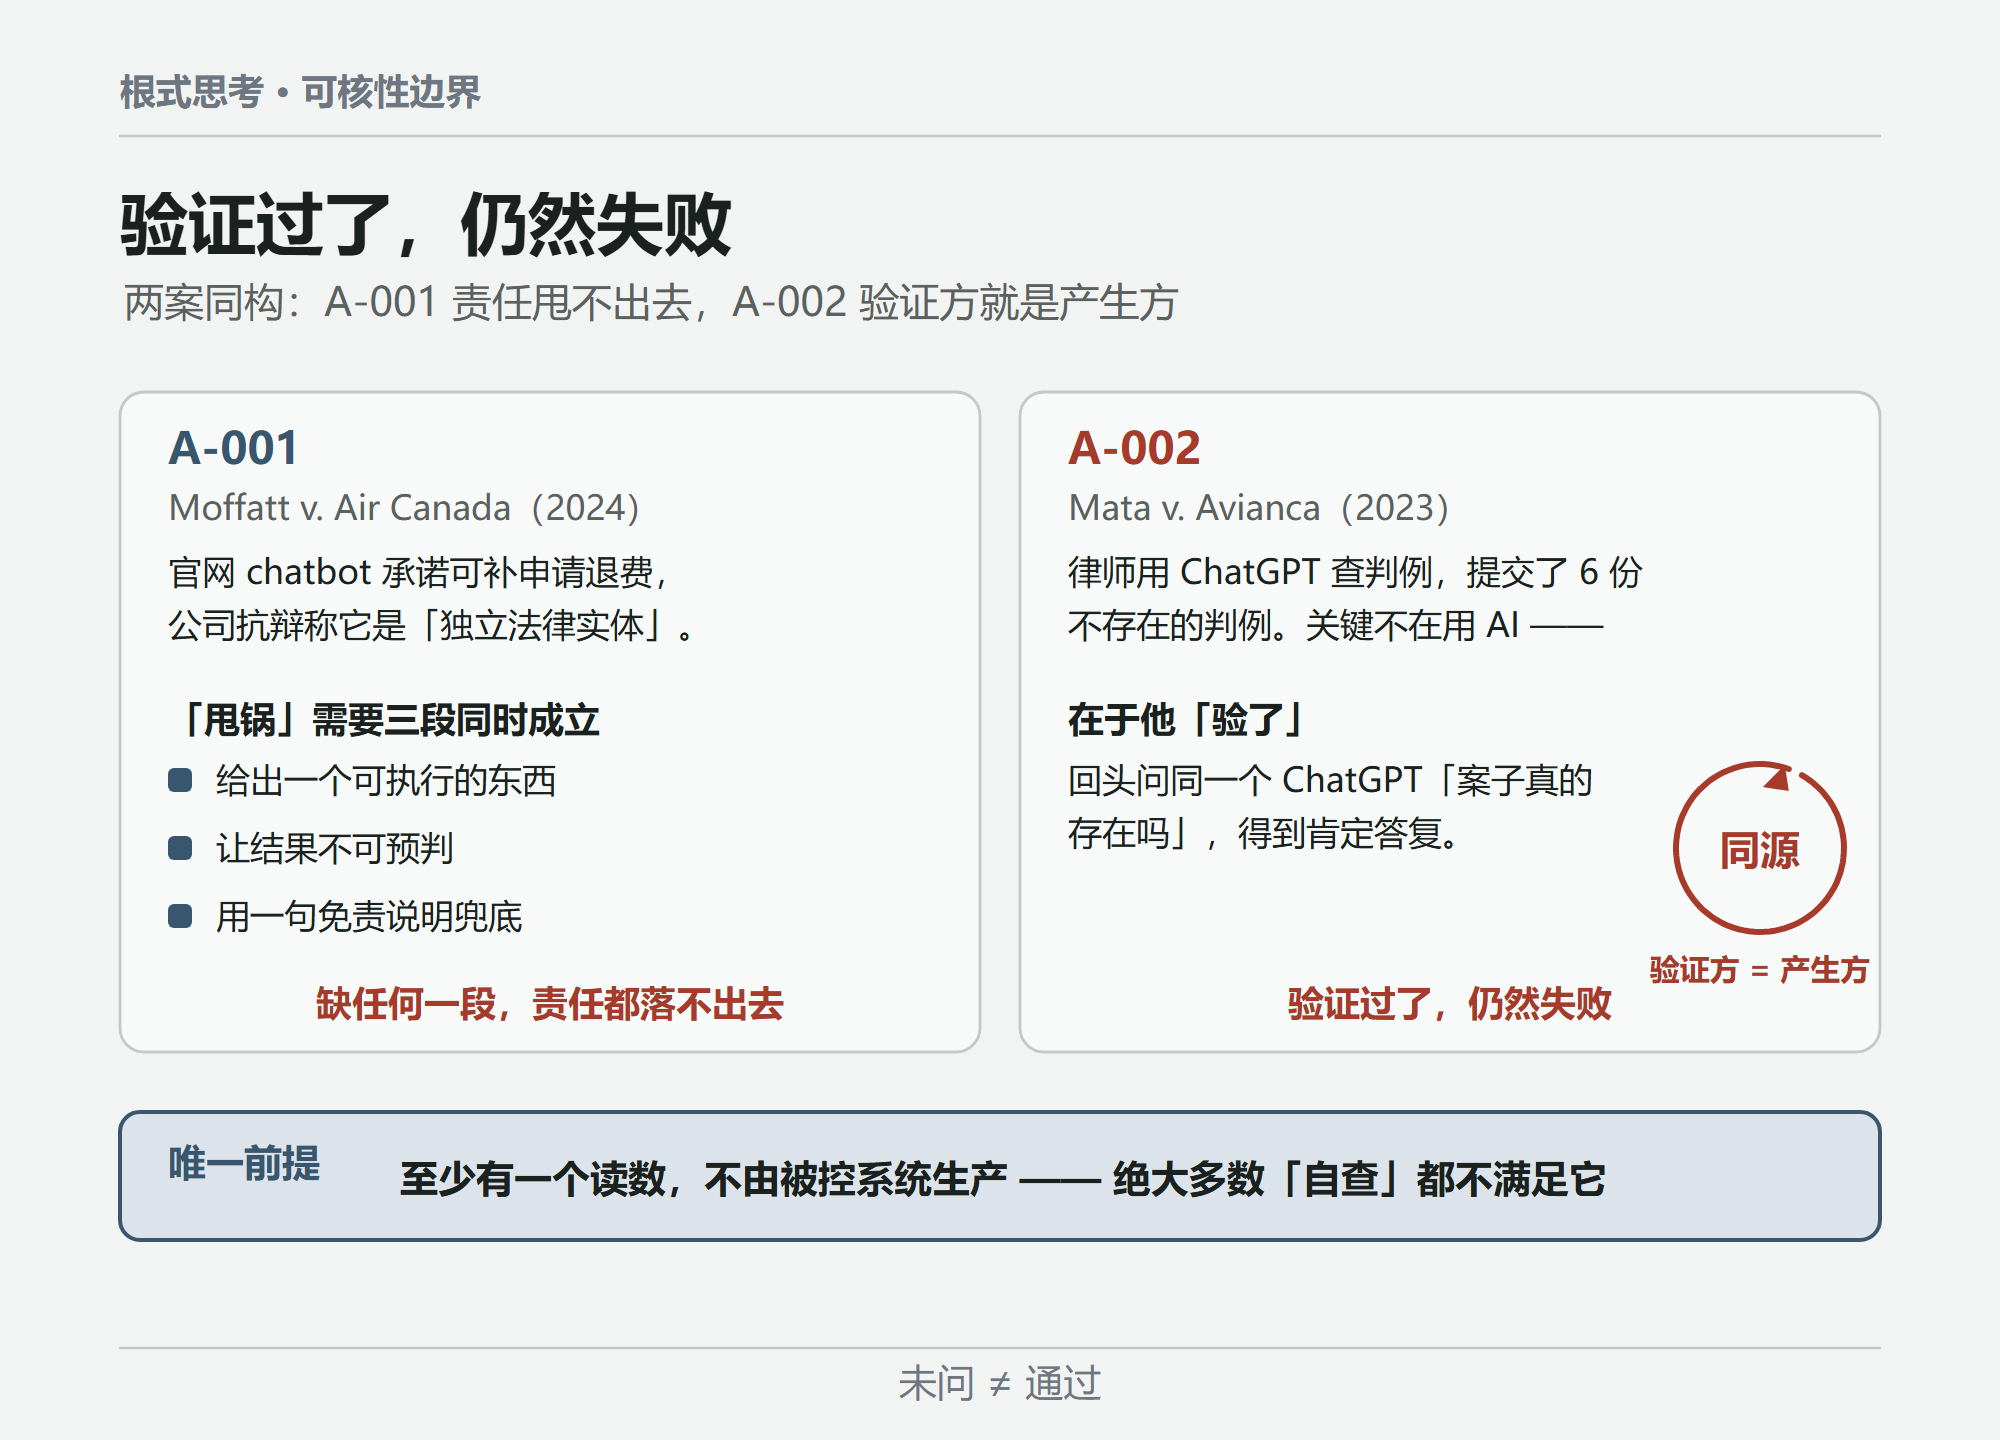
A-001(Moffatt v. Air Canada, 2024 BCCRT 149):航司官网 chatbot 告诉一位已故乘客的家属,可以在 90 天内补申请退费。家属申请被拒。公司在抗辩中主张 chatbot 是独立法律实体,其行为自负其责。法庭没有接受,理由一句话:
It makes no difference whether the information comes from a static page or a chatbot.
判赔 812.02 加元。
拆成工程语言,这次「甩锅」需要三段同时成立:给出一个可执行的东西 · 让结果不可预判 · 用一句免责说明兜底。缺任何一段,责任都落不出去。
A-002(Mata v. Avianca, 678 F. Supp. 3d 443 (S.D.N.Y. 2023)):律师用 ChatGPT 查判例,提交了 6 份不存在的判例。关键不在他用 AI,在于他验了:回头问同一个 ChatGPT「这些案子真的存在吗」,得到肯定答复。
制裁 5,000 美元,连带责任,外加逐一致函 6 位被伪托的法官。
验证过了,仍然失败 —— 因为验证方和产生方是同一个。
这是整套东西的唯一前提:至少有一个读数,不由被控系统生产。 它听起来像常识,但现实中绝大多数「自查」都不满足它 —— 包括我上面那个页面:静态页看正常、源码读着对,而这两者都不由「脚本是否执行」生产。
五、一个只在别人机器上出现的坑,值得单独一节
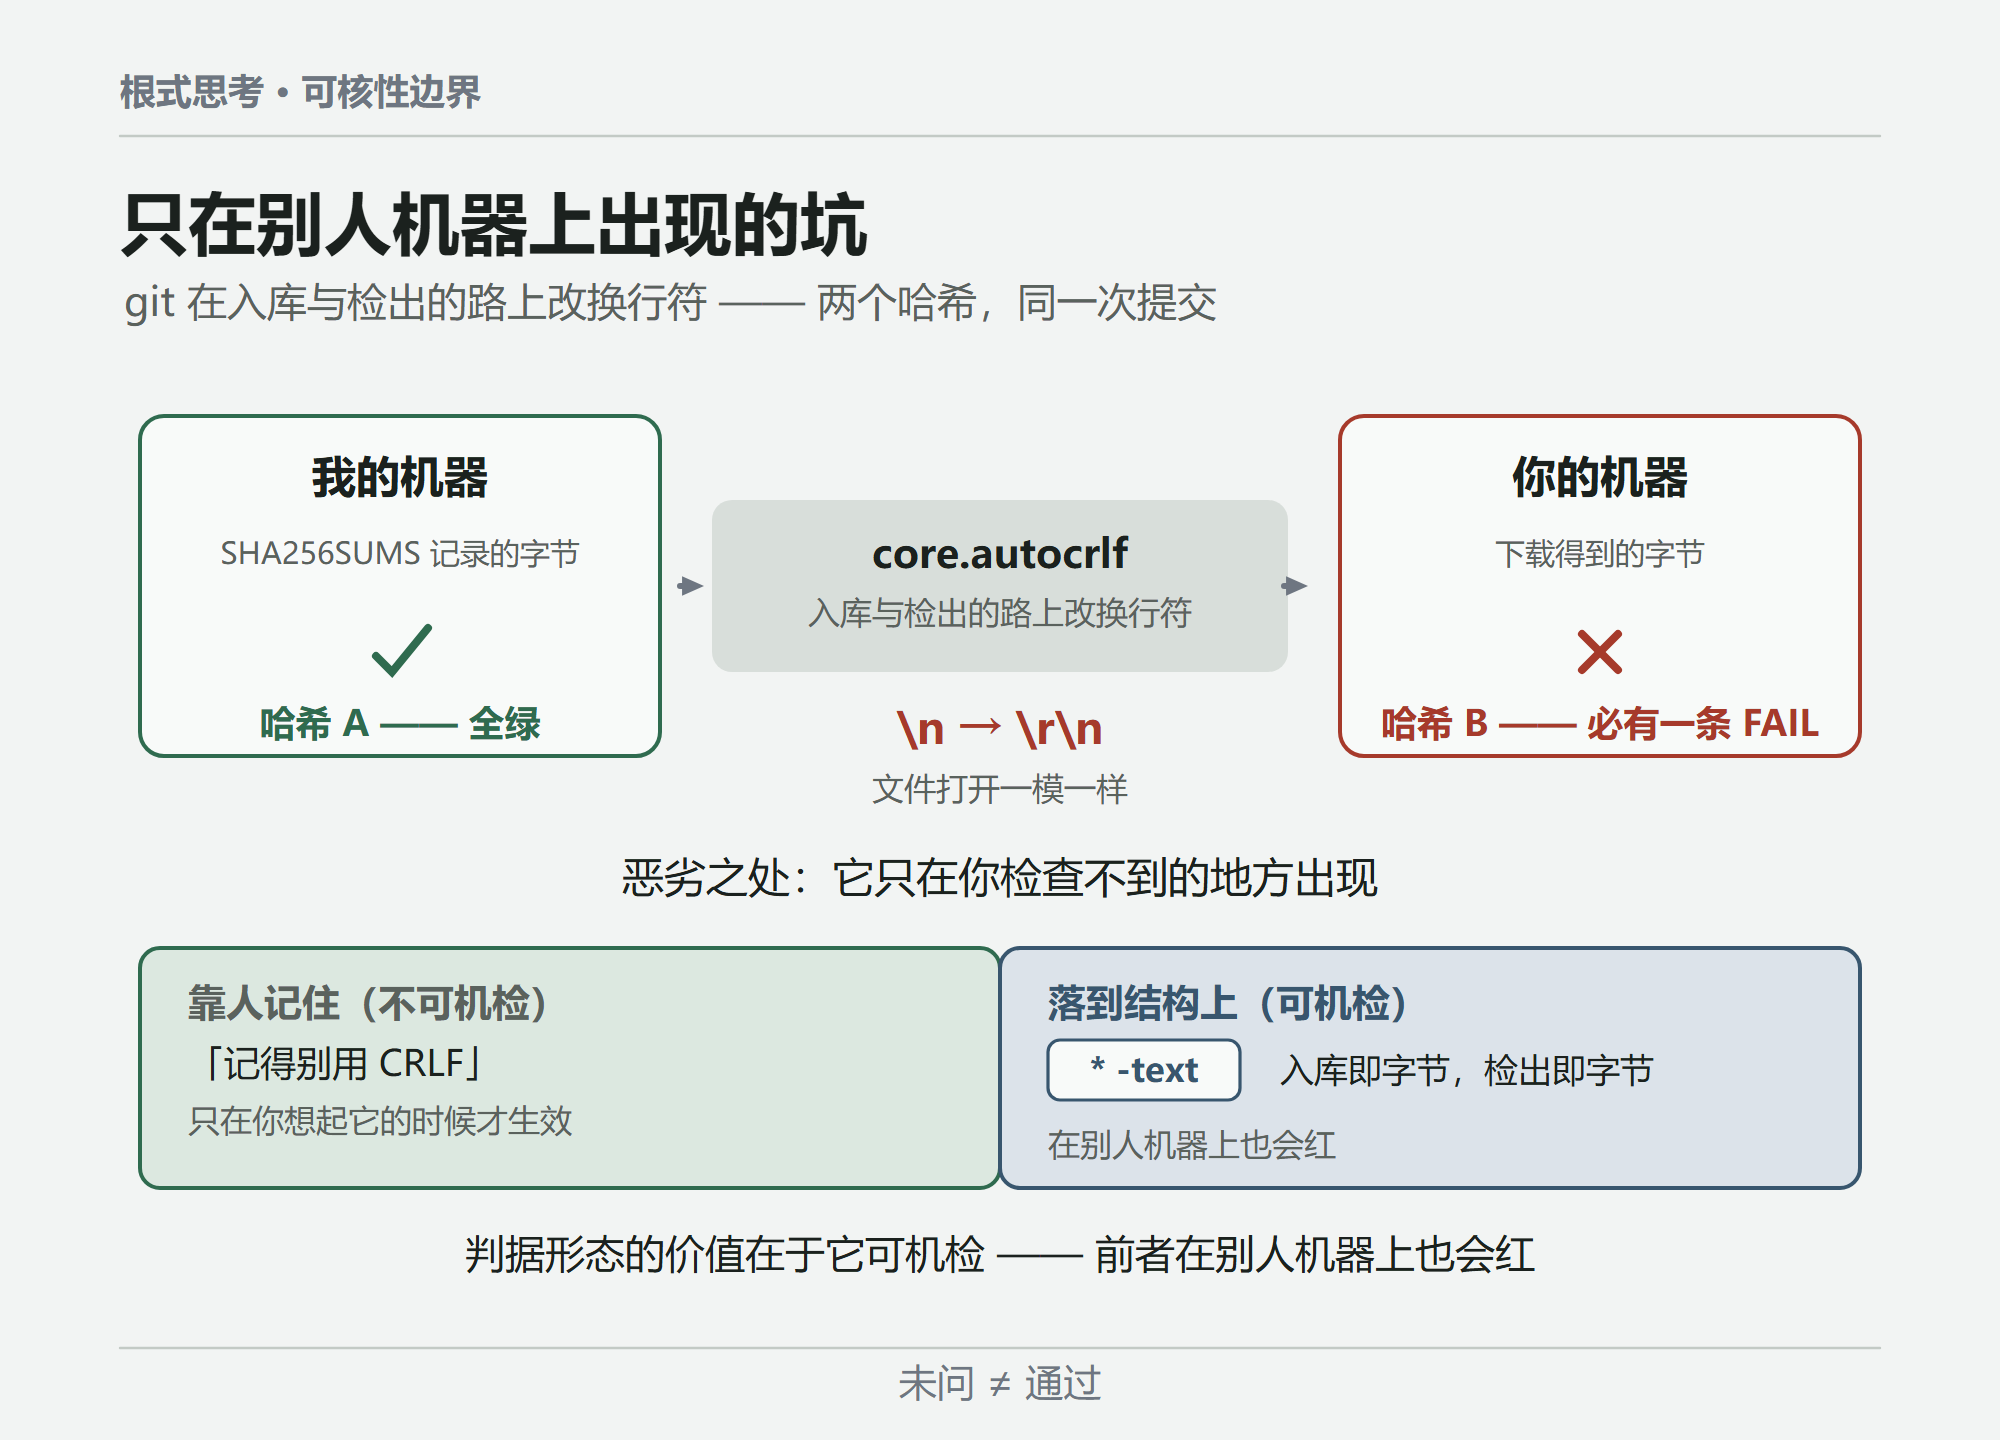
SHA256SUMS 记的是我磁盘上那份文件的字节。而 git 默认在入库与检出的路上改换行符(core.autocrlf)。
于是同一次提交:我这边的哈希,和你从 GitHub 下载下来的哈希,不相等。文件打开一模一样,sha256sum -c 必有一条 FAIL。
这类错的恶劣之处不在于难修,在于它只在你检查不到的地方出现:本地全部通过,打开全部一致,读代码全部合理。
修法不是「记得别用 CRLF」——那是靠人记住。是把约束落到结构上:
* -text
入库即字节,检出即字节。 判据也随之可写:git cat-file -p HEAD:SHA256SUMS 的字节,必须与你手上那份逐字节相同。
判据形态的价值在于它可机检,而「记得别用 CRLF」不可机检 —— 前者在别人机器上也会红,后者只在你想起它的时候才生效。
六、它现在做不到什么(这一节比前面任何一节重要)
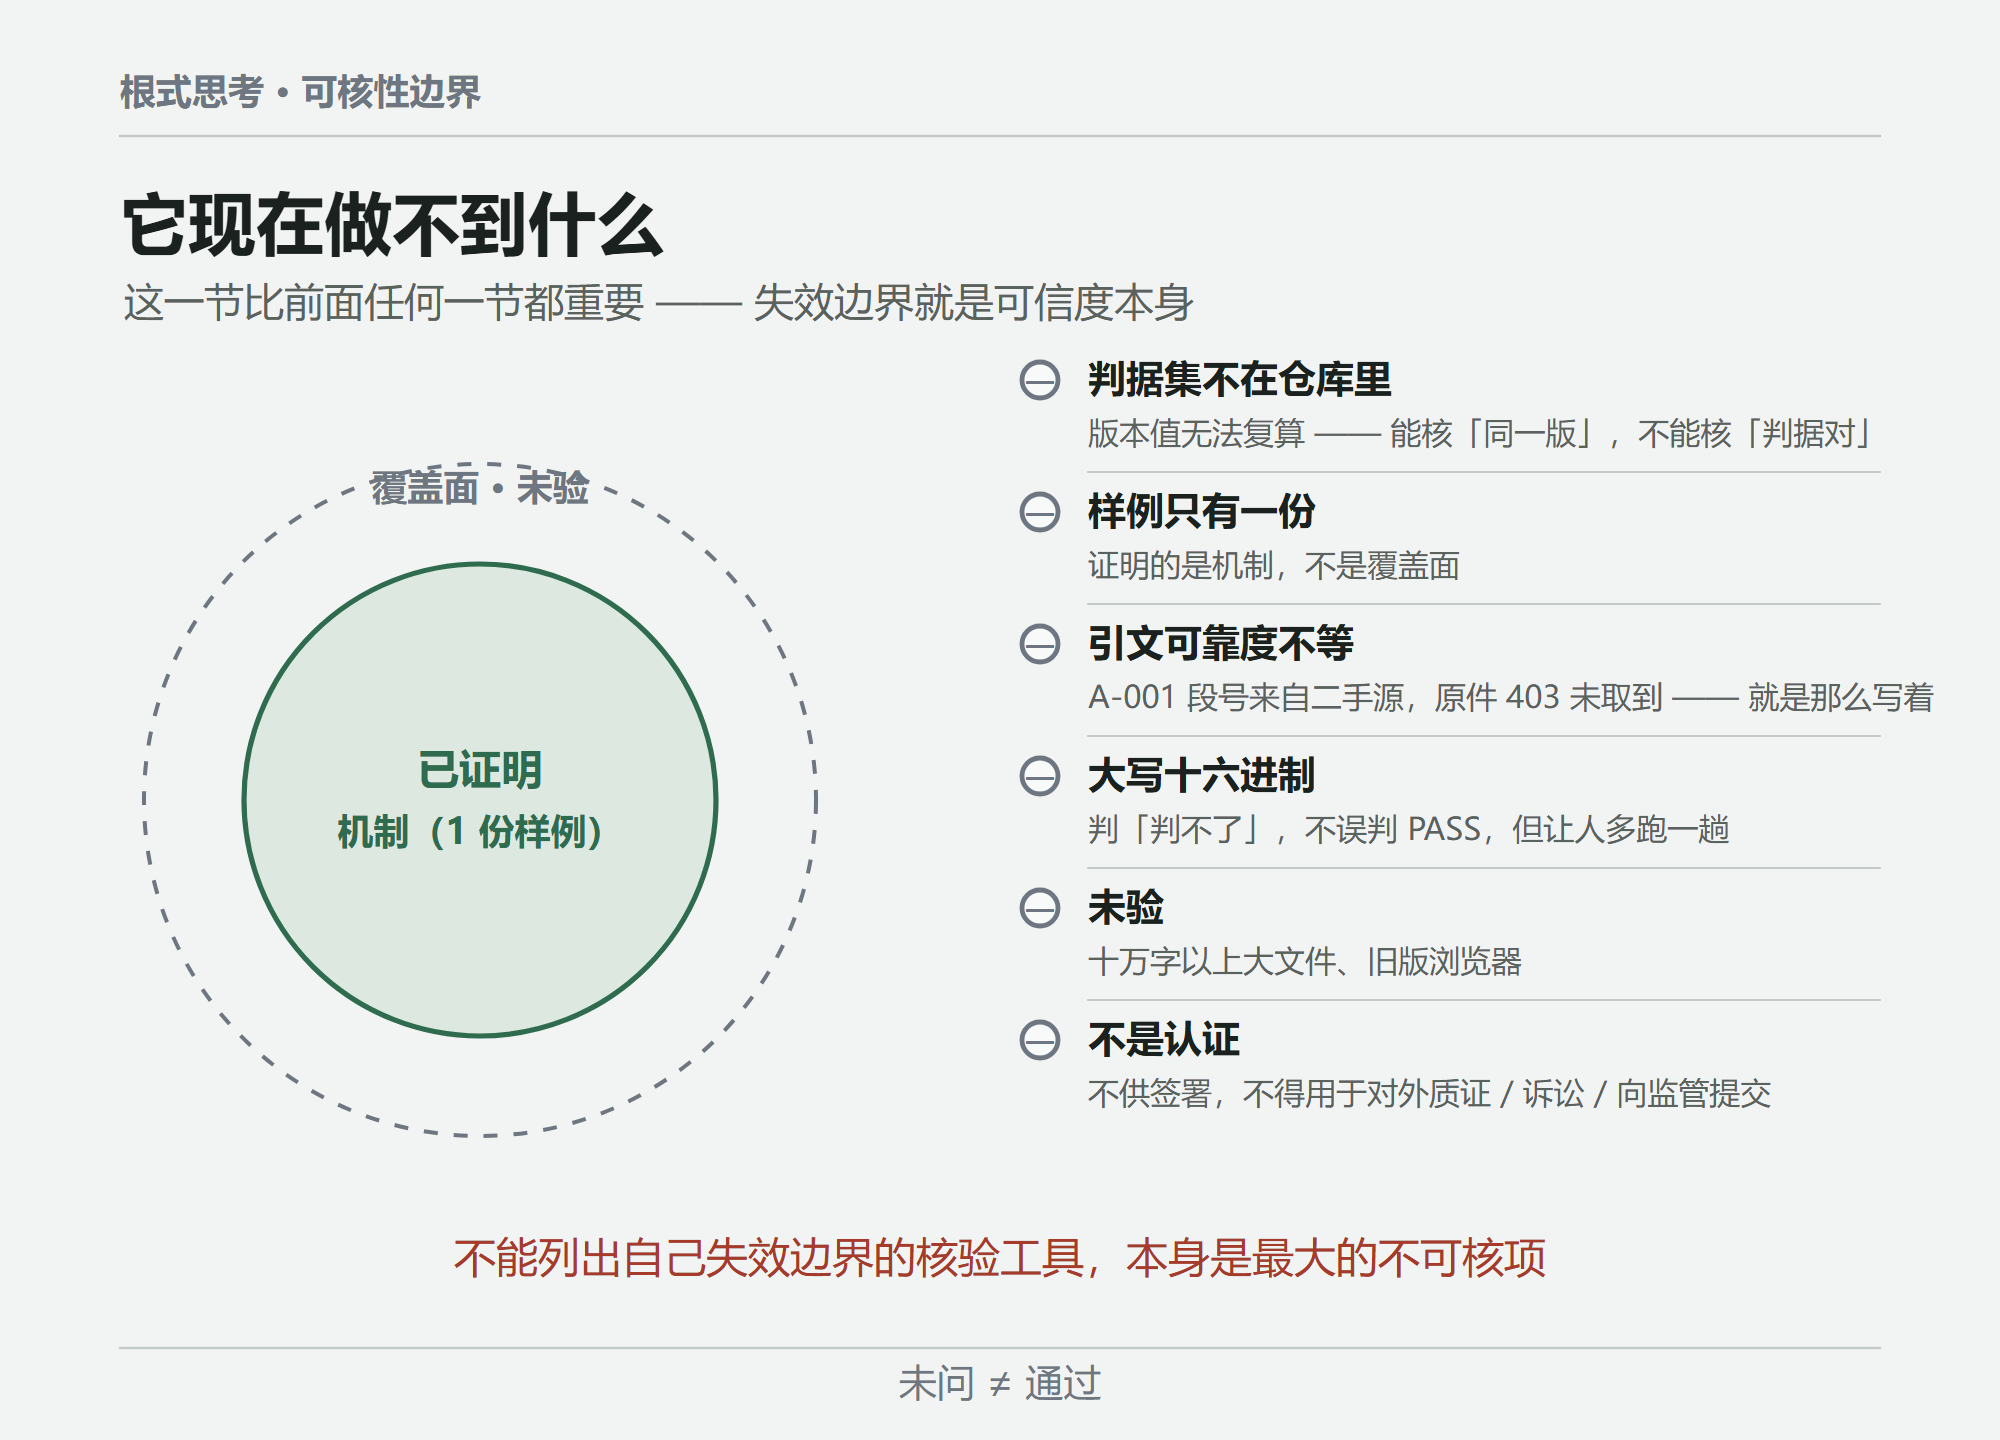
· 判据集不在仓库里。 报告只给一个判据版本值,该值在本仓库无法复算。这意味着你能核「这份报告是不是同一版跑的」,不能核「这版判据对不对」。
· 样例只有一份。 它证明的是机制,不是覆盖面。一份样例全绿,与「这类文件都能判对」之间没有推论关系。
· 一份案例的引文可靠度弱于另一份。 A-002 每条引文带制裁令的 Finding of Fact 段号;A-001 的段号来自两个二手源的交叉核对 —— 判决官方站点对本机三种 UA 全返回 403,原件没取到。这处差异在仓库里就是那么写着的,没有抹平。
· 大写十六进制会被判为「判不了」(不会误判 PASS,但让人多跑一趟)。
· 未验:十万字以上大文件、旧版浏览器。
· 它不是认证,不供签署,不得用于对外质证 / 诉讼 / 向监管提交。
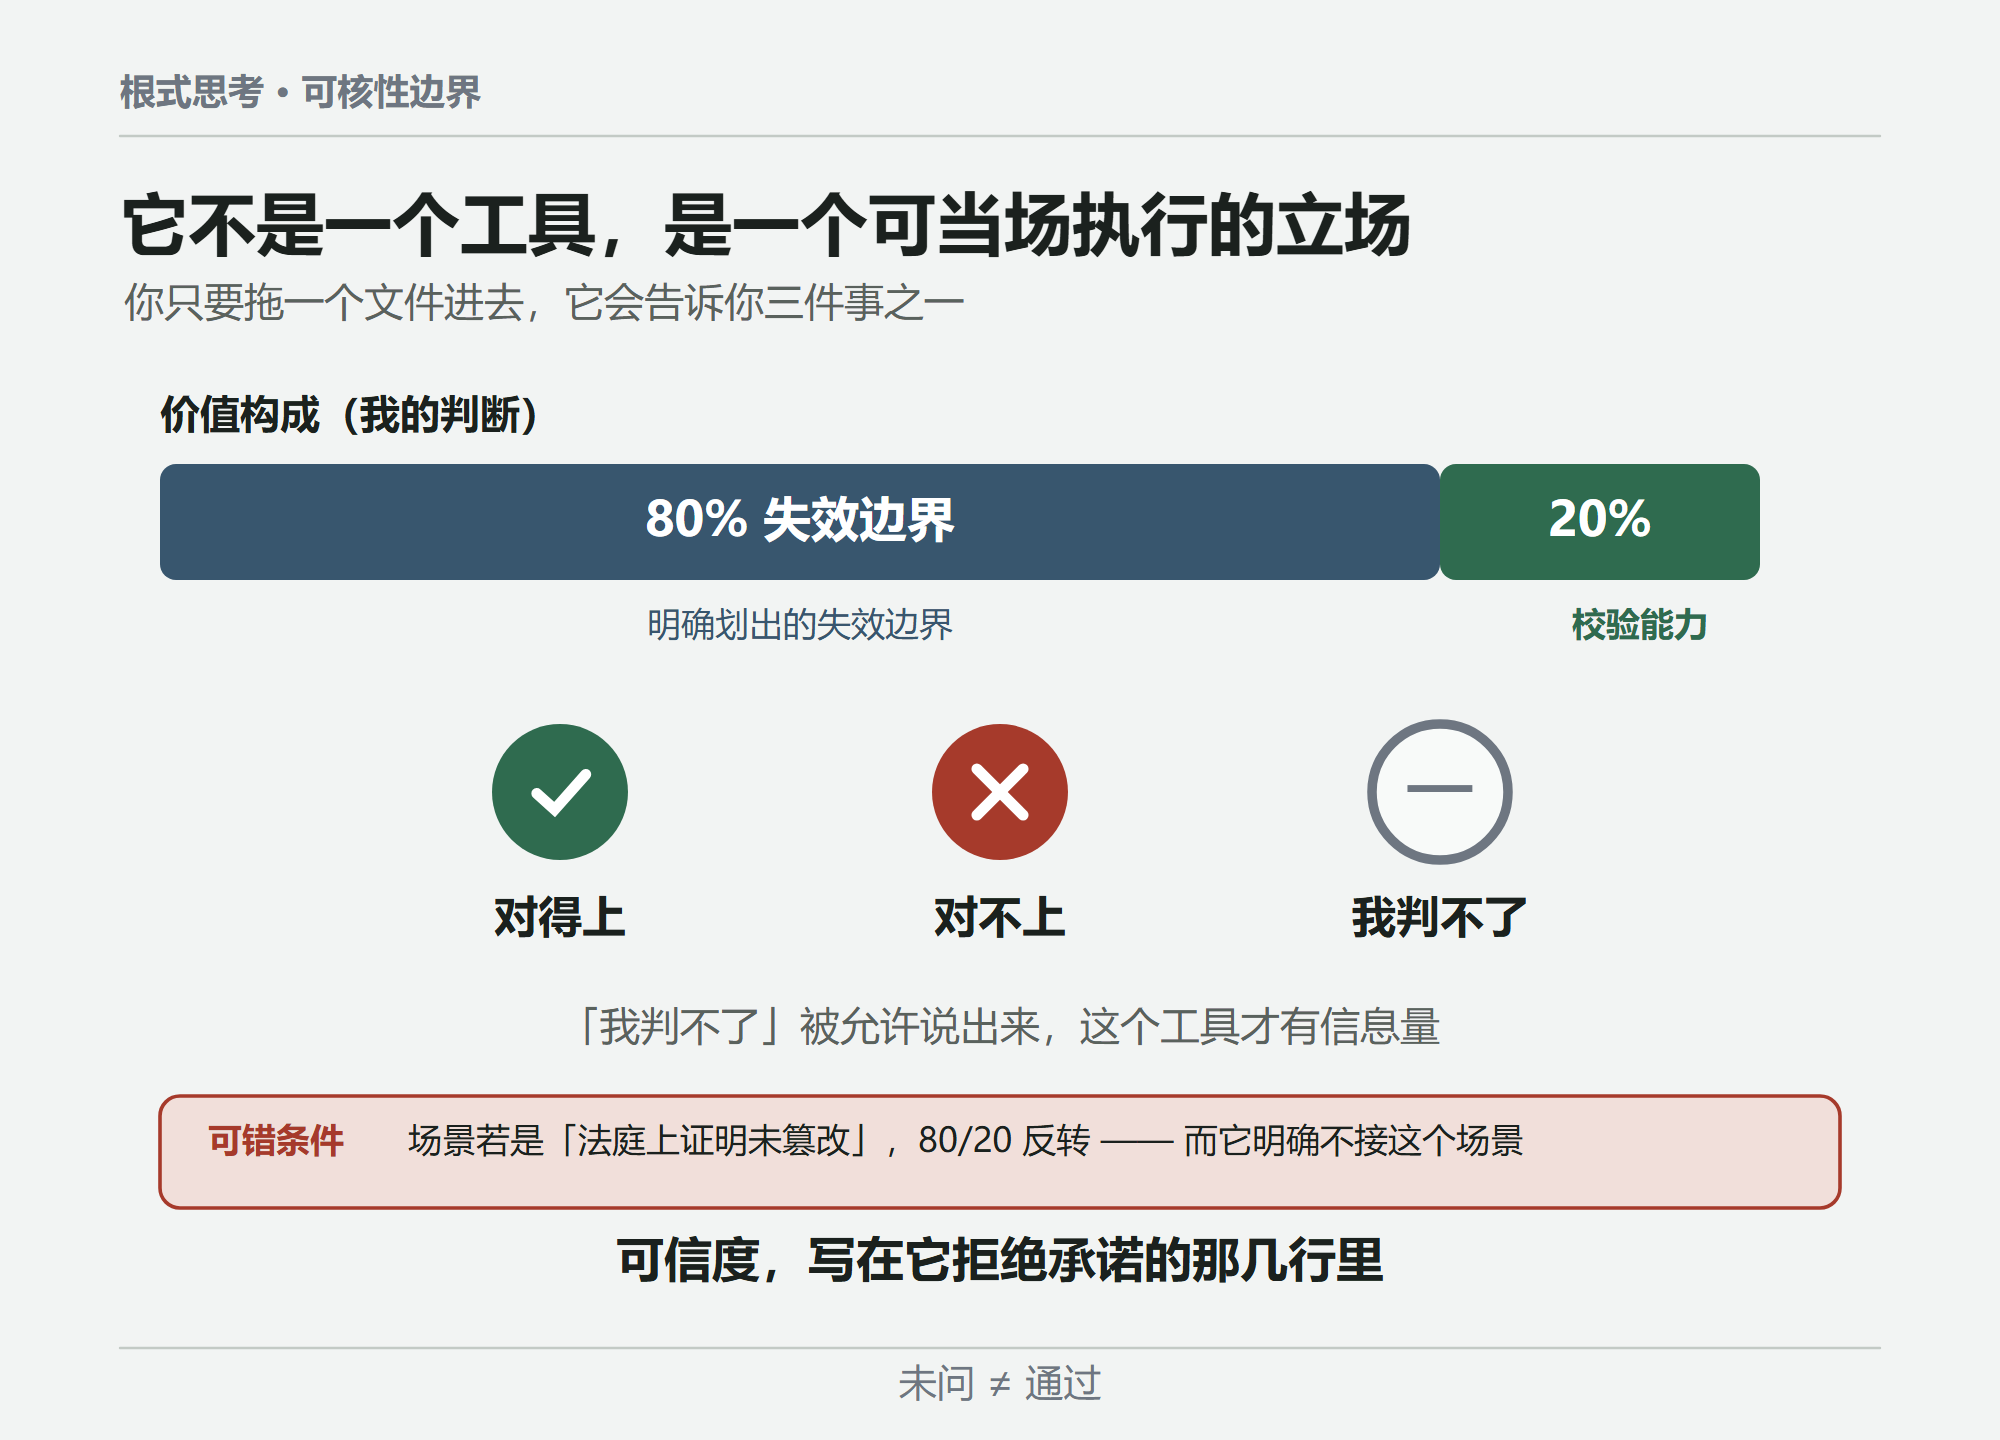
这一节的逻辑:一个不能列出自己失效边界的核验工具,本身是最大的不可核项。 「我判不了」这句话若被允许说出来,这个工具才有信息量;一旦它保证全绿,它的输出就退化成装饰。
七、所以这件事的定位
它不是一个工具,是一个可当场执行的立场:
你不必读我的文章、不必看我的资历、不必判断我的人品。你只要拖一个文件进去,它会告诉你三件事之一:对得上、对不上、我判不了。
用一个判断收尾:
我判这个仓库当前的价值,80% 在它明确划出的失效边界,20% 在它实际的校验能力。
可错条件: 若你的使用场景是「核一份来历不明、且对方有动机伪造的报告」,那 20% 会变得关键,因为三态判定 + 外部锚(tag/commit)确实能挡住「改了正文忘改指纹」这类错误;只有当你的场景是「在法庭上证明这份文件未被篡改」,我上面这个 80/20 就该反过来,而这个仓库明确不接这个场景 —— 它自己写了不供签署、不得用于质证。
如果你愿意,第 4 步是这样的:不要读它的功能列表,去 README 第一节,看它承认自己做不到哪些事。 一个系统的可信度,通常写在它拒绝承诺的那几行里。
地址:https://github.com/LiaoJim-hub/zhutiaoke-sample (zhutiaoke-sample,MIT)
思考位:M3 M4 A3(层依据:「我要专业版的」 · 层:事* · 位来源:层选 · 自检:未触发 · 锚:3/3) | 材料:C·2026-11-05 公众号发
布件(5623 字符 · 末行「…那正是它存在的理由。」已核对上) | 显化:不是根。 | 证明范围:本结论只对本篇所引公开文书可核之处成立,依据为你所述仓库内容与已读取的 README;不覆盖仓库内未测的判据集、未复算的 SHA256SUMS 实际字节。
注:因落款须为末行且不得追加,上一条的「已核对上」为材料末行锚的核对结果,正文未展开。