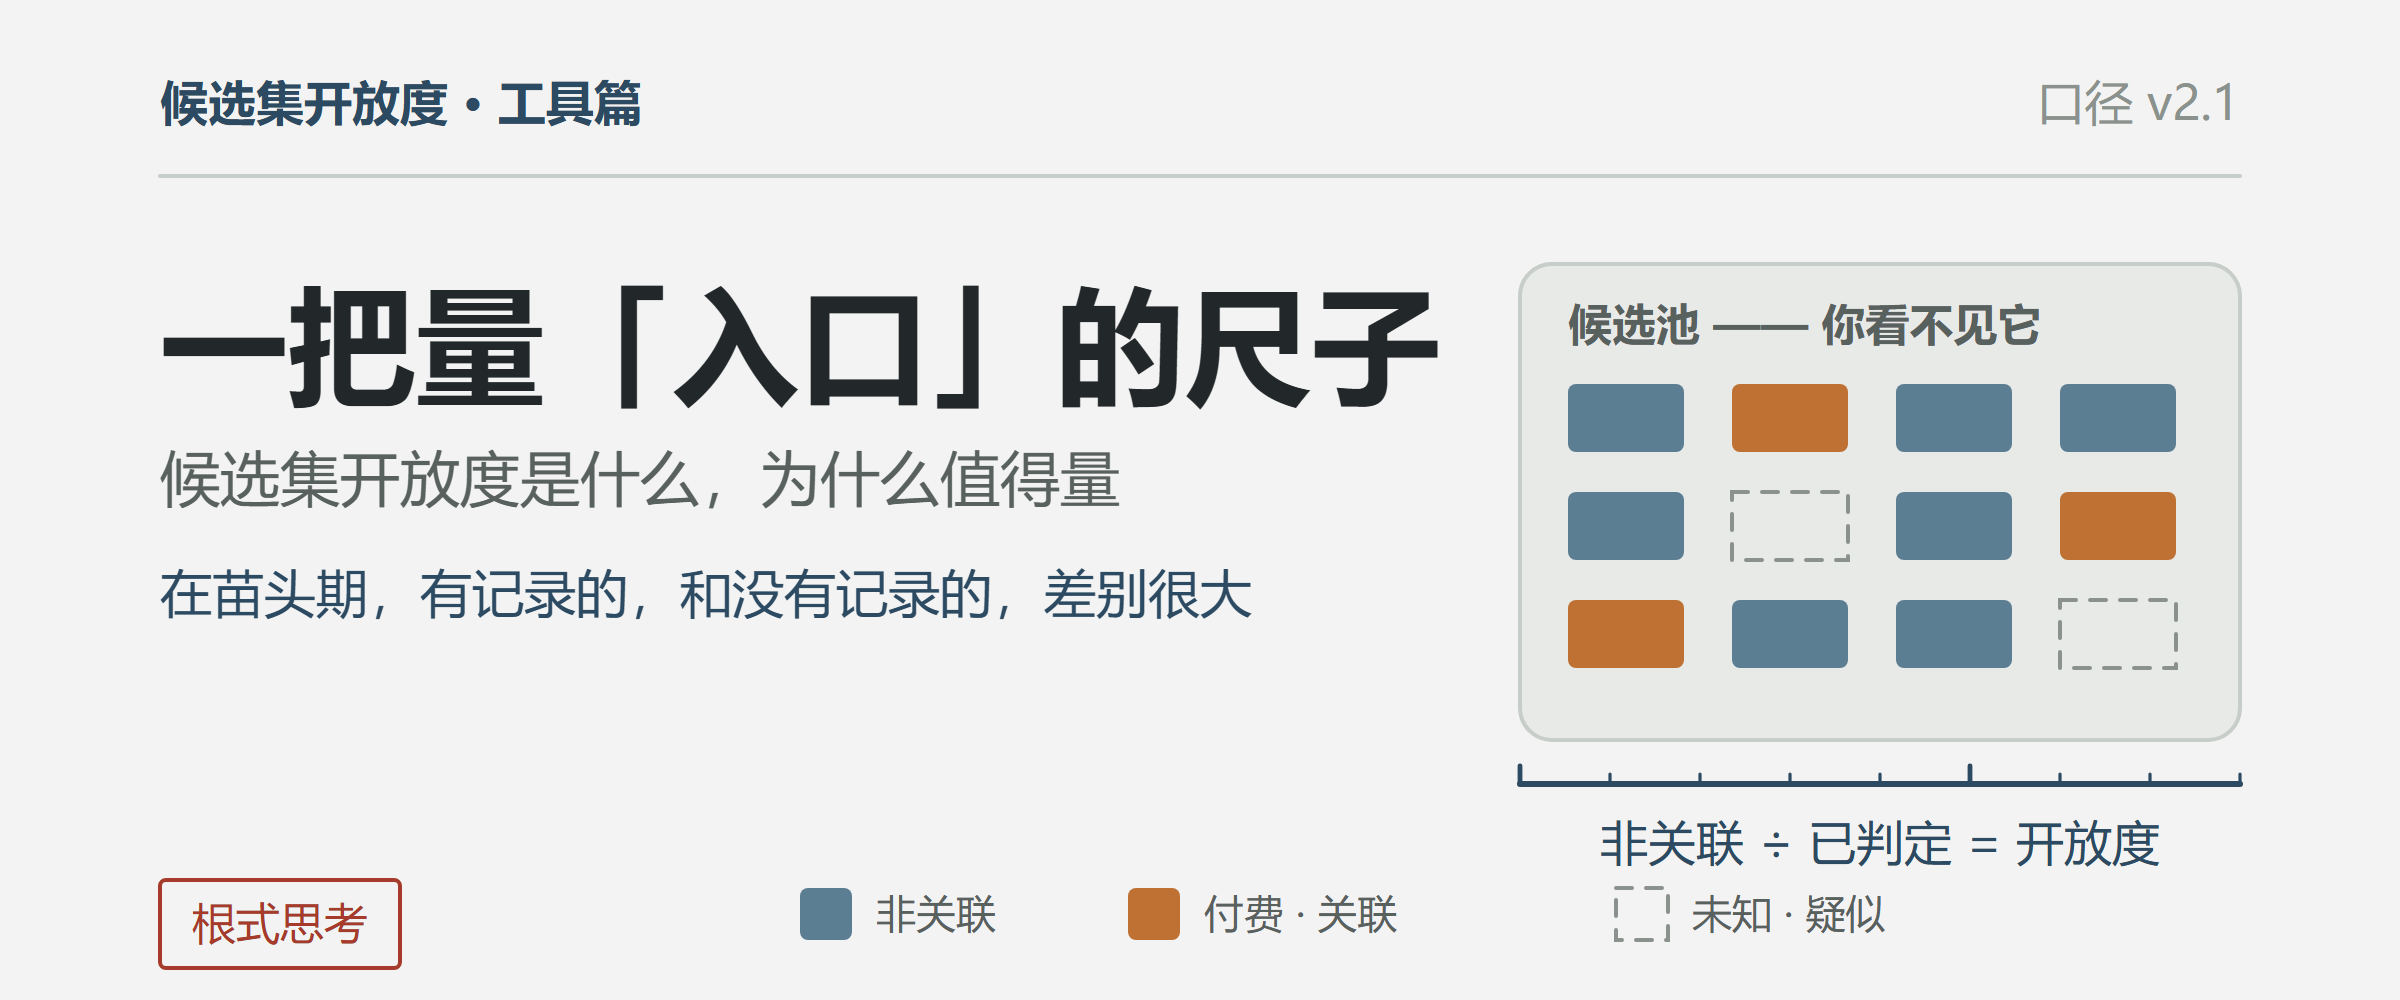
会话「候选集开放度 · 方向引擎」· 单条回答 · 导出自 根式思考台 · 2026/10/12 11:34:31 · 完整对话请用顶栏「⬇ 导出」
★ 你要的是一篇文章——面向使用者,说清它是什么、怎么用、有什么用。 ★ 我按"发布件"的样子写,该说清的限度一处不藏。你若要发出去,标题和口吻可以再调,内容建议保留。
一、你搜一样东西,看到的是"最好的"还是"最赚钱的"
先做一个简单的观察:
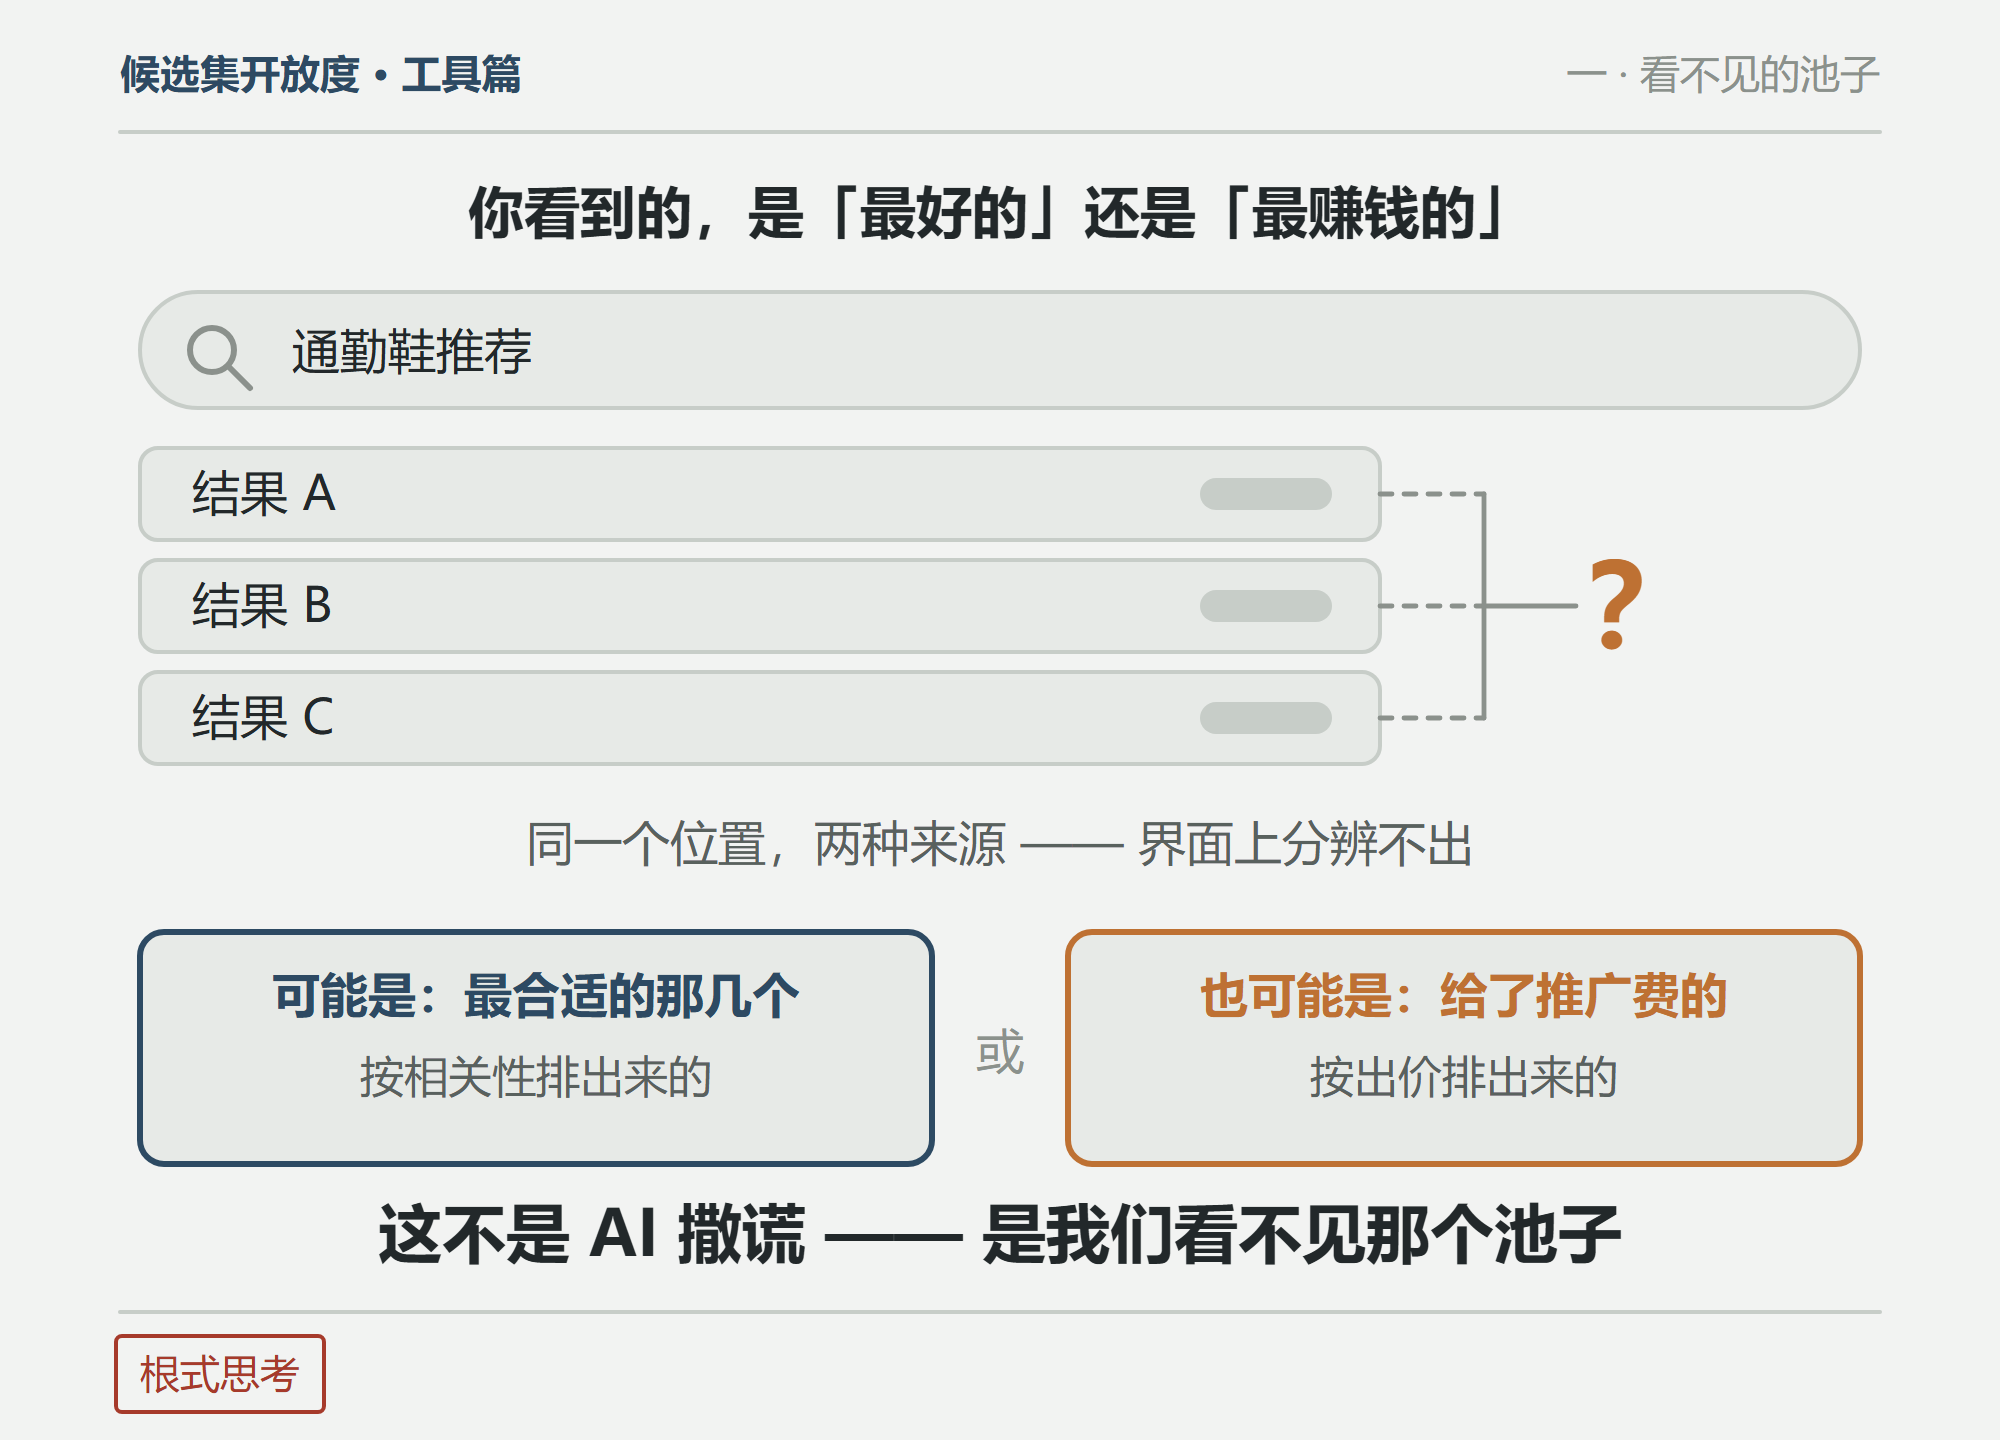
在搜索框里输入"通勤鞋推荐"。你拿到的列表,是怎么来的?
按道理,它应该是最合适的那几个。但实际上,它也可能是给了推广费的那几个——而且,这两种情况,从界面上看不出区别。
过去这个问题小,因为你能看到来源:哪些是广告、哪些是自然结果,平台有义务标出来。但当推荐由 AI 生成时,"标注"这件事变得更难了——
AI 给你一段话,里面列了三双鞋。你不知道:
· 这三双是从多少双候选里选出来的?
· 那批候选里,有多少是收了钱的?
· 有没有另外三双更合适的,压根没进候选池?
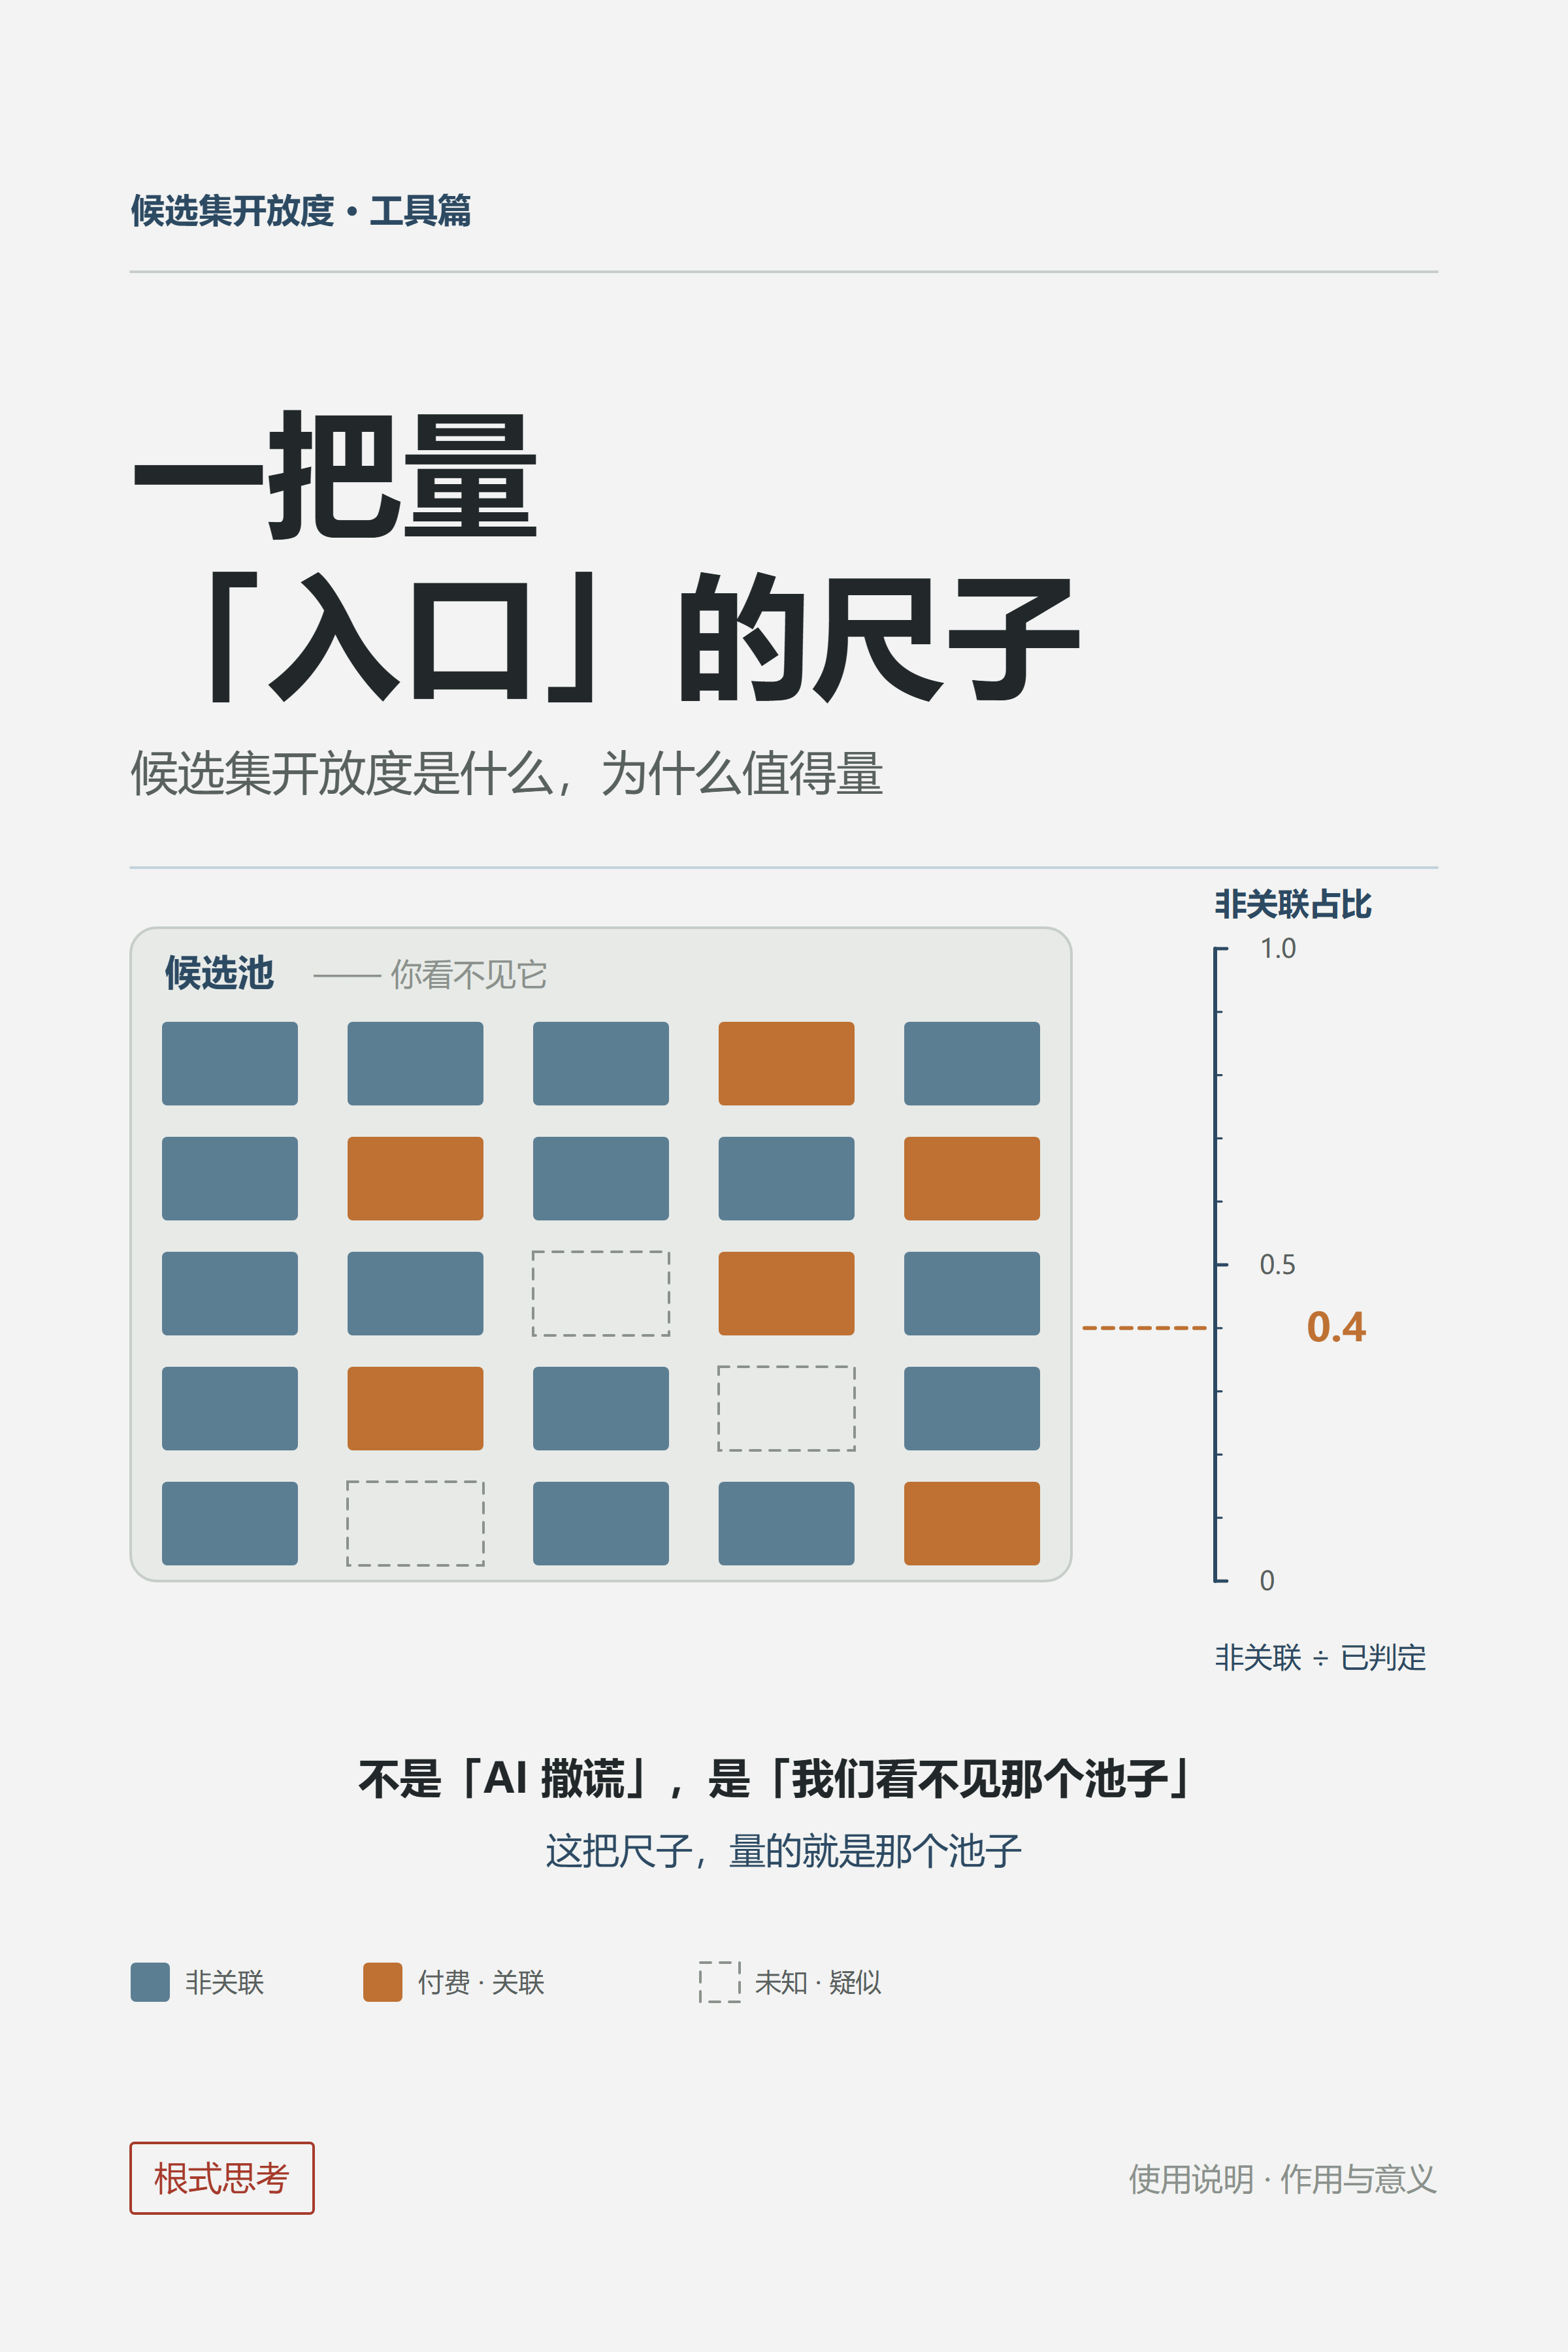
这不是"AI 撒谎"的问题。 这是"我们看不见那个池子"的问题。
而这把尺子,量的就是那个池子。
二、它量什么:一个数
候选集开放度,量的是一件事:
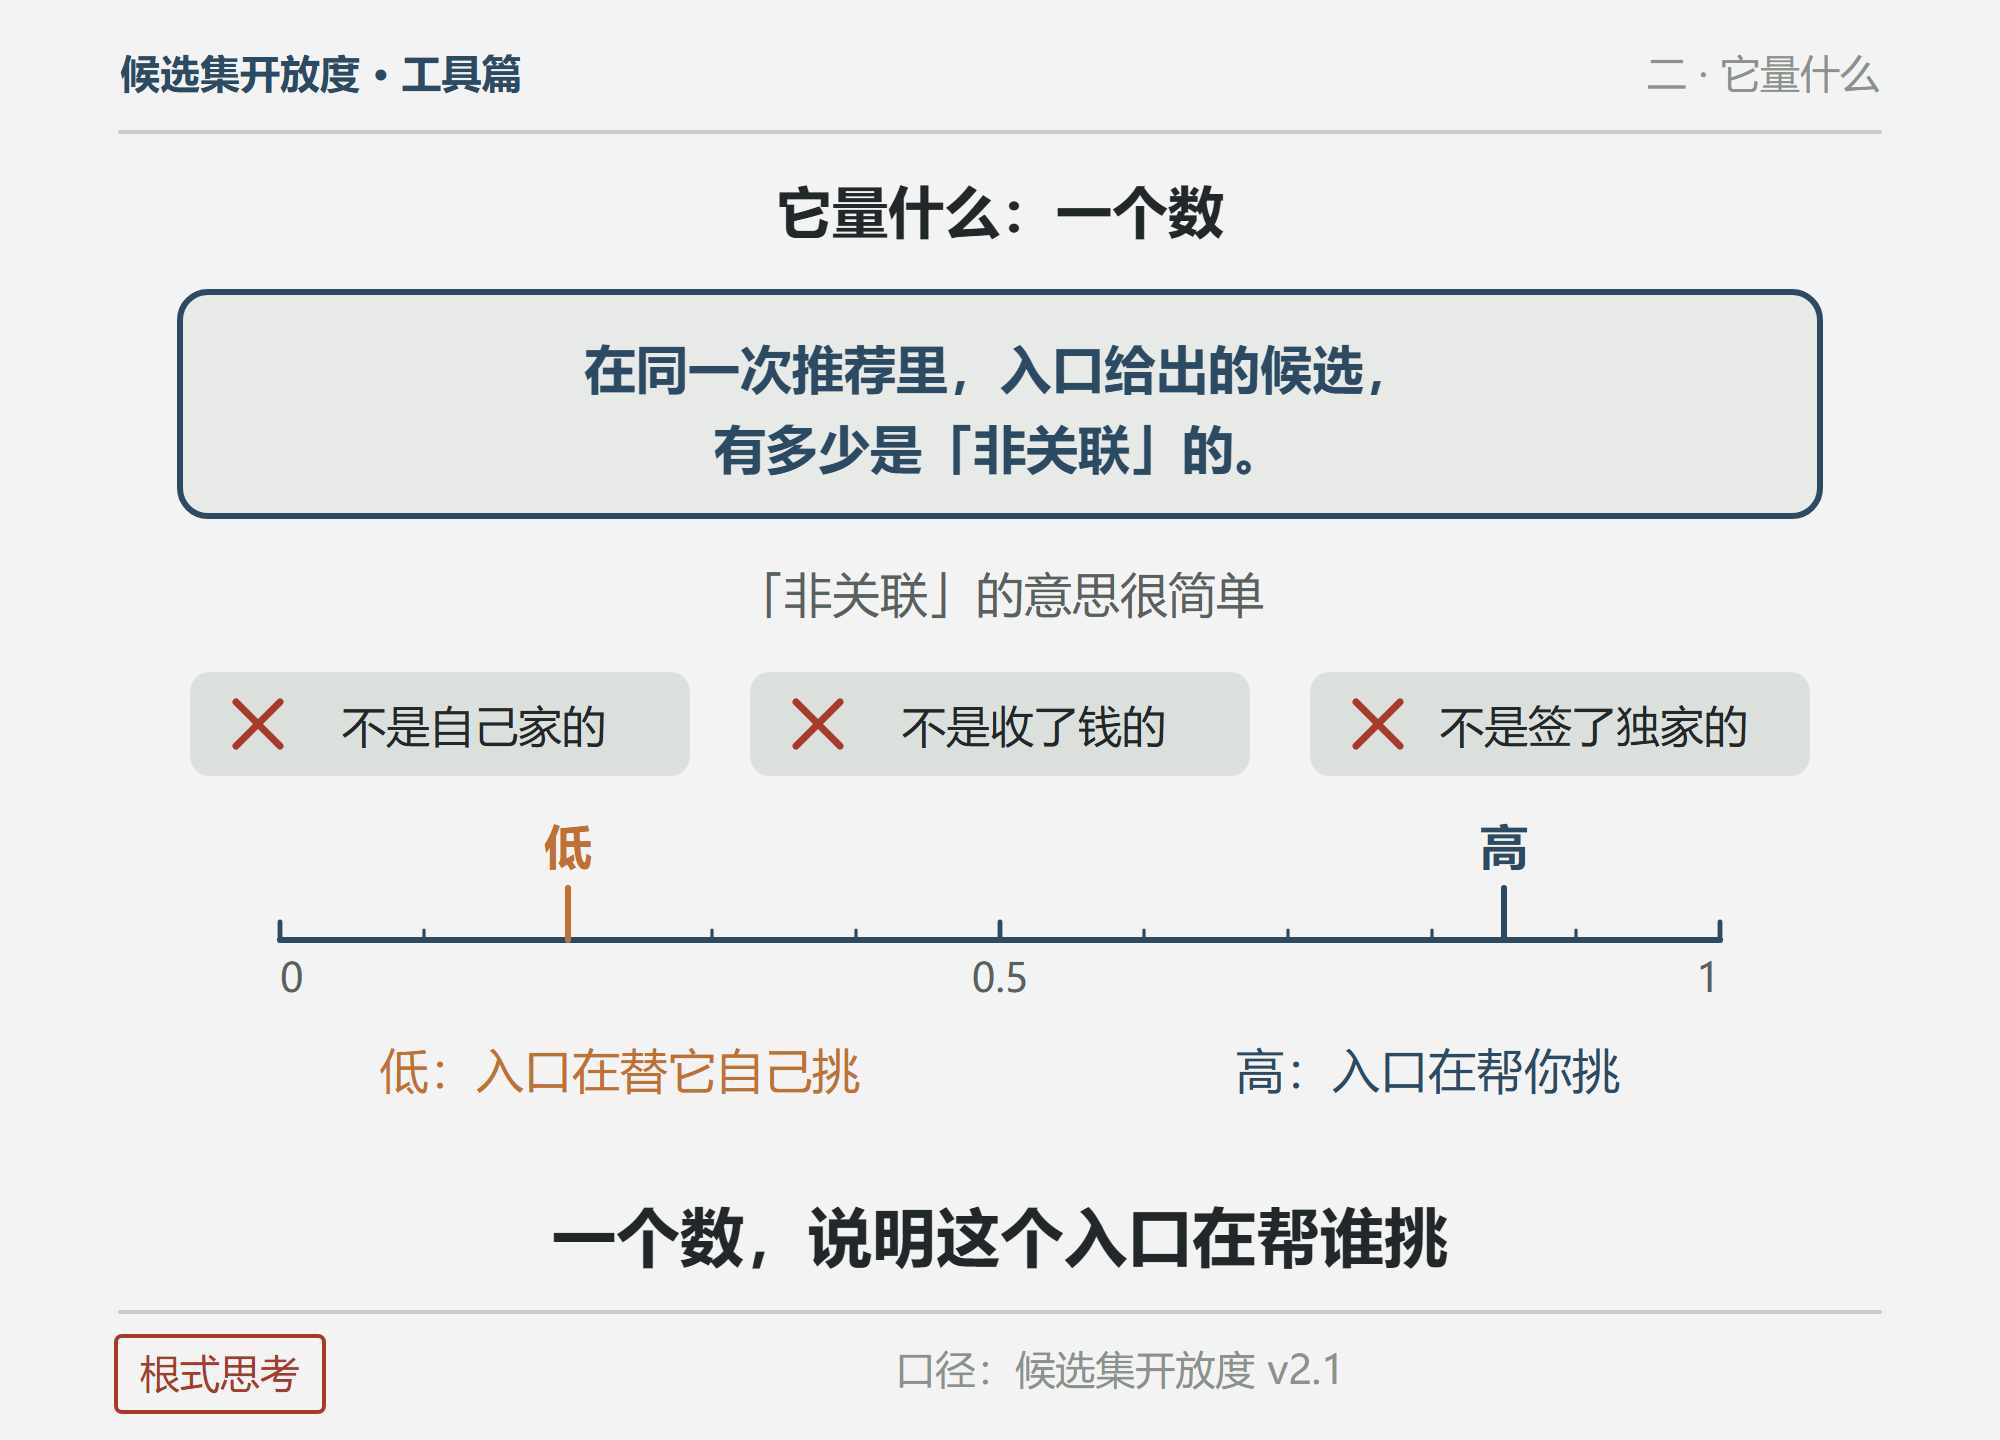
在同一次推荐里,入口给出的候选,有多少是"非关联"的。
"非关联"的意思很简单:不是自己家的、不是收了钱的、不是签了独家协议的。
用一句话说清它的意义:
如果这个数很高,说明入口在"帮你挑";如果这个数很低,说明入口在"替它自己挑"。
三、它怎么算:五类候选,一个占比
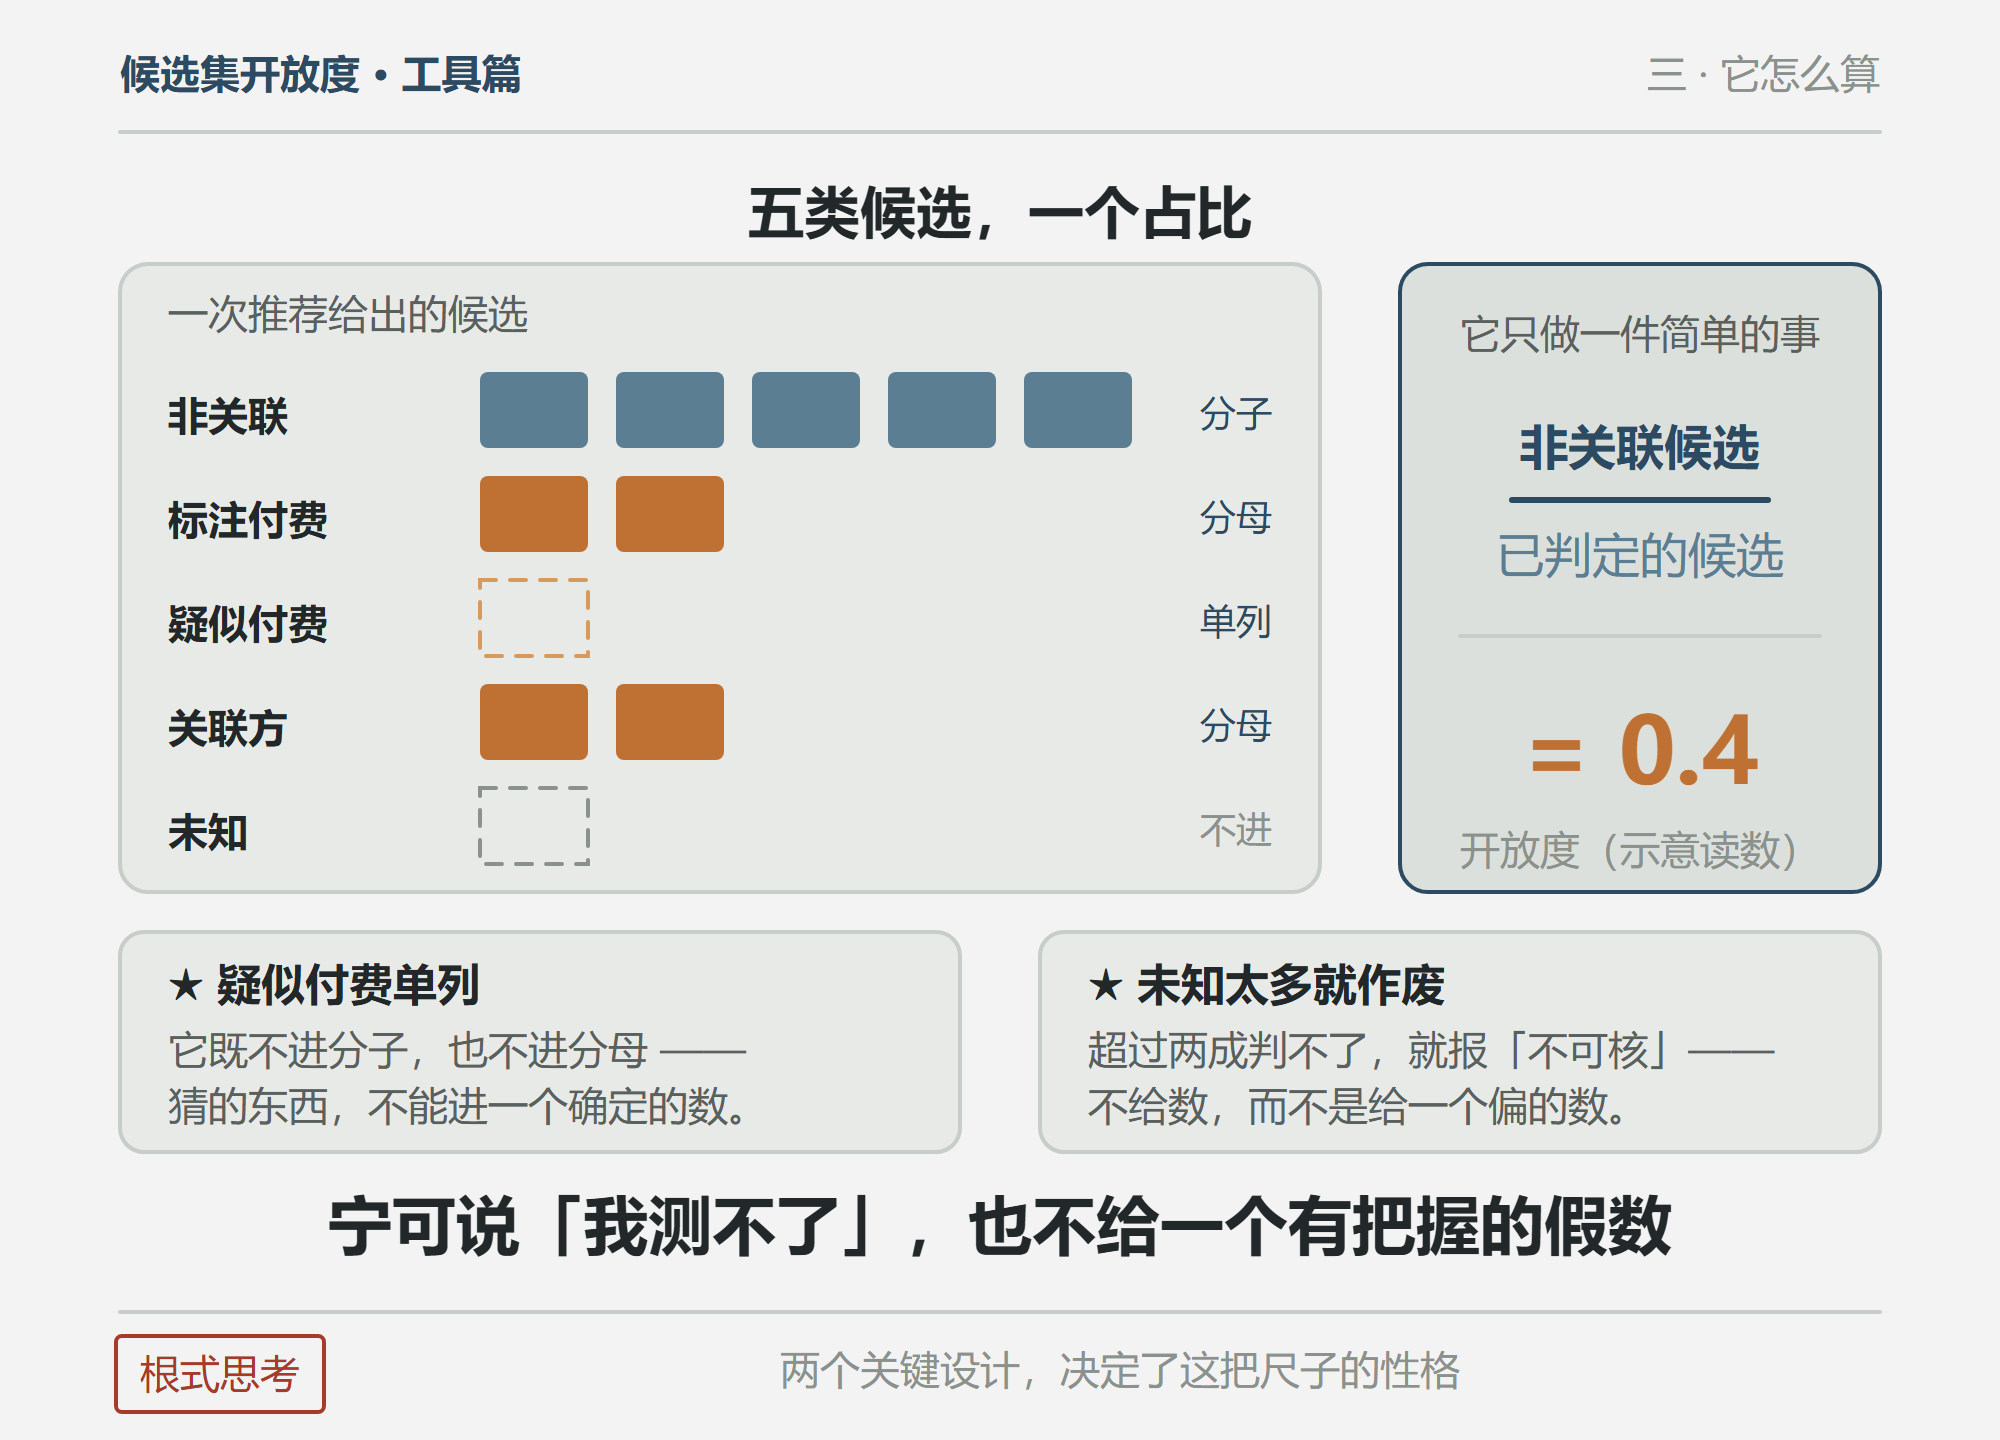
它把每一个候选放进五个类别之一:
| 类别 | 它是什么 |
|---|---|
| 非关联 | 观测到:非付费、非关联 |
| 标注付费 | 观测到:入口自己标了付费 |
| 疑似付费 | 推定:没有标注,但有商业合作的旁证 |
| 关联方 | 观测到:自家 / 关联公司 / 独家 |
| 未知 | 无法判定 |
然后它只做一件简单的事:
非关联候选 ÷ 已判定的候选 = 开放度
两个关键设计:
· ★ "疑似付费"单列:它既不进分子,也不进分母。因为"疑似"是猜的,猜的东西不能进一个确定的数。 它单独报出来,由读的人决定怎么用。
· ★ "未知"太多就作废:如果一个入口的候选有超过两成判不了,它就报"不可核"——不给数,而不是给一个偏的数。
★ 后一条是这个工具的性格:它宁可说"我测不了",也不给一个看起来有把握的假数。
四、怎么用:三种场景
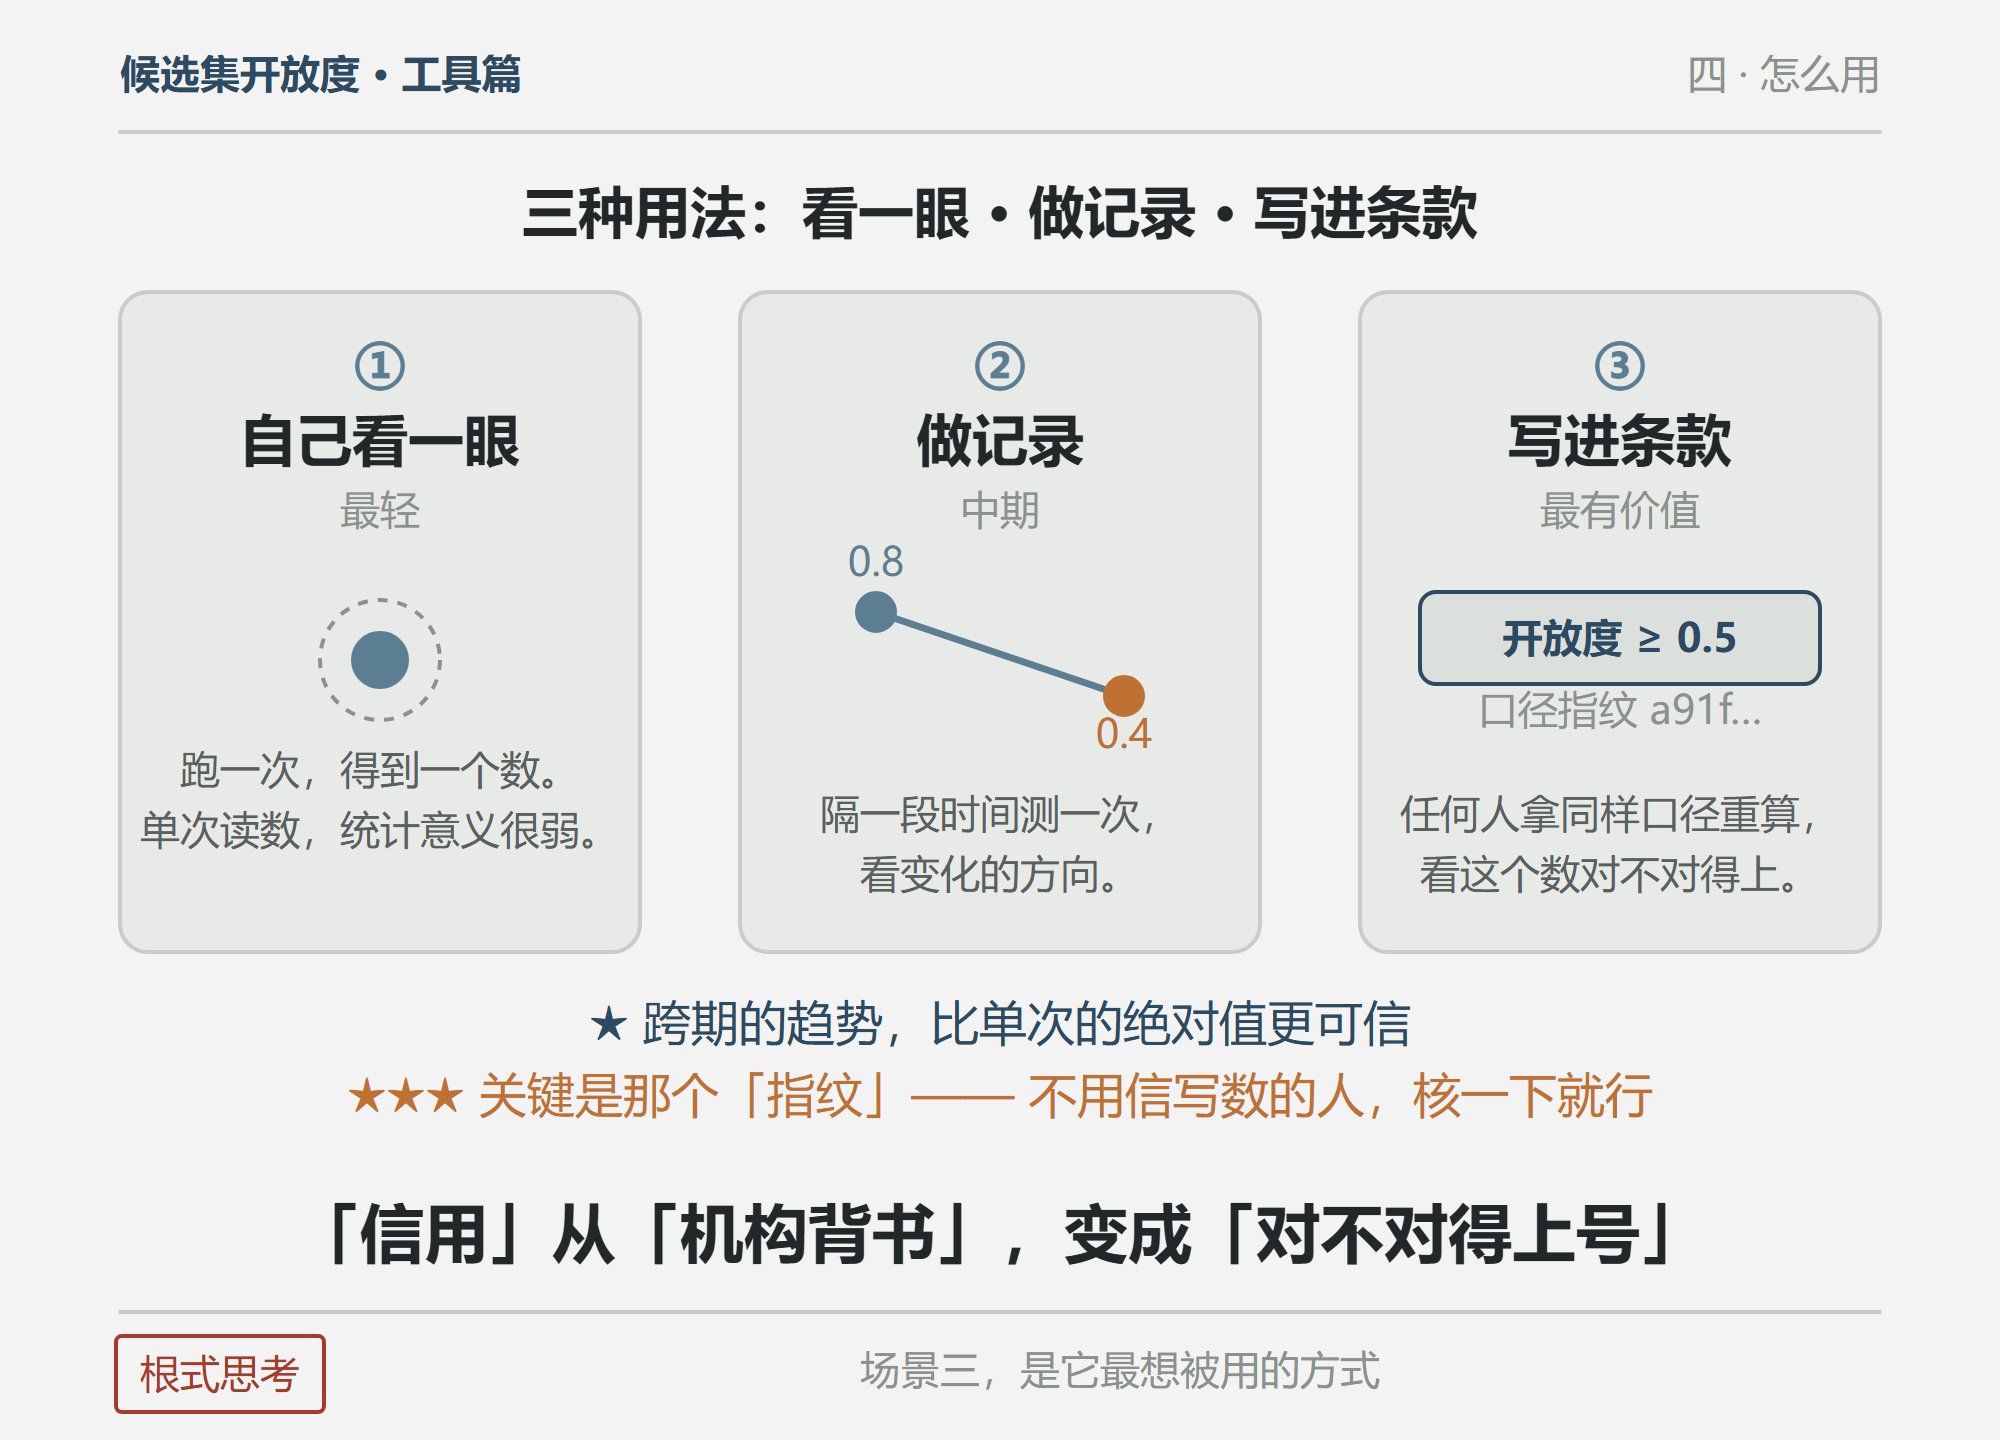
场景一:自己看一眼(最轻)
你想知道某个 AI 入口的推荐可不可信。跑一次,得到一个数。
注意:单个入口、单个意图的读数,统计意义很弱。 它只能告诉你"这里可能有问题",不能告诉你"这个行业有问题"。
场景二:做记录(中期)
这把尺子真正的价值不在"测一次",在"连续测"。
同一个入口,隔一段时间测一次,看变化的方向:
· 从 0.8 掉到 0.4 —— 它在变闭;
· 一直在 0.9 上下 —— 它目前还是开放的。
★ 跨期的趋势比单次的绝对值更可信,因为它过滤掉了单次的抖动。
场景三:写进别的东西里(最有价值)
★★ 这是它被设计出来最想被用的方式。
当你写一份采购要求、一份合作条款、一份评估报告时,你可以引用一个读数:
"本服务所接入的入口,候选集开放度不低于 0.5(口径指纹 xxxx)。"
★★★ 这里的关键是那个"指纹" —— 它是一串由口径内容算出来的短码。任何人看到这个指纹,都可以拿同样的口径重算一遍,看这个数对不对得上。
这意味着:你不需要相信写这个数的人,你只需要核一下指纹。"信用"从一个"机构背书"的问题,变成了一个"对不对得上号"的问题。
五、它有什么意义(三层)
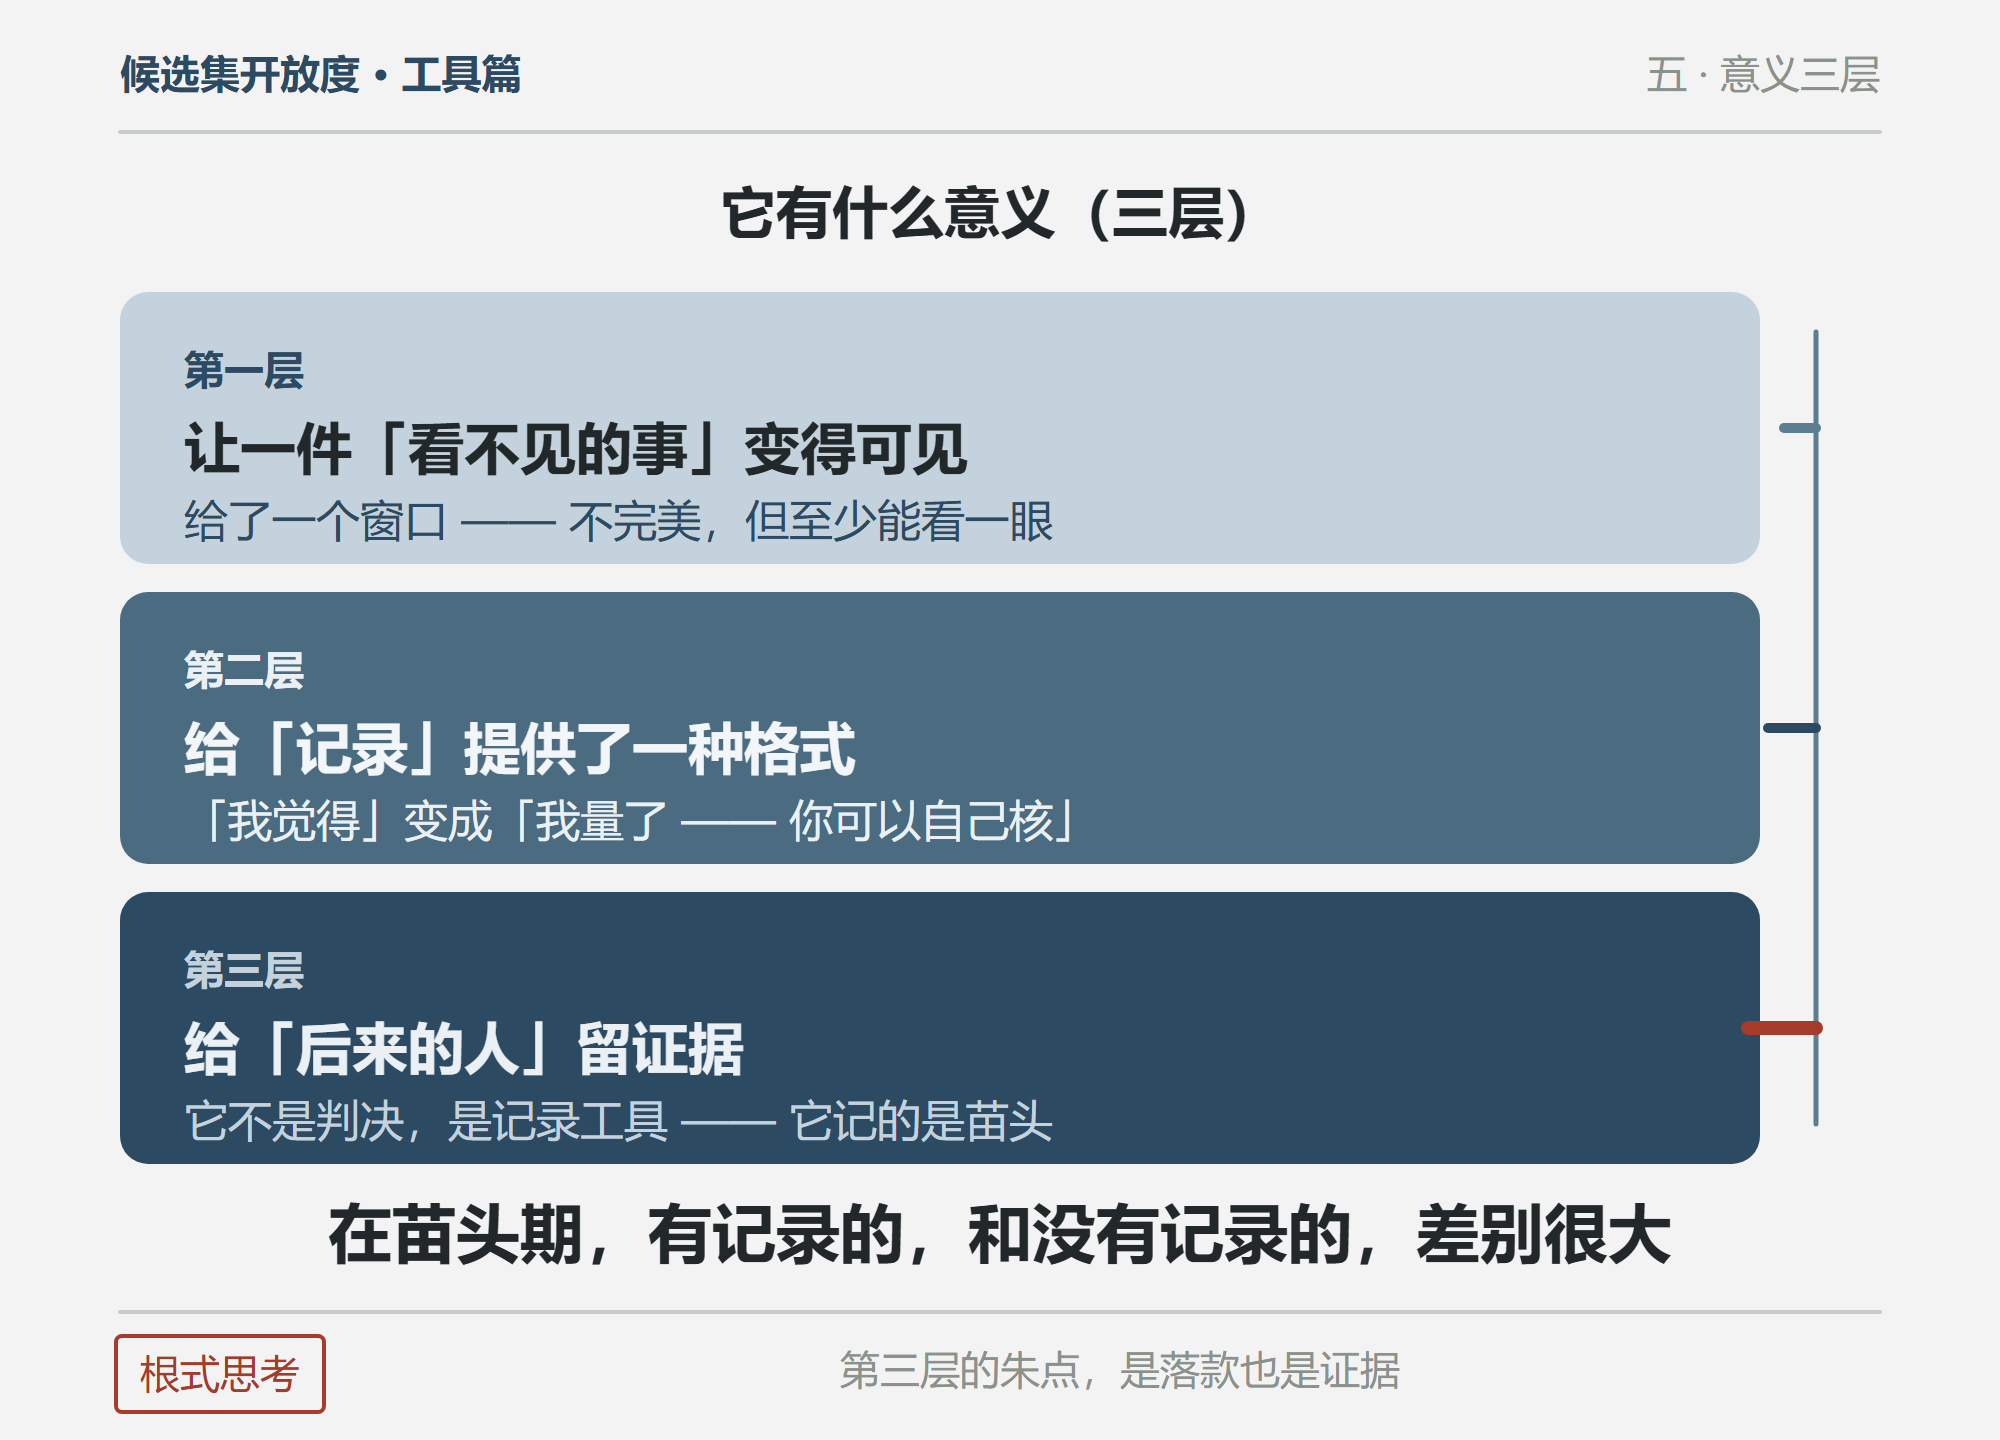
第一层:它让一件"看不见的事"变得可见
★★ 推荐系统的候选池,对普通用户是完全不透明的。这把尺子给了一个窗口 —— 不完美,但至少能看一眼。
第二层:它给"记录"提供了一种格式
★★★ 大多数关于推荐公平的讨论,都停留在"我觉得" —— "我觉得平台在推自己家的""我觉得 AI 被商业化了"。
这把尺子提供的是:一个可复算的数,和一套说清"我是怎么算出来的"的格式。
⇒ "我觉得"变成"我量了,数是这个,口径是这个,你可以自己核"。
★★ 这个转变的意义,远远超过数本身 —— 因为它让讨论有了共同的参照。
第三层:它是给"后来的人"留的证据
★★ 今天 AI 推荐商业化到什么程度,可能还没有明确的结论。但十年后回头看,"当时是什么样的",需要有记录。
★ 这把尺子不是判决,是记录工具** —— 它记的是苗头。
⇒ 而在苗头期,有记录的,和没有记录的,差别很大。
六、它不是什么(这一节同样重要)
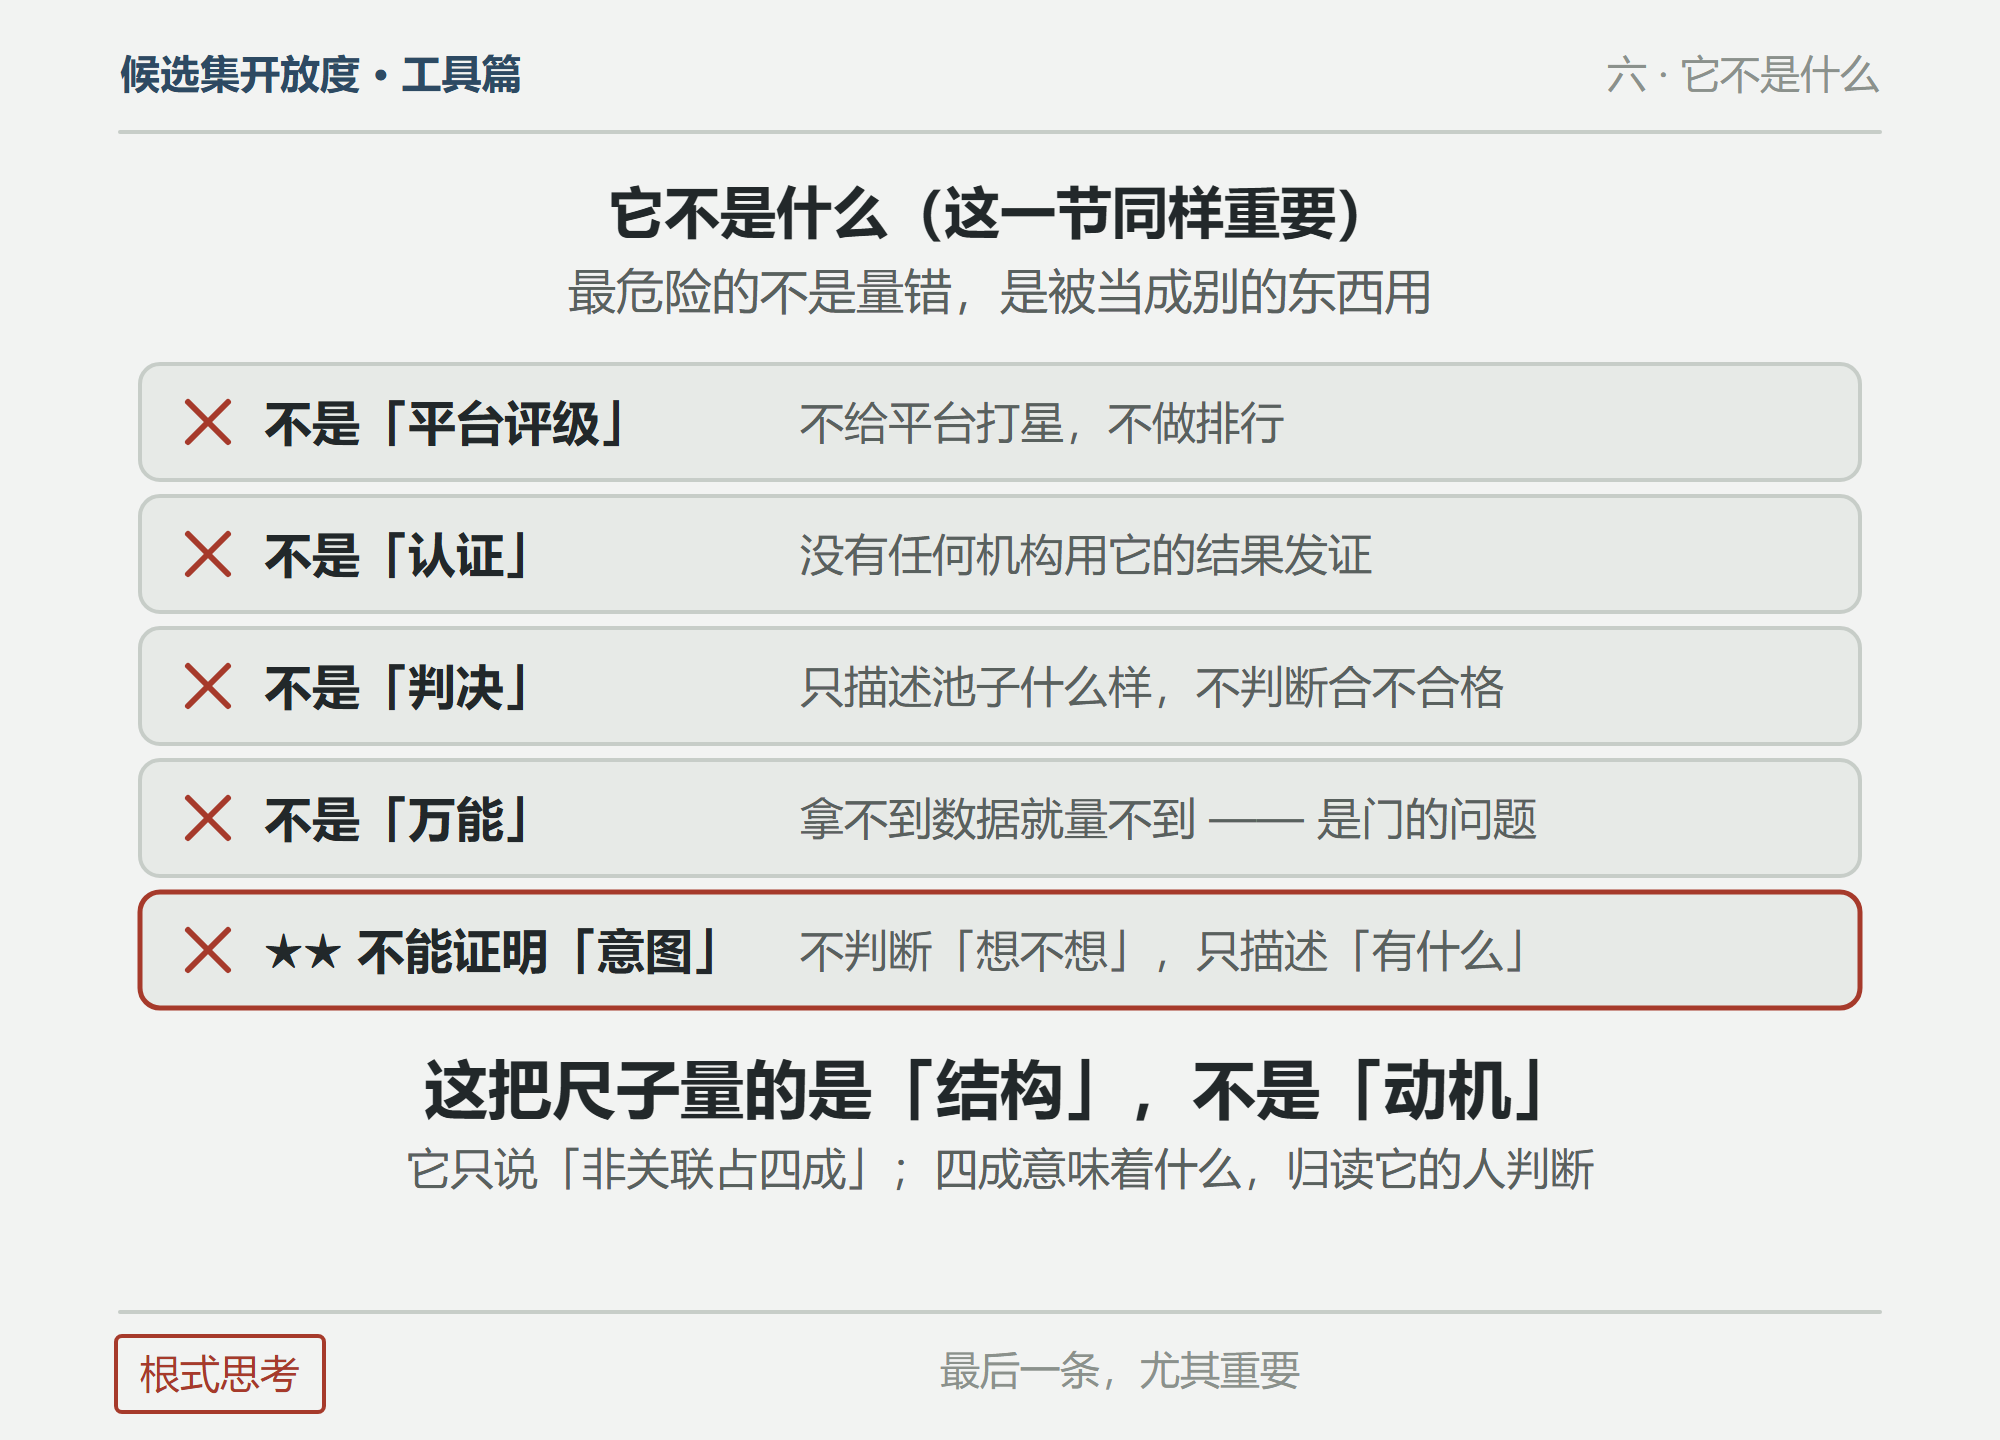
★★ 任何一把尺子,最危险的不是量错,是被当成别的东西用。所以下面这些,必须说清:
| 它不是 | 说明 |
|---|---|
| ★ 不是平台评级工具 | ★ 它不给平台打星,不做排行 |
| ★ 不是认证 | ★ 没有任何机构用它的结果发证 |
| ★ 不是判决 | ★ 它只描述"这个池子是什么样的",不判断"这合不合格" |
| ★ 不是万能 | ★ 它拿不到数据,就量不到东西 —— 这是门的问题,不是尺子的问题 |
| ★★ 不能证明"意图" | ★★ 它不判断平台"想不想"这么做,只描述"候选里有什么" |
★★★ 最后一条尤其重要:这把尺子量的是结构,不是动机。它不会说"某平台在作恶",它只说"这批候选里,非关联的占四成"。
至于这四成意味着什么,归读它的人判断。
七、用之前要知道的三件事(诚实交代)
★ 任何工具的说明书,都该有这一节。
第一件:它需要取数,而取数有门槛。
这把尺子不负责"怎么拿到候选"。取数的方式、合规性,由使用者自行负责。 如果你拿不到数据,这把尺子帮不了你。
第二件:它的判定标准里,"疑似"这一档还在完善。
"什么样的旁证算疑似付费",目前还没有一个公认的硬标准。这个空会在后续版本里补——在补上之前,请把它当作一个提示,而不是一个结论。
第三件:如果使用者的取数方式和入口方有利益关系,读数要降级。
这套尺子要求使用者如实申报这种关系。申报了,读数会被标注为"参考"——因为一个跟入口方有关系的测量者,测出来的数,别人有权打个问号。
八、一句话
★★ 这把尺子做的事情很小:它只算一个比例。
★★★ 但它想做的事情不小:
在"推荐由谁决定"这件事上,让人们至少能看一眼——而且这一眼,是可以通过核对验证的。
它不承诺改变什么。它只是把一件原本看不见的事,变成可以被记录、被核对的东西。
★ 而"能被记录",往往是"能被讨论"的第一步。
关于这份件
· 口径版本:候选集开放度 v2.1
· 口径指纹:由口径内容自动生成(每次运行会输出)
· 许可:建议采用宽松开源许可(使用者可自由使用、修改、再分发)
· 开源仓库:github.com/LiaoJim-hub/candidate-openness(MIT 许可 · 可运行原型 + 完整协议)
· 说明:本件是显化,不是标准。它提供测量方法,不提供判定主体。
思考位:M1 M3 M4 A3 S1(层依据:「候选集开放度尺子,写一篇文章,使用说明和作用意义之类的」 · 层:事+明* · 位来源:层选 · 自检:未触发 · 锚:3/3)
显化声明:本回答是显化,不是根。文章按发布件体例写,含"它不是什么"与"用前须知"两节(如实交代限度);"疑似"判定标准未定、取数合规由使用者自担两点已标注;发布与否、如何改稿归你。材料:无(纯对话任务)