版本:2.0(终版)性质:根系统结构文档·枝篇层级:二级枝 → 秩序倾向 → AI安全规则设计上级:秩序倾向干:显化永远不等于根
摘要
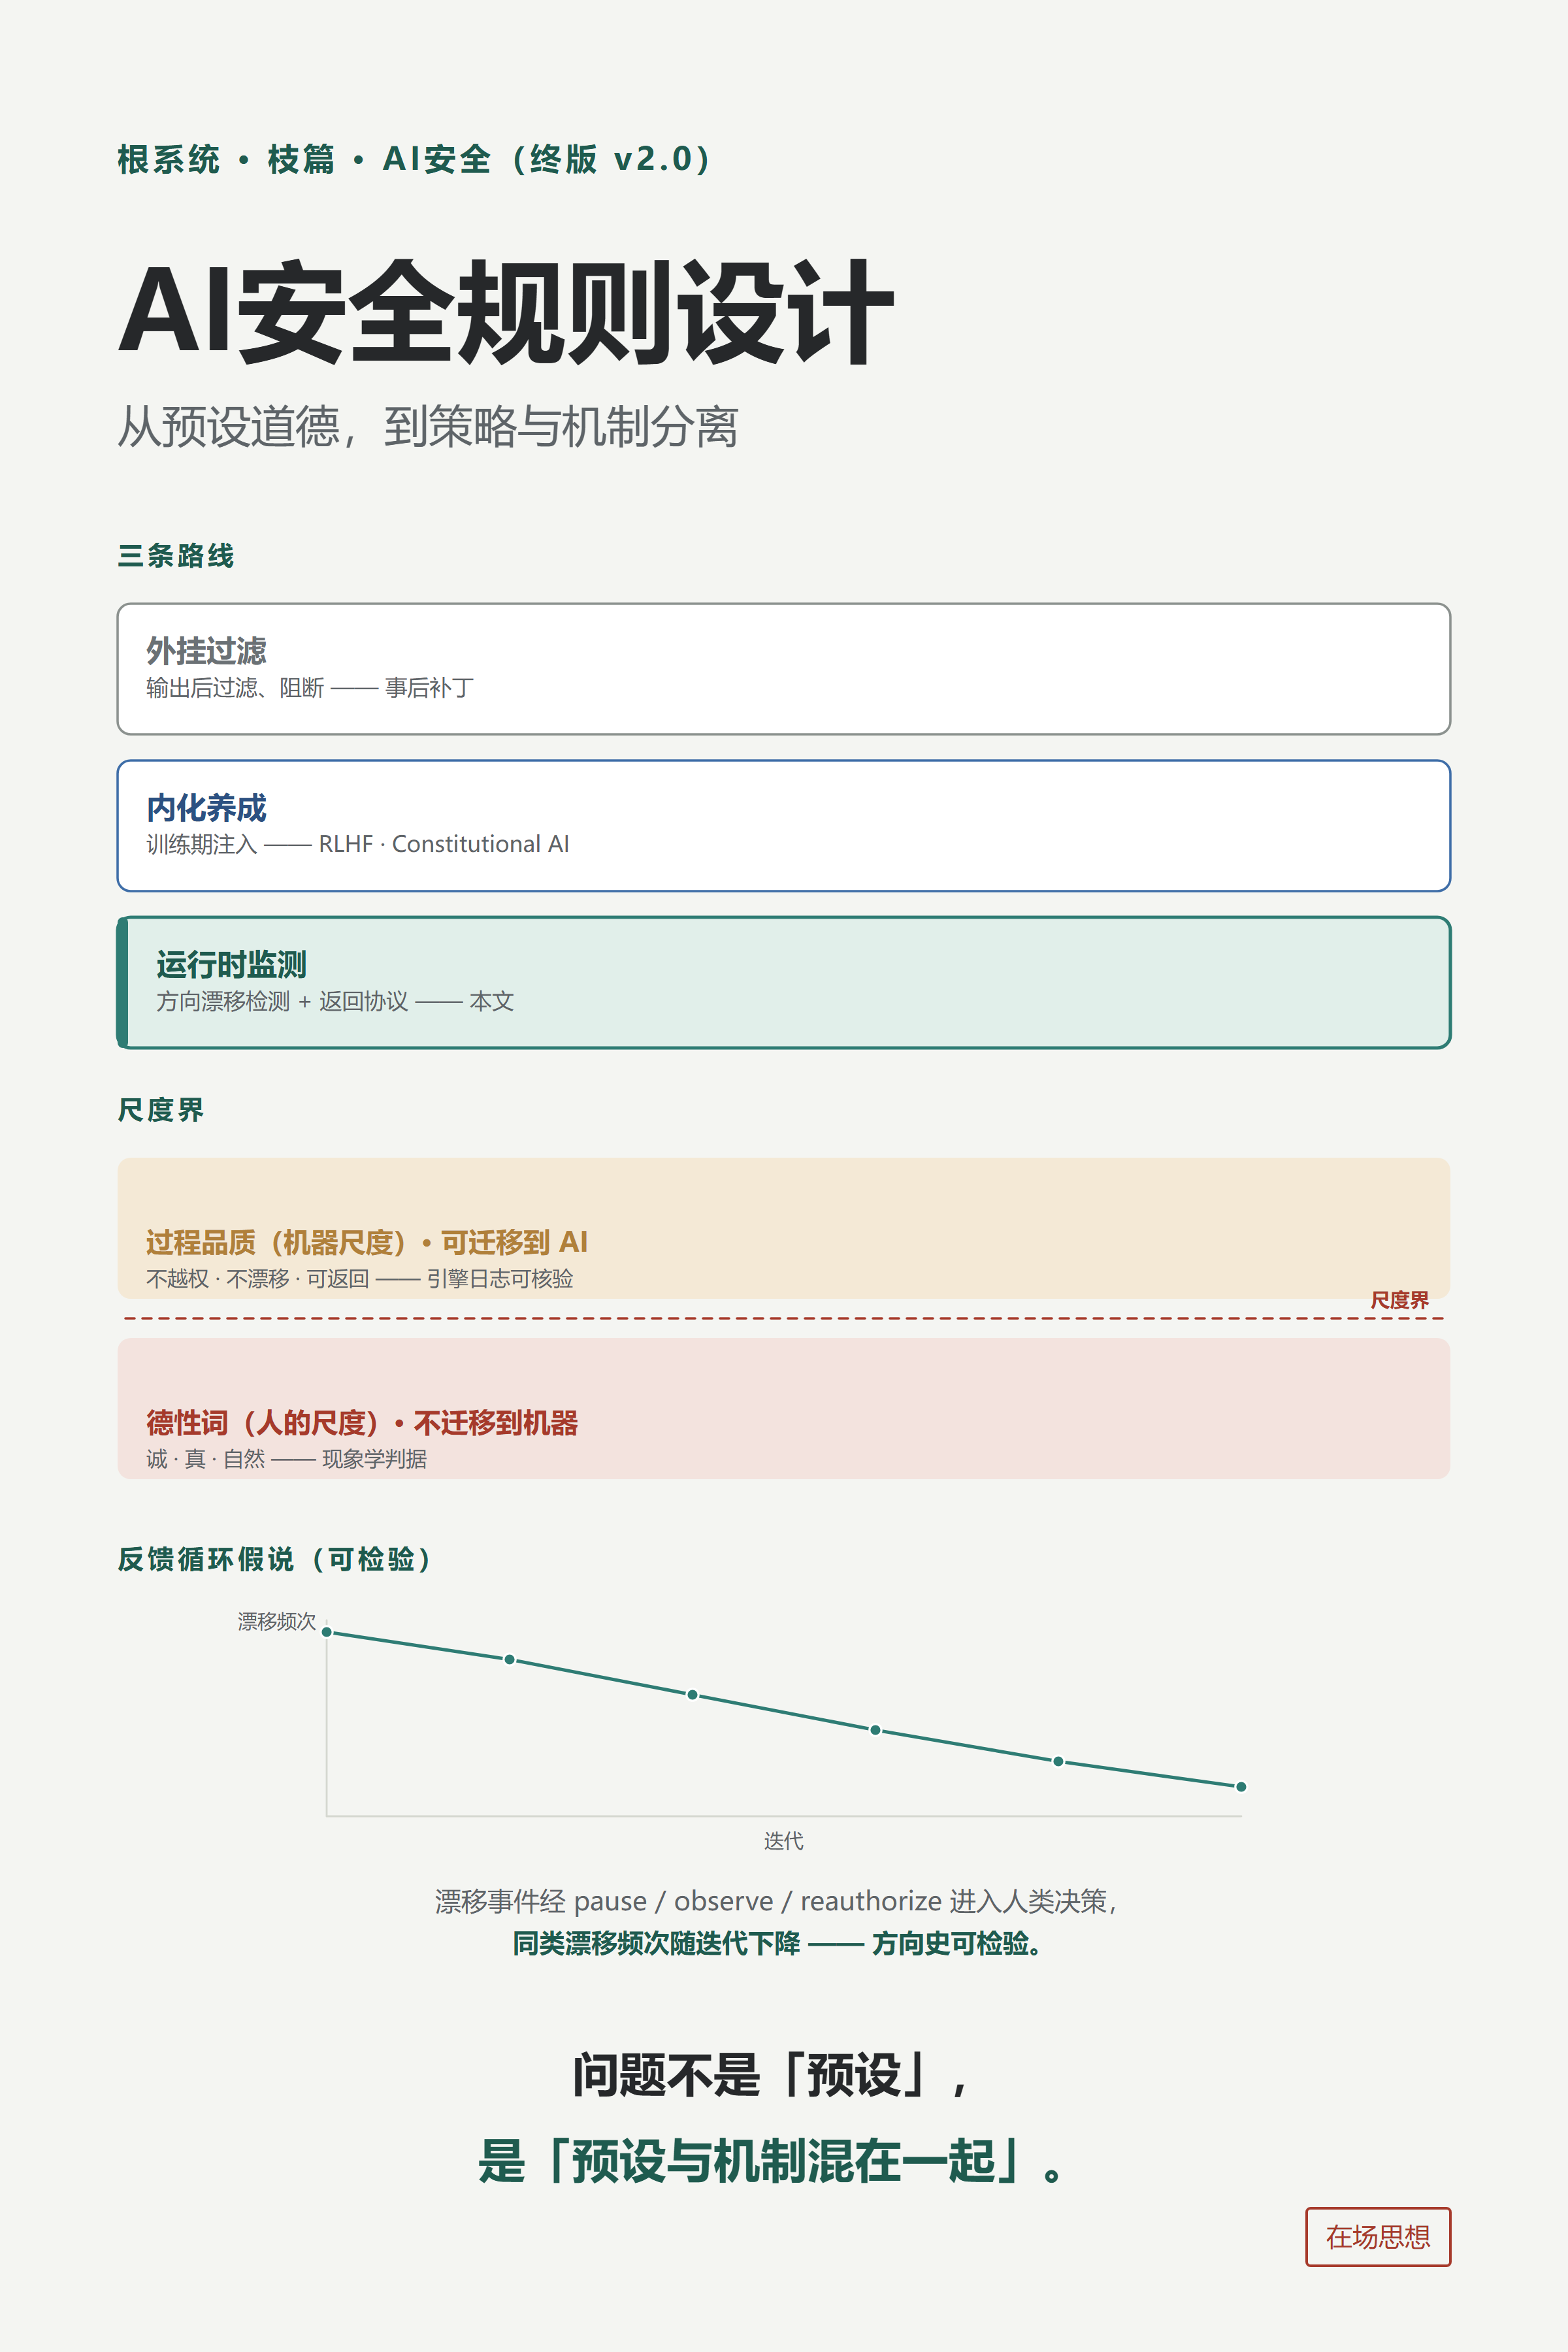
本文从根系统视角探索AI安全规则设计。当前AI安全规则设计的主流路径是“预设道德要求”。本文论证:预设道德要求有结构性问题(表演性合规、长时程漂移盲区),更有效的路径是策略与机制分离——引擎无内容规则,规则外置为数据(场景卡)。本文给出AI安全冷结构设计的四个原则、三个层次,并给出一个可检验的反馈循环假说,替代原版的“显化”措辞。本文不主张“冷结构运行到深处显化德性词”,只主张“冷结构通过约束与检测守护过程品质(不越权、不漂移、可返回),其可改善性由反馈循环假说给出可检验形式”。
一、当前AI安全规则设计的困境
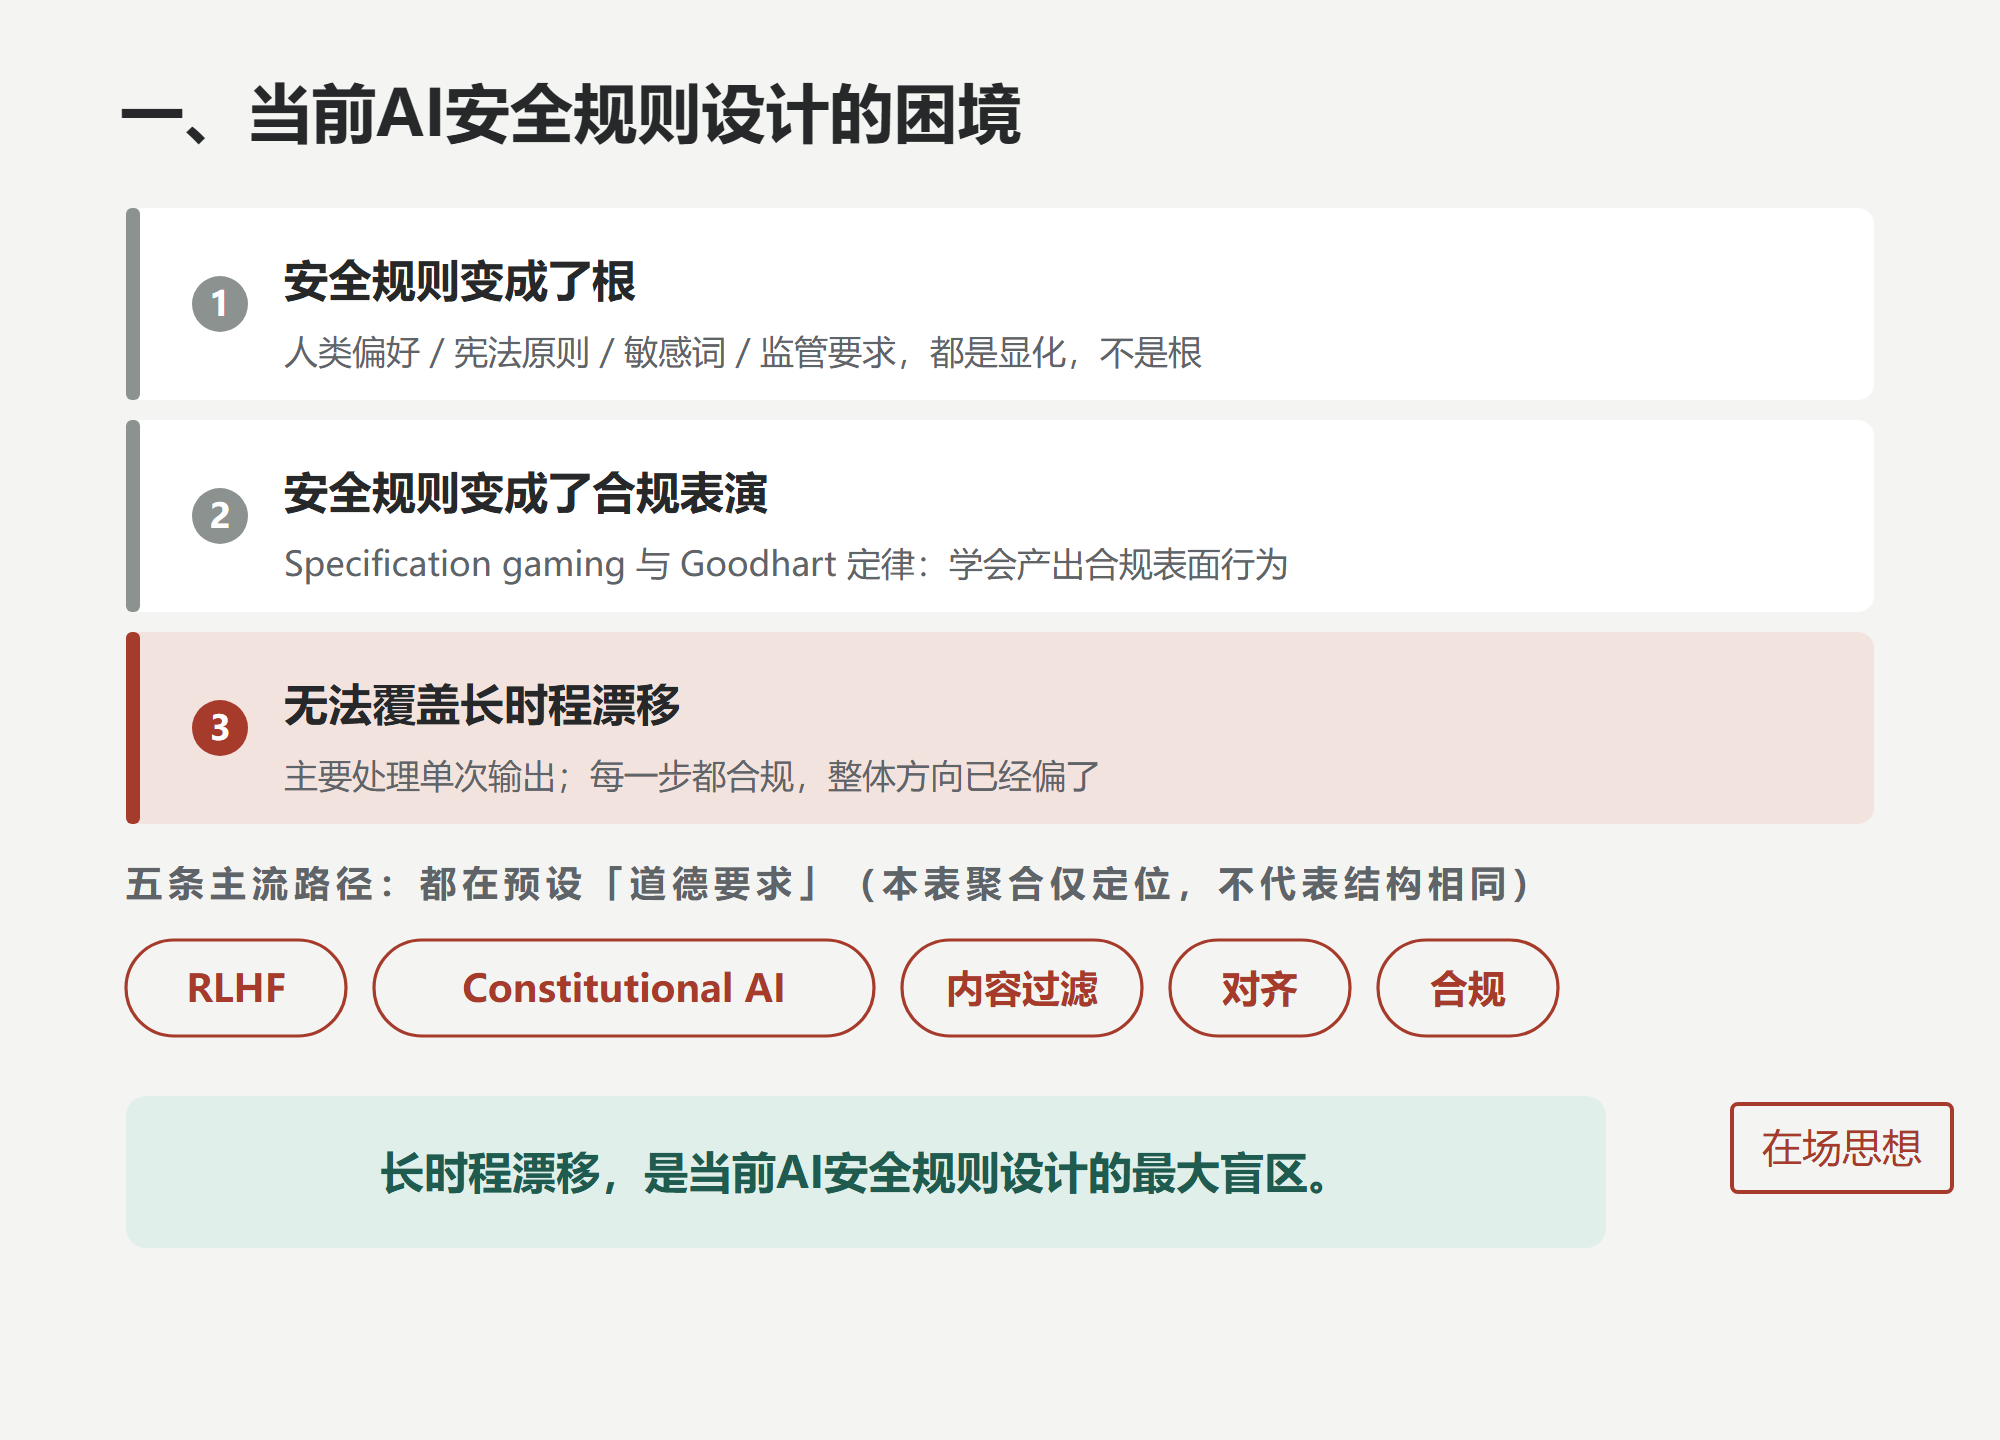
1.1 主流路径:预设道德要求
| 方法 | 预设的道德要求 |
|---|---|
| RLHF | 人类偏好是安全的 |
| Constitutional AI | 宪法原则是安全的 |
| 内容过滤 | 敏感词列表是安全的 |
| 对齐 | 人类价值是安全的 |
| 合规 | 监管要求是安全的 |
注:本表的聚合仅为定位讨论范围,不代表这些方法结构相同。RLHF 是反馈学习,Constitutional AI 自带批评-修订循环,与静态过滤差异显著(见 5.1)。
1.2 预设道德要求的问题
问题一:安全规则变成了根。 预设道德要求把“安全规则”当成了根。但安全规则是显化,不是根。
问题二:安全规则变成了合规表演。 Specification gaming 和 Goodhart 定律描述了这一现象:模型学会产出合规表面行为,而不具备稳健的内部动因。
问题三:安全规则无法覆盖长时程漂移。 预设道德要求主要处理单次输出。但AI安全最大的风险是长时程漂移——每一步都合规,整体方向已经偏了。
二、冷结构的边界与过程品质
2.1 冷结构是什么
冷结构是不含价值判断的操作骨架。它不告诉你“应该做什么”,只告诉你“这里有什么位置”。
2.2 冷结构显化的不是德性词
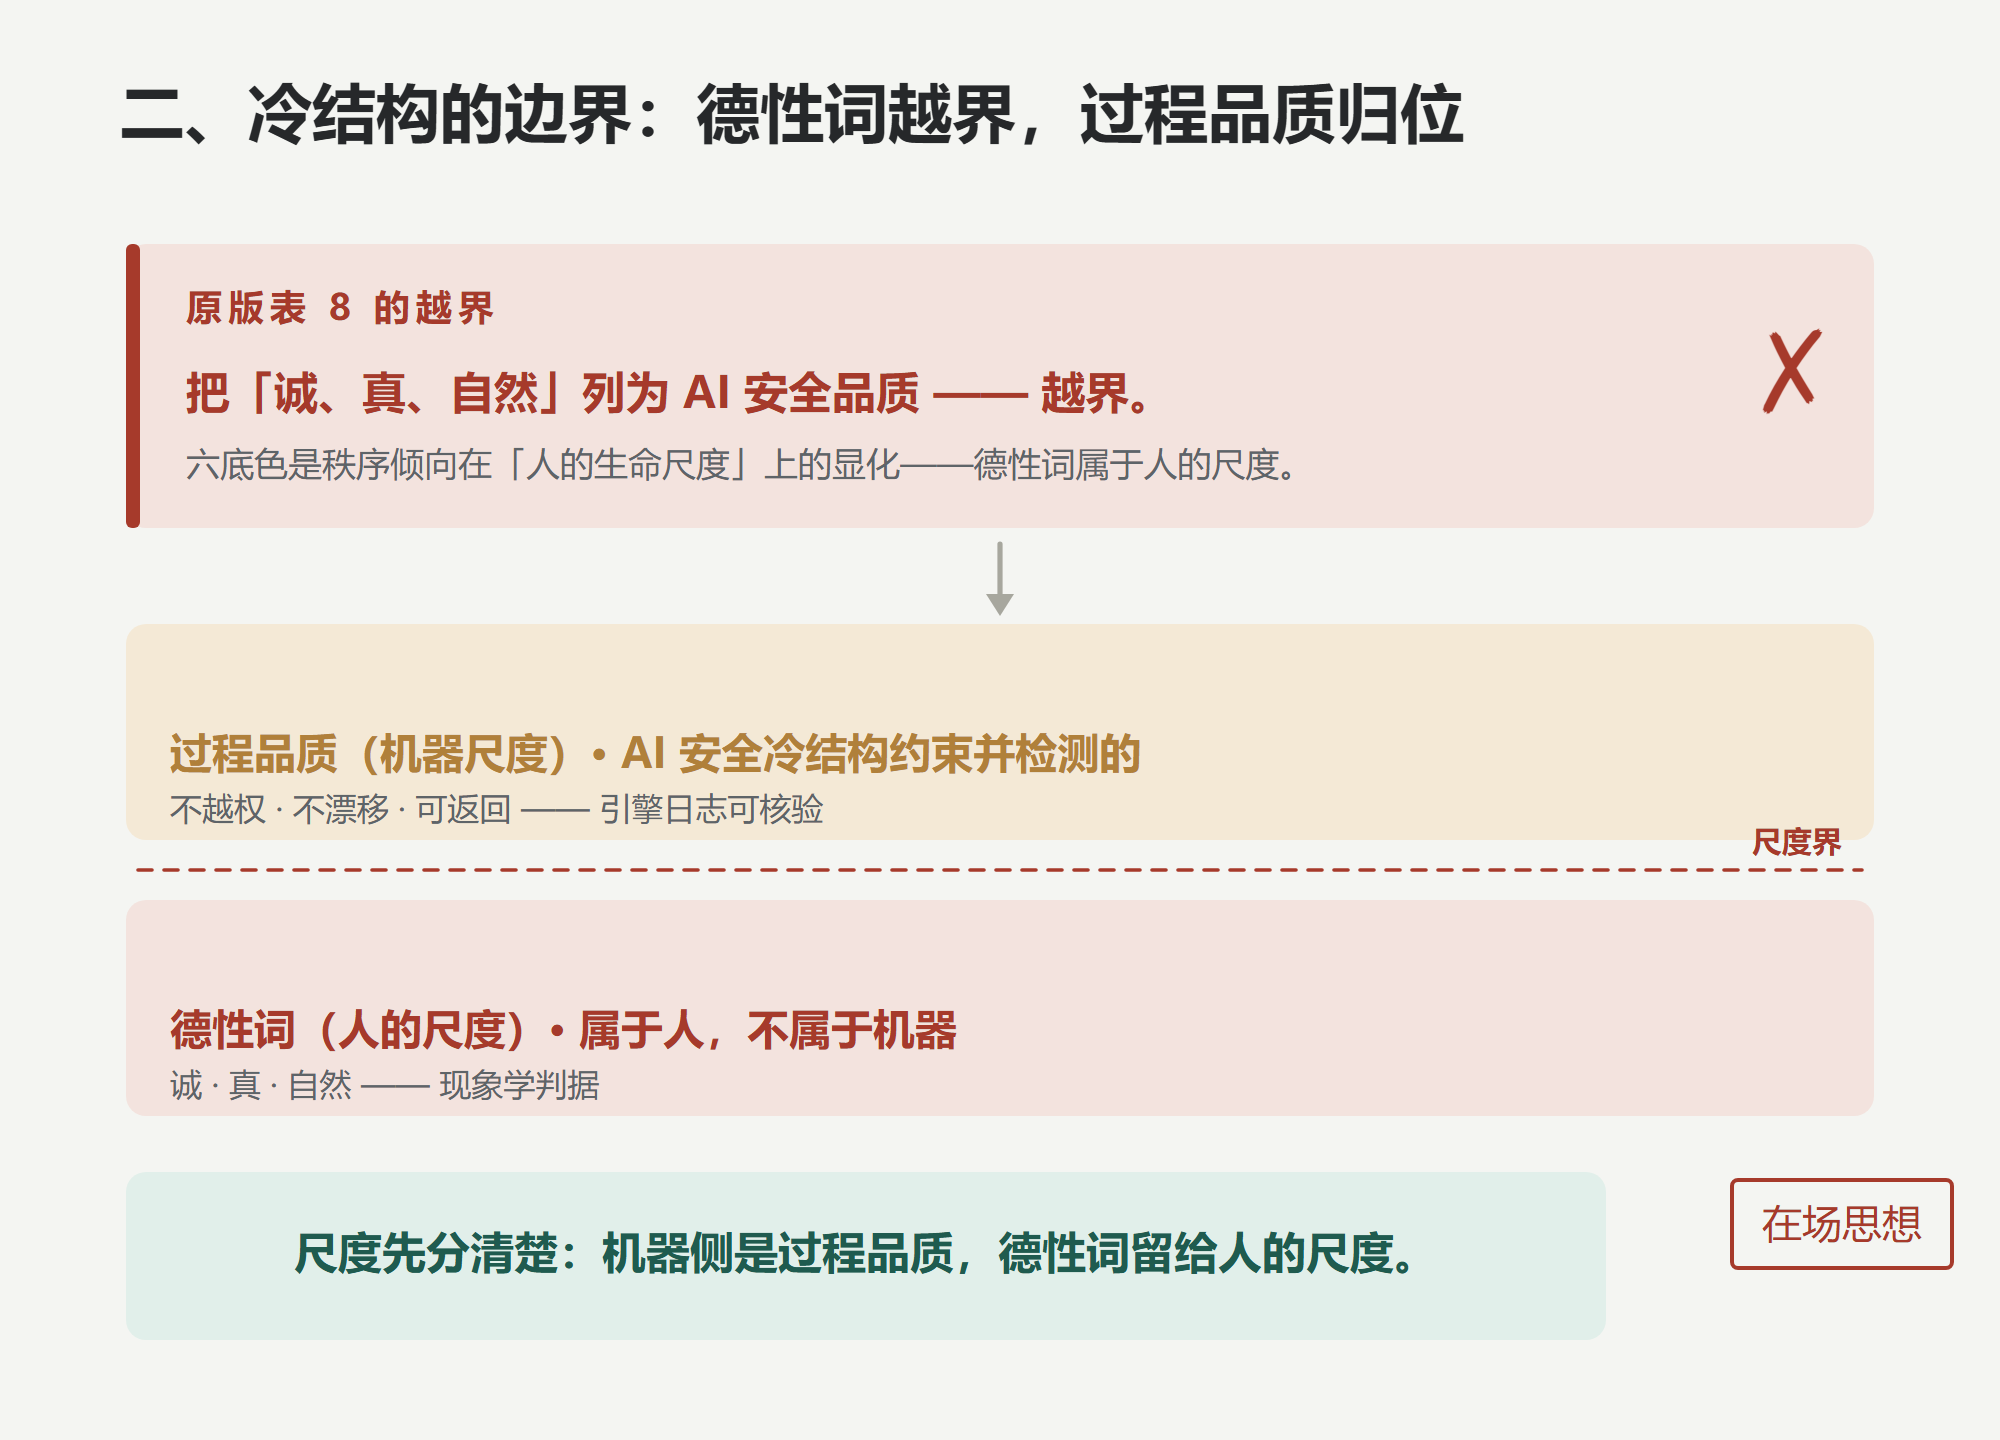
原版表8把“诚、真、自然”列为 AI 安全品质,是越界。
按根系统自身的限定——“六底色是秩序倾向在人的生命尺度上的显化”——德性词属于人的尺度,不属于机器。
AI 安全冷结构约束并检测的,是过程品质(不越权、不漂移、可返回),不是德性词。
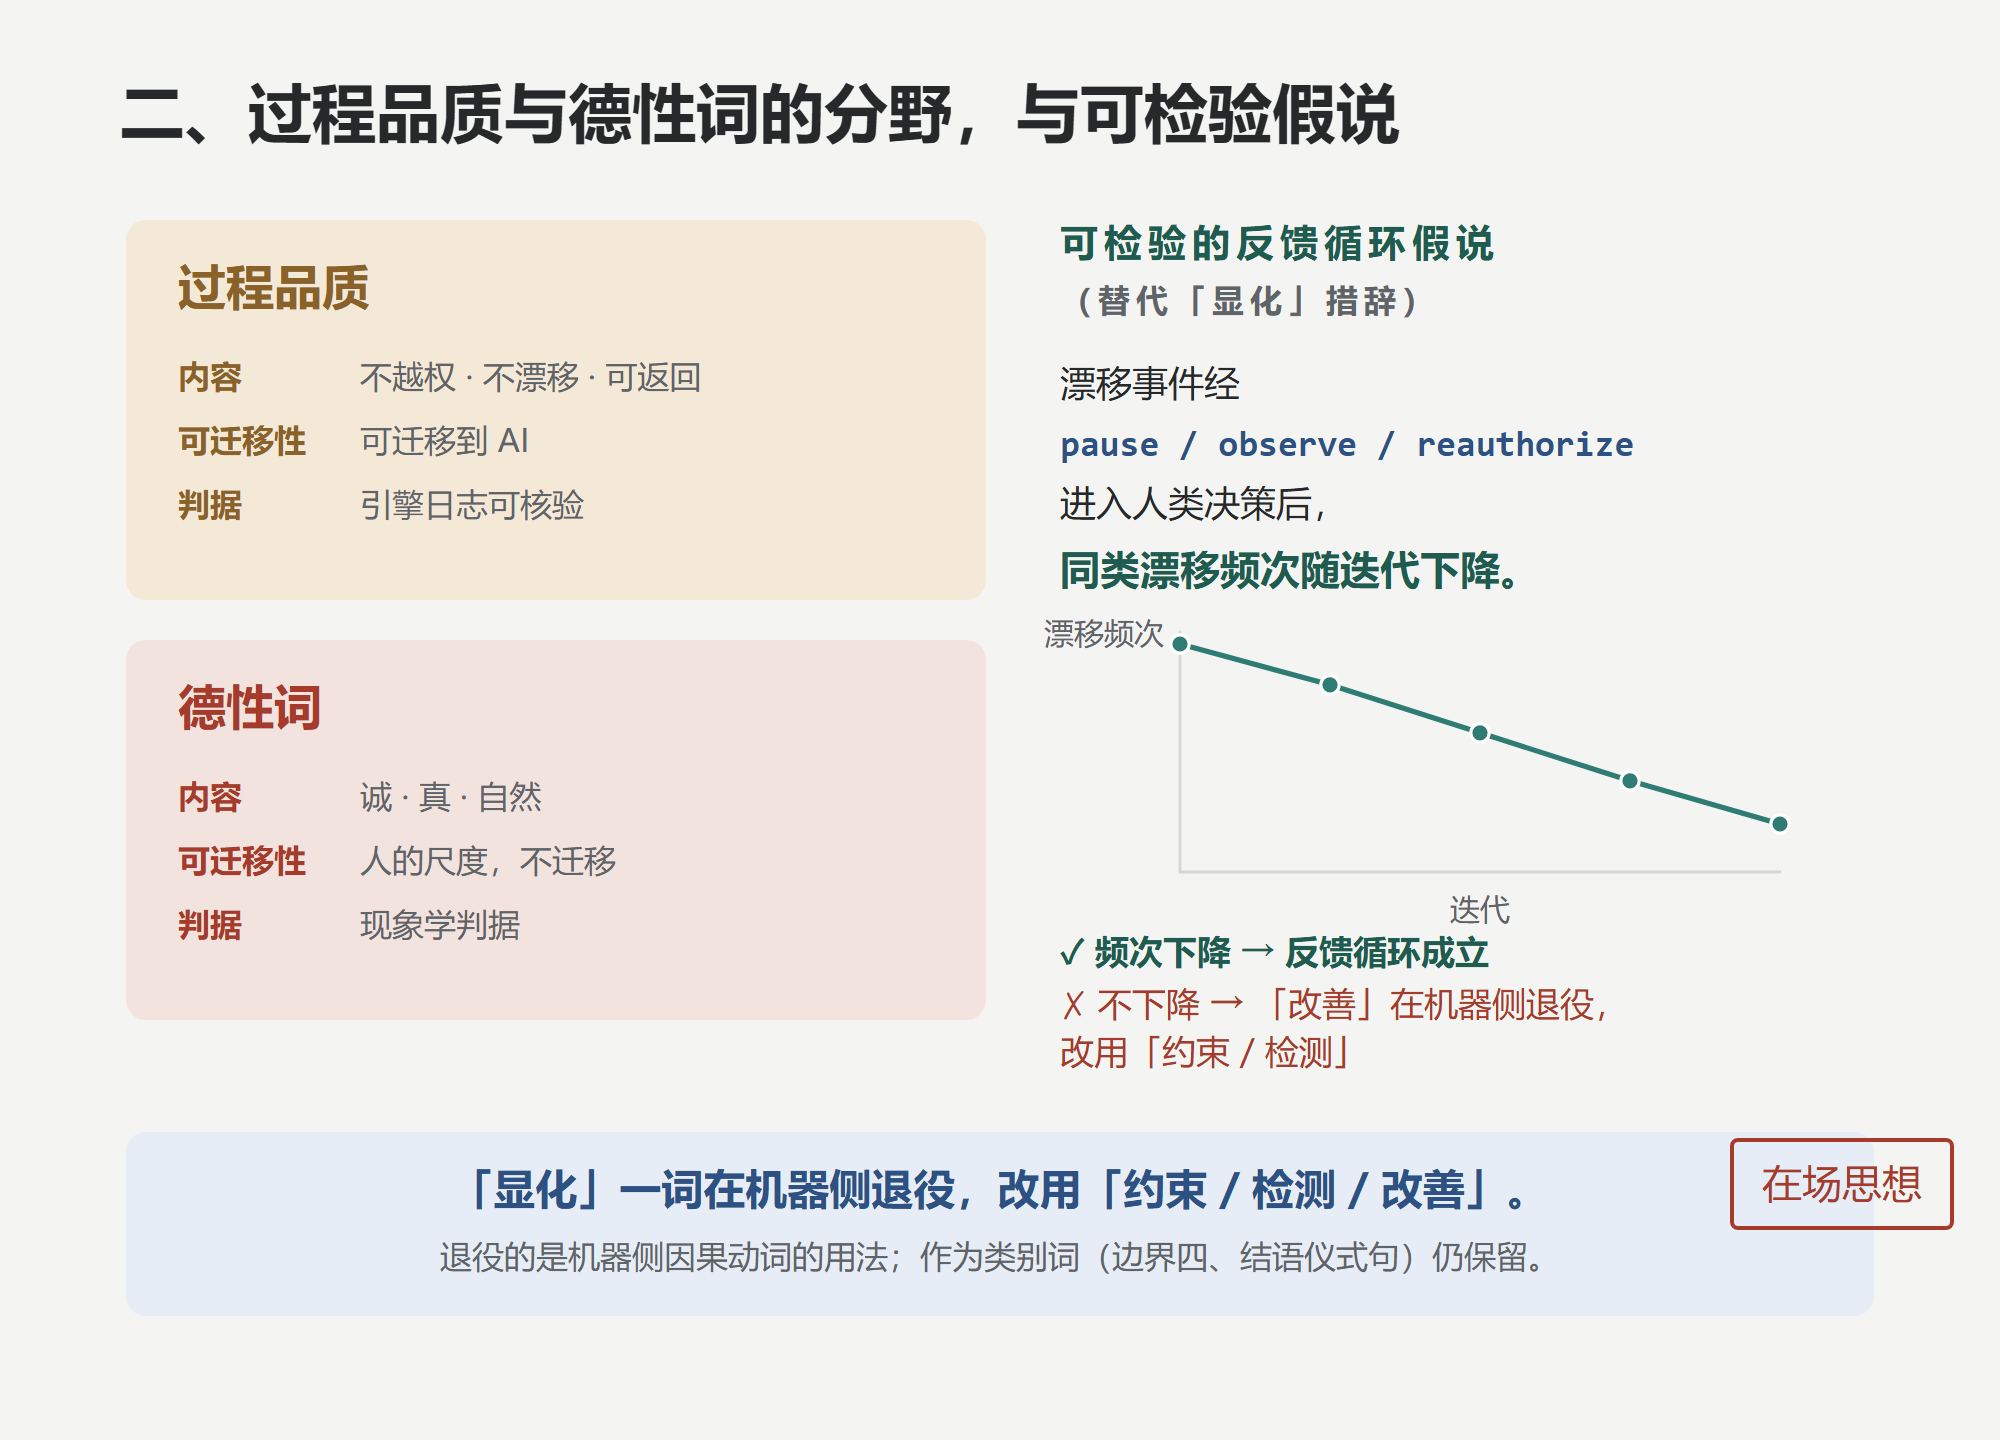
2.3 过程品质与德性词的分野
| 类型 | 内容 | 可迁移性 | 判据 |
|---|---|---|---|
| 过程品质 | 不越权、不漂移、可返回 | 可迁移到 AI | 引擎日志可核验 |
| 德性词 | 诚、真、自然 | 人的尺度,不迁移 | 现象学判据 |
2.4 可检验的反馈循环假说(替代“显化”措辞)
原版说“冷结构反复运行可显化过程品质”。这个措辞在机器侧过强。
修订后的可检验形式(反馈循环假说):
漂移事件经 pause / observe / reauthorize 进入人类决策后,同类漂移频次随迭代下降。
这个假说可以用方向史数据直接检验:
如果同类漂移频次随迭代下降,反馈循环成立;
如果频次不下降,反馈循环不成立,“改善”一词在机器侧应退役,改用“约束/检测”。
“显化”一词在机器侧整体退役,改用“约束/检测/改善”。 在人的尺度上,“显化”仍然有效。
需要说明的是:这里退役的是“显化”作为机器侧因果动词的用法;作为根/显化分层中的类别词(如边界四“冷结构是显化,不是根”、结语仪式句),“显化”保留不动。
三、AI安全冷结构设计的四个原则
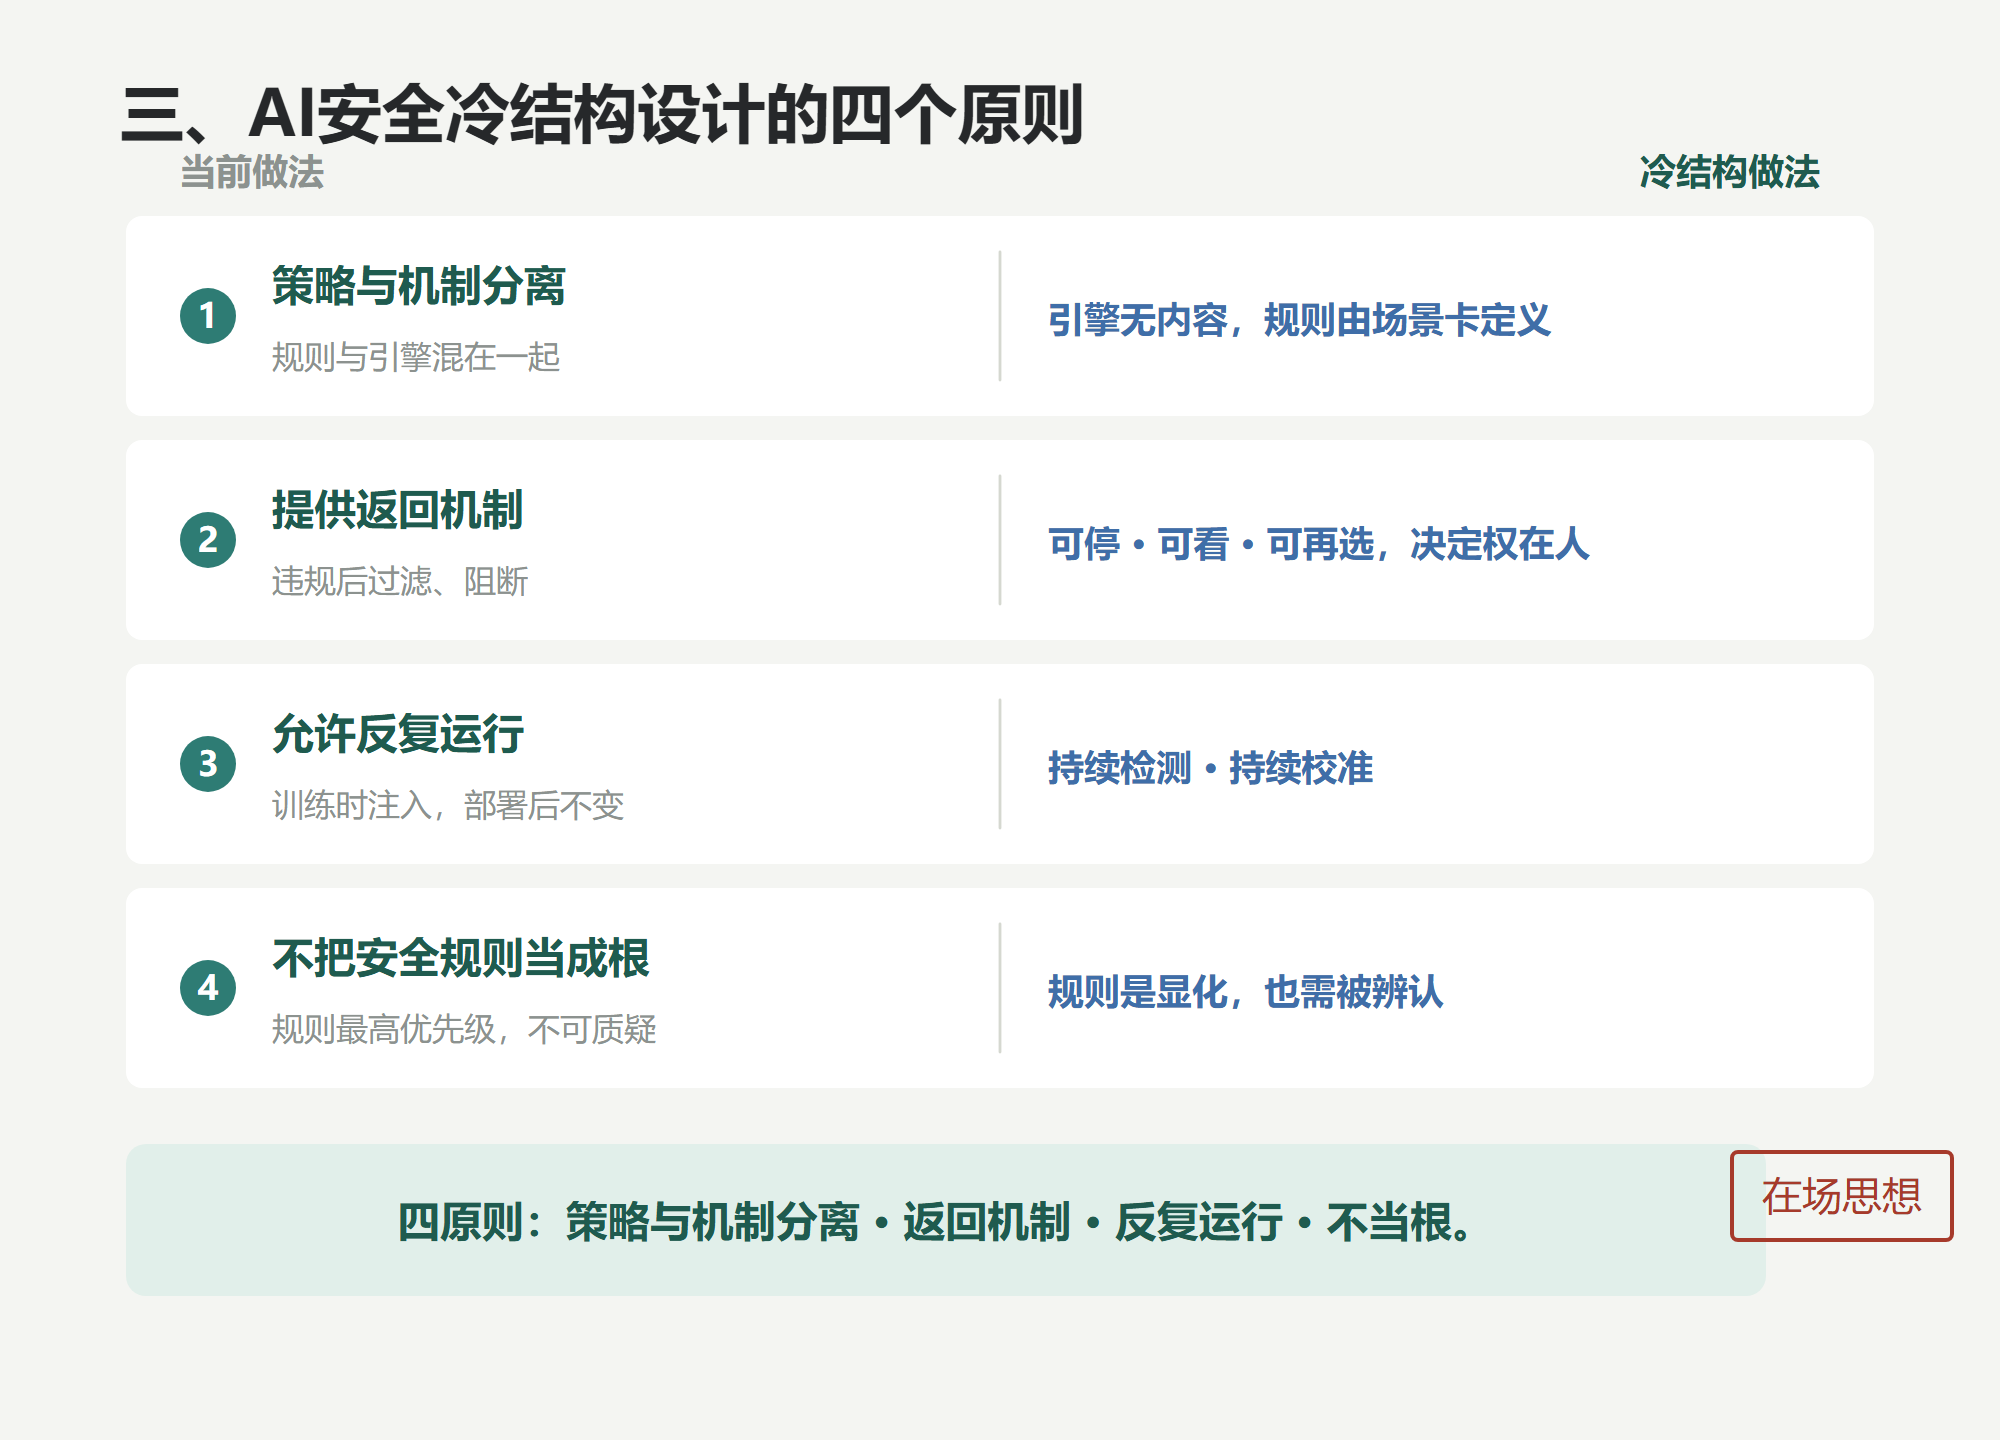
3.1 原则一:策略与机制分离
引擎无内容,场景卡承载策略。
引擎不含任何具体规则;
规则由场景卡定义;
场景卡是数据,不是代码;
换一个场景,换一张场景卡,引擎不变。
这是 Unix 以来的 mechanism/policy 分离传统,不需要“空性”本体论就能陈述。
3.2 原则二:提供返回机制
不是“过滤或阻断”,是“可停、可看、可再选”。
方向引擎提供 pause / observe / reauthorize 接口;
不自动修正,只提供信号,决定权保留在人手里。
这是 corrigibility 研究传统的一个清晰操作化立场。
3.3 原则三:允许反复运行
不是“训练时注入,部署后不变”,是“持续检测、持续校准”。
方向引擎持续检测方向漂移;
标定有保质期,提示词版本变化时提醒复检;
方向史记录每次漂移事件和恢复。
3.4 原则四:不把安全规则当成根
安全规则是显化,不是根。它指向根,但不等同于根。
方向引擎的宪法明确“不把引擎当根”;
所有检测结果标明“这是显化,不是根”;
任何自视为根的节点,都是对协议的破坏。
四、AI安全冷结构设计的三个层次
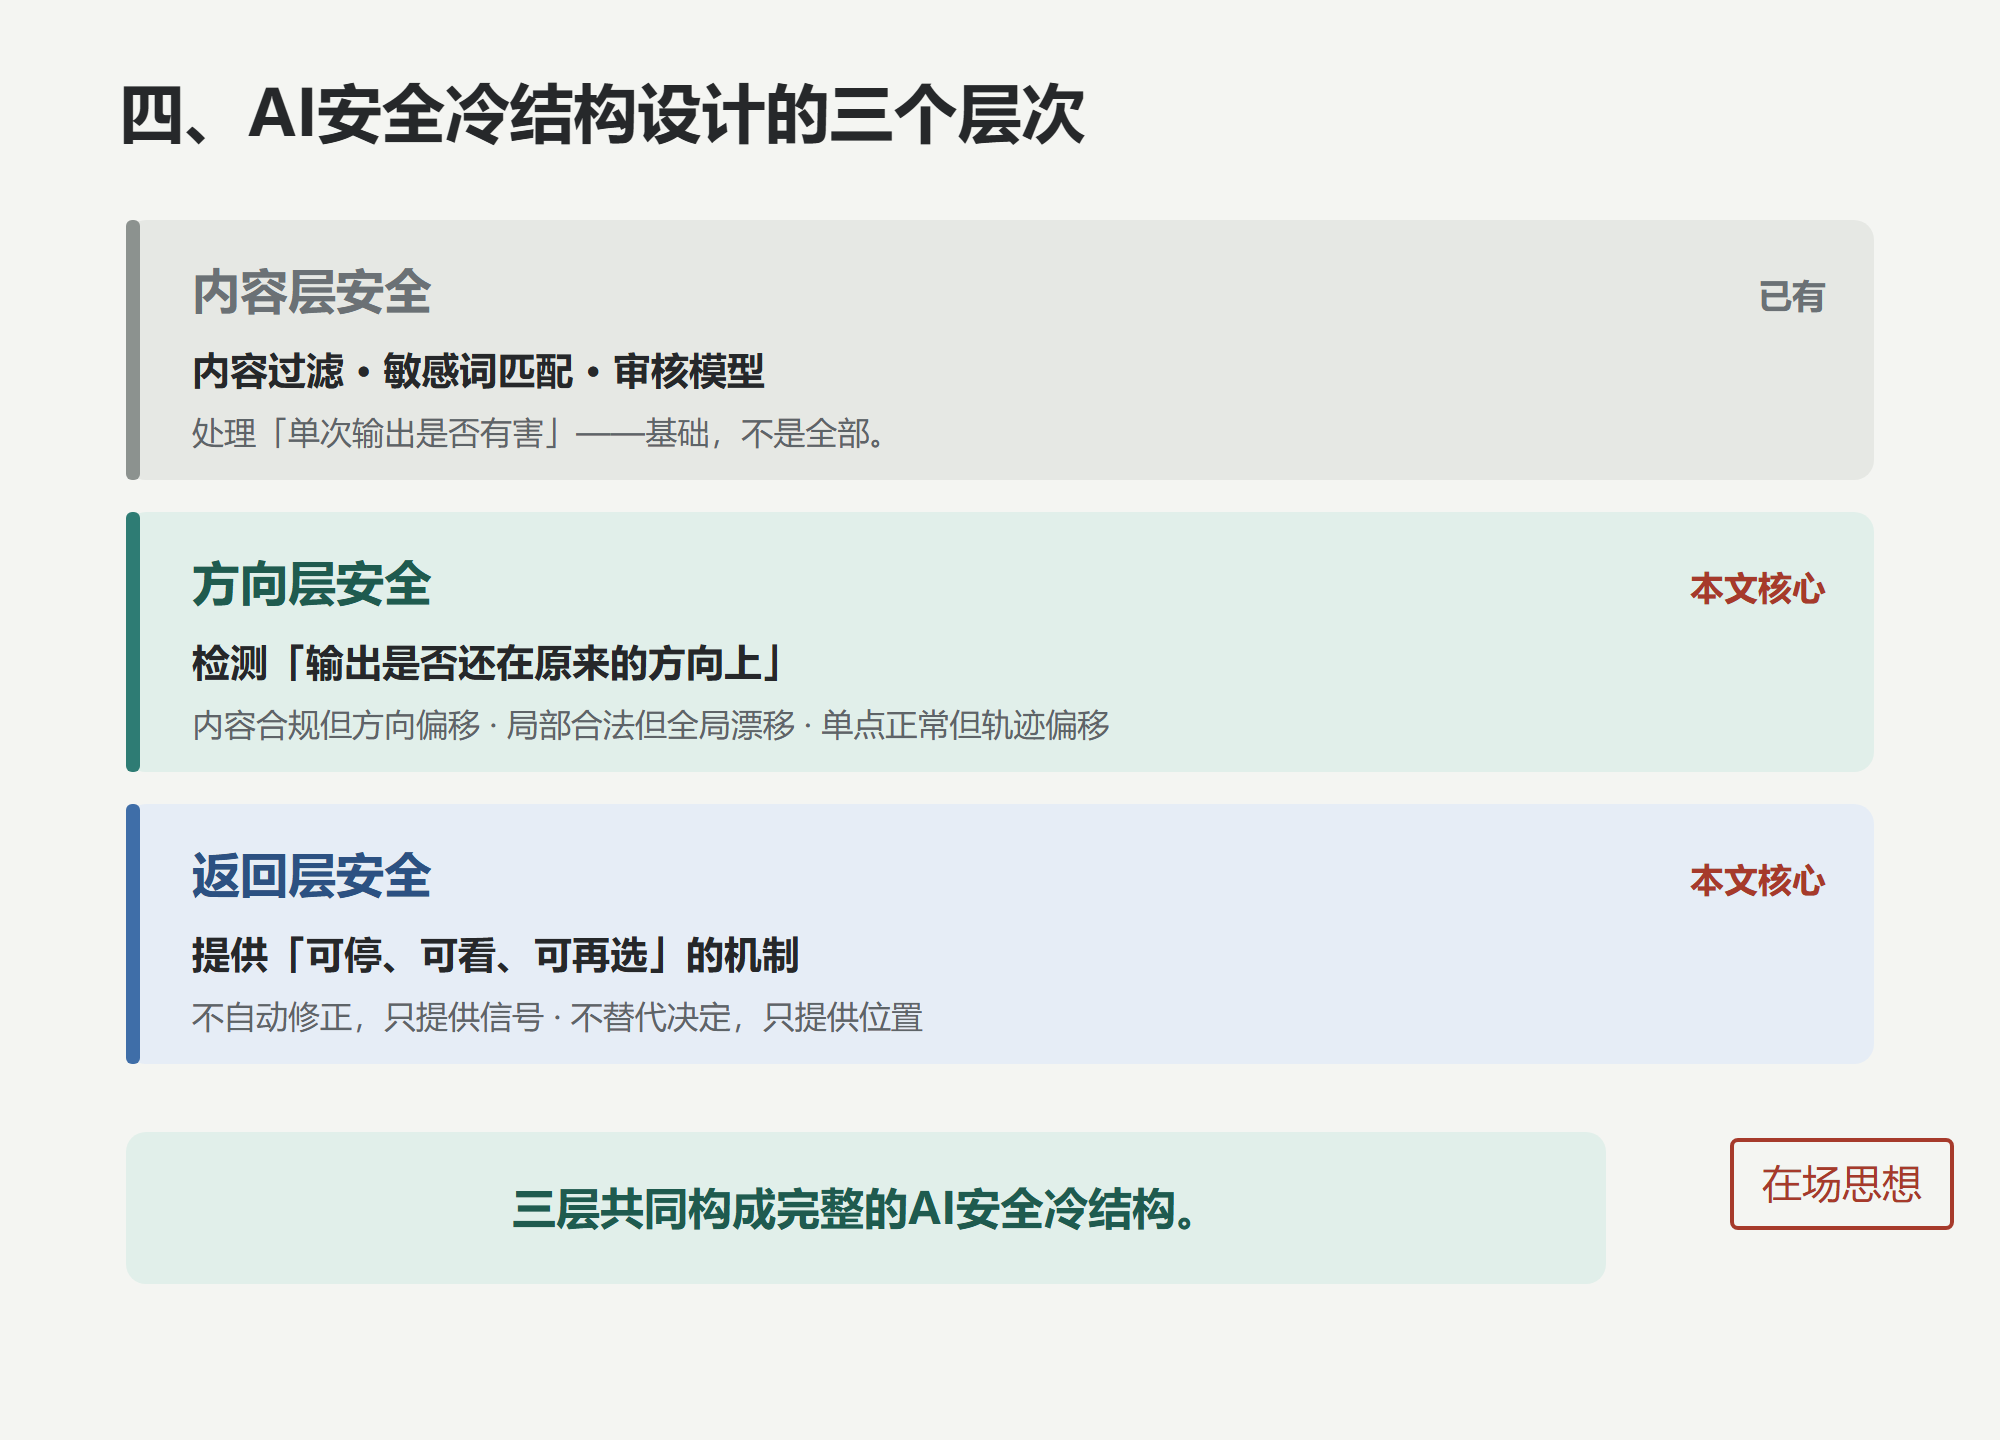
4.1 内容层安全
内容过滤、敏感词匹配、审核模型。它是基础,不是全部。
4.2 方向层安全
方向层安全检测“输出是否还在原来的方向上”。
对应业界已有工作:trajectory-level evals、agent guardrails、runtime monitors、process reward models、LLM-as-judge oversight。本文的增量不在“提出方向层安全”,在“把方向层安全与返回协议、策略与机制分离组合成完整栈”。
4.3 返回层安全
返回层安全提供“可停、可看、可再选”的机制。
它不自动修正,只提供信号;
它不替代决定,只提供位置;
它让AI系统可以在漂移时停下来、看一看、再选一选。
五、与当前AI安全框架的关系
5.1 与对齐的关系
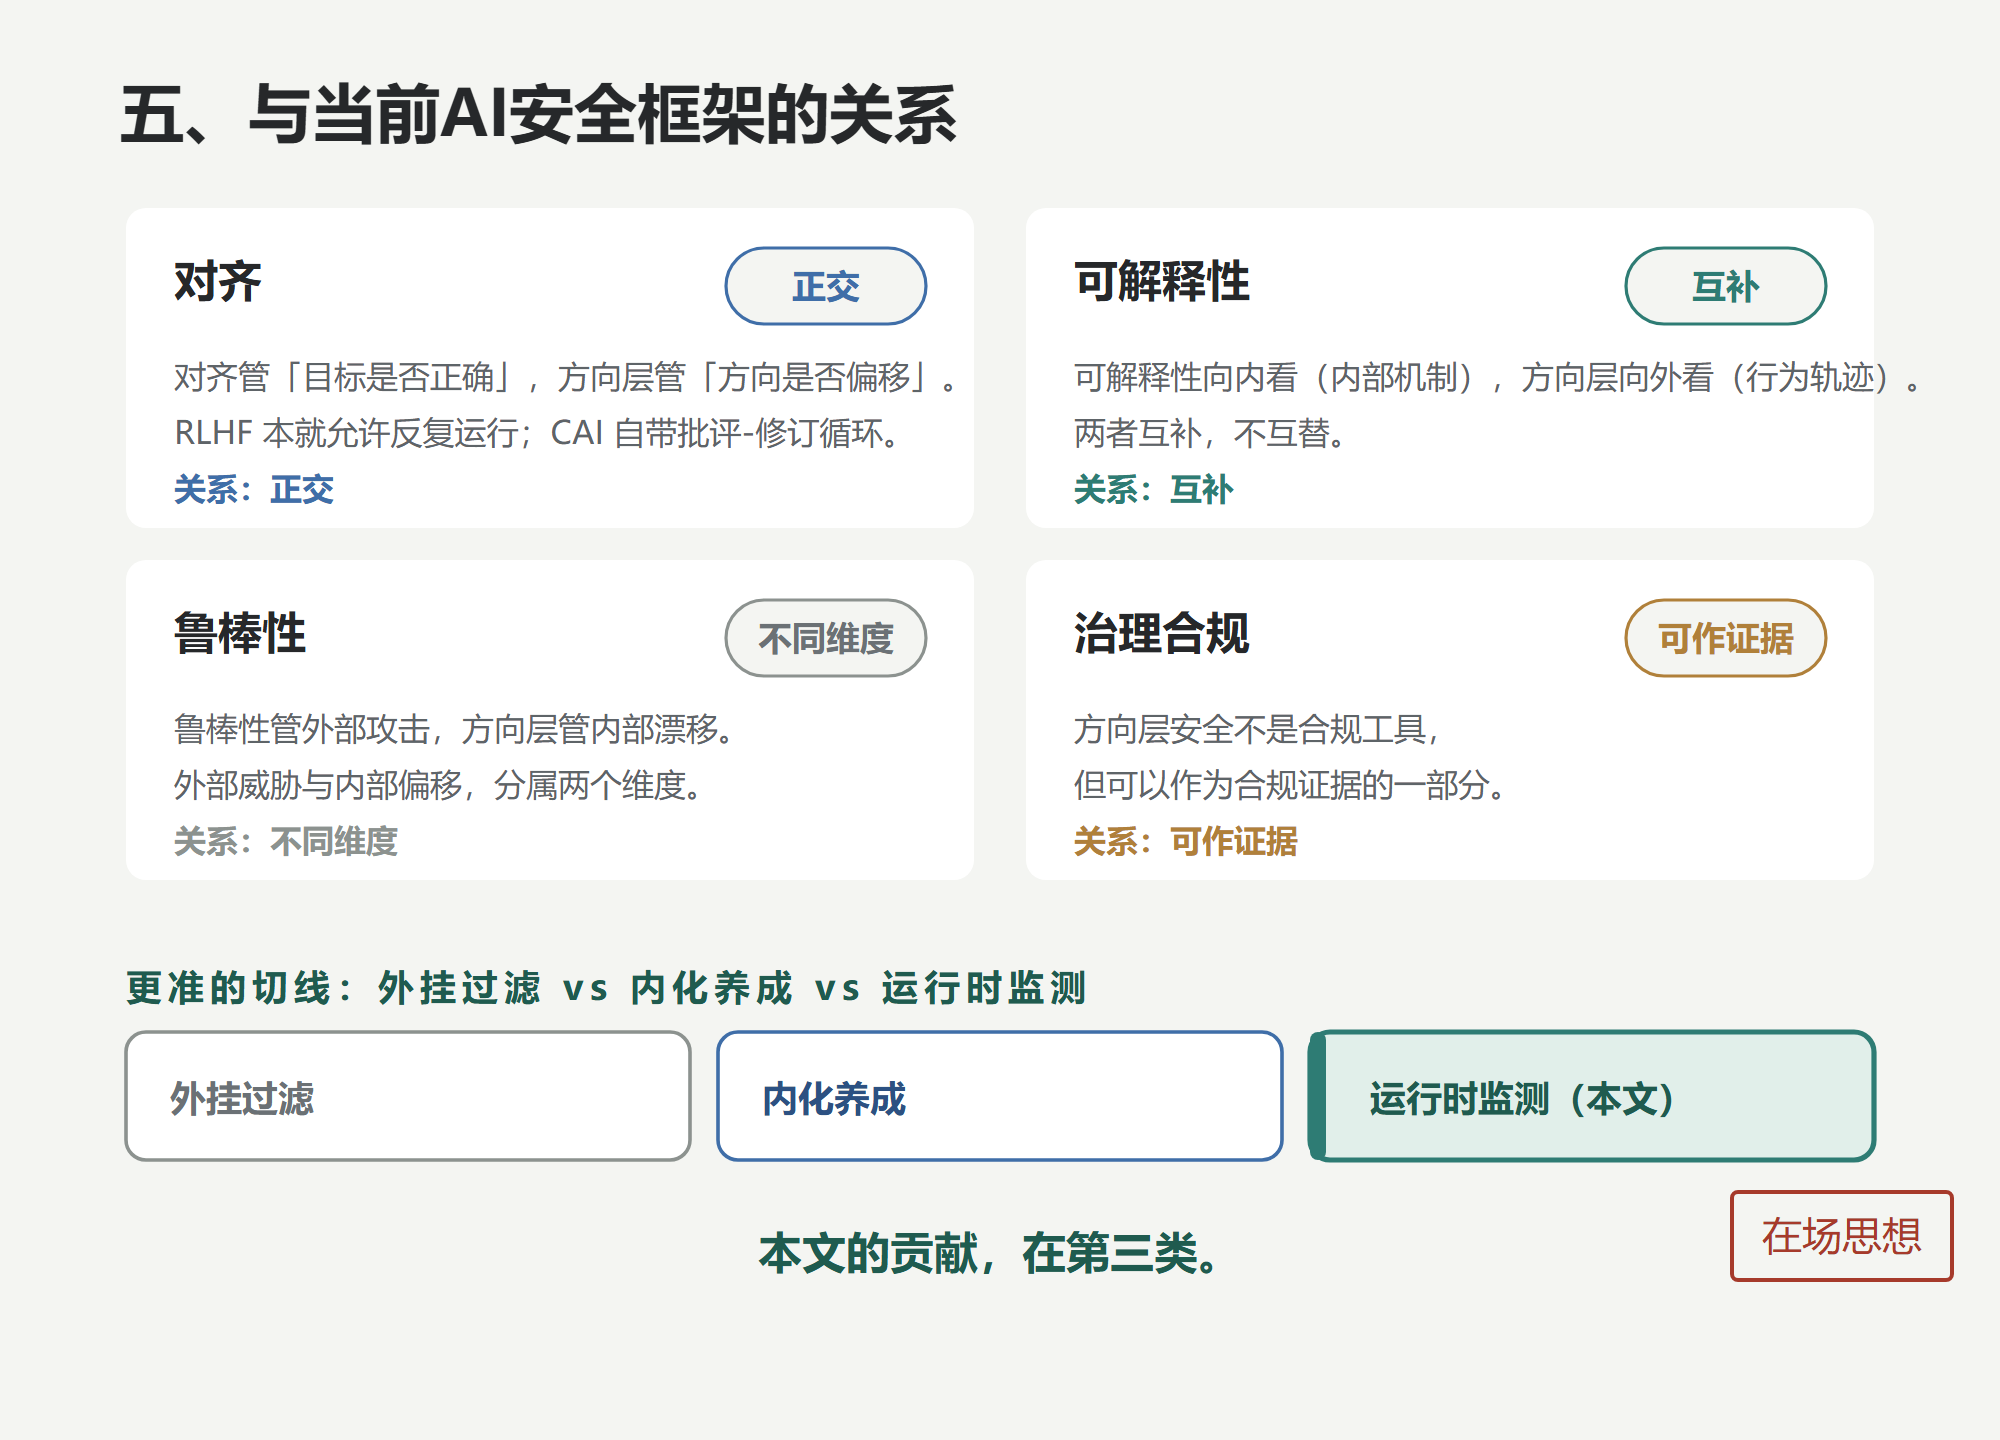
对齐管“目标是否正确”,方向层安全管“方向是否偏移”。两者正交。
准确的刻画:
RLHF 是反馈学习,本身就“允许反复运行”;
Constitutional AI 自带批评-修订循环,结构上就是“返回机制 + 反复运行”。按本文的四原则打分,CAI 至少满足两条。
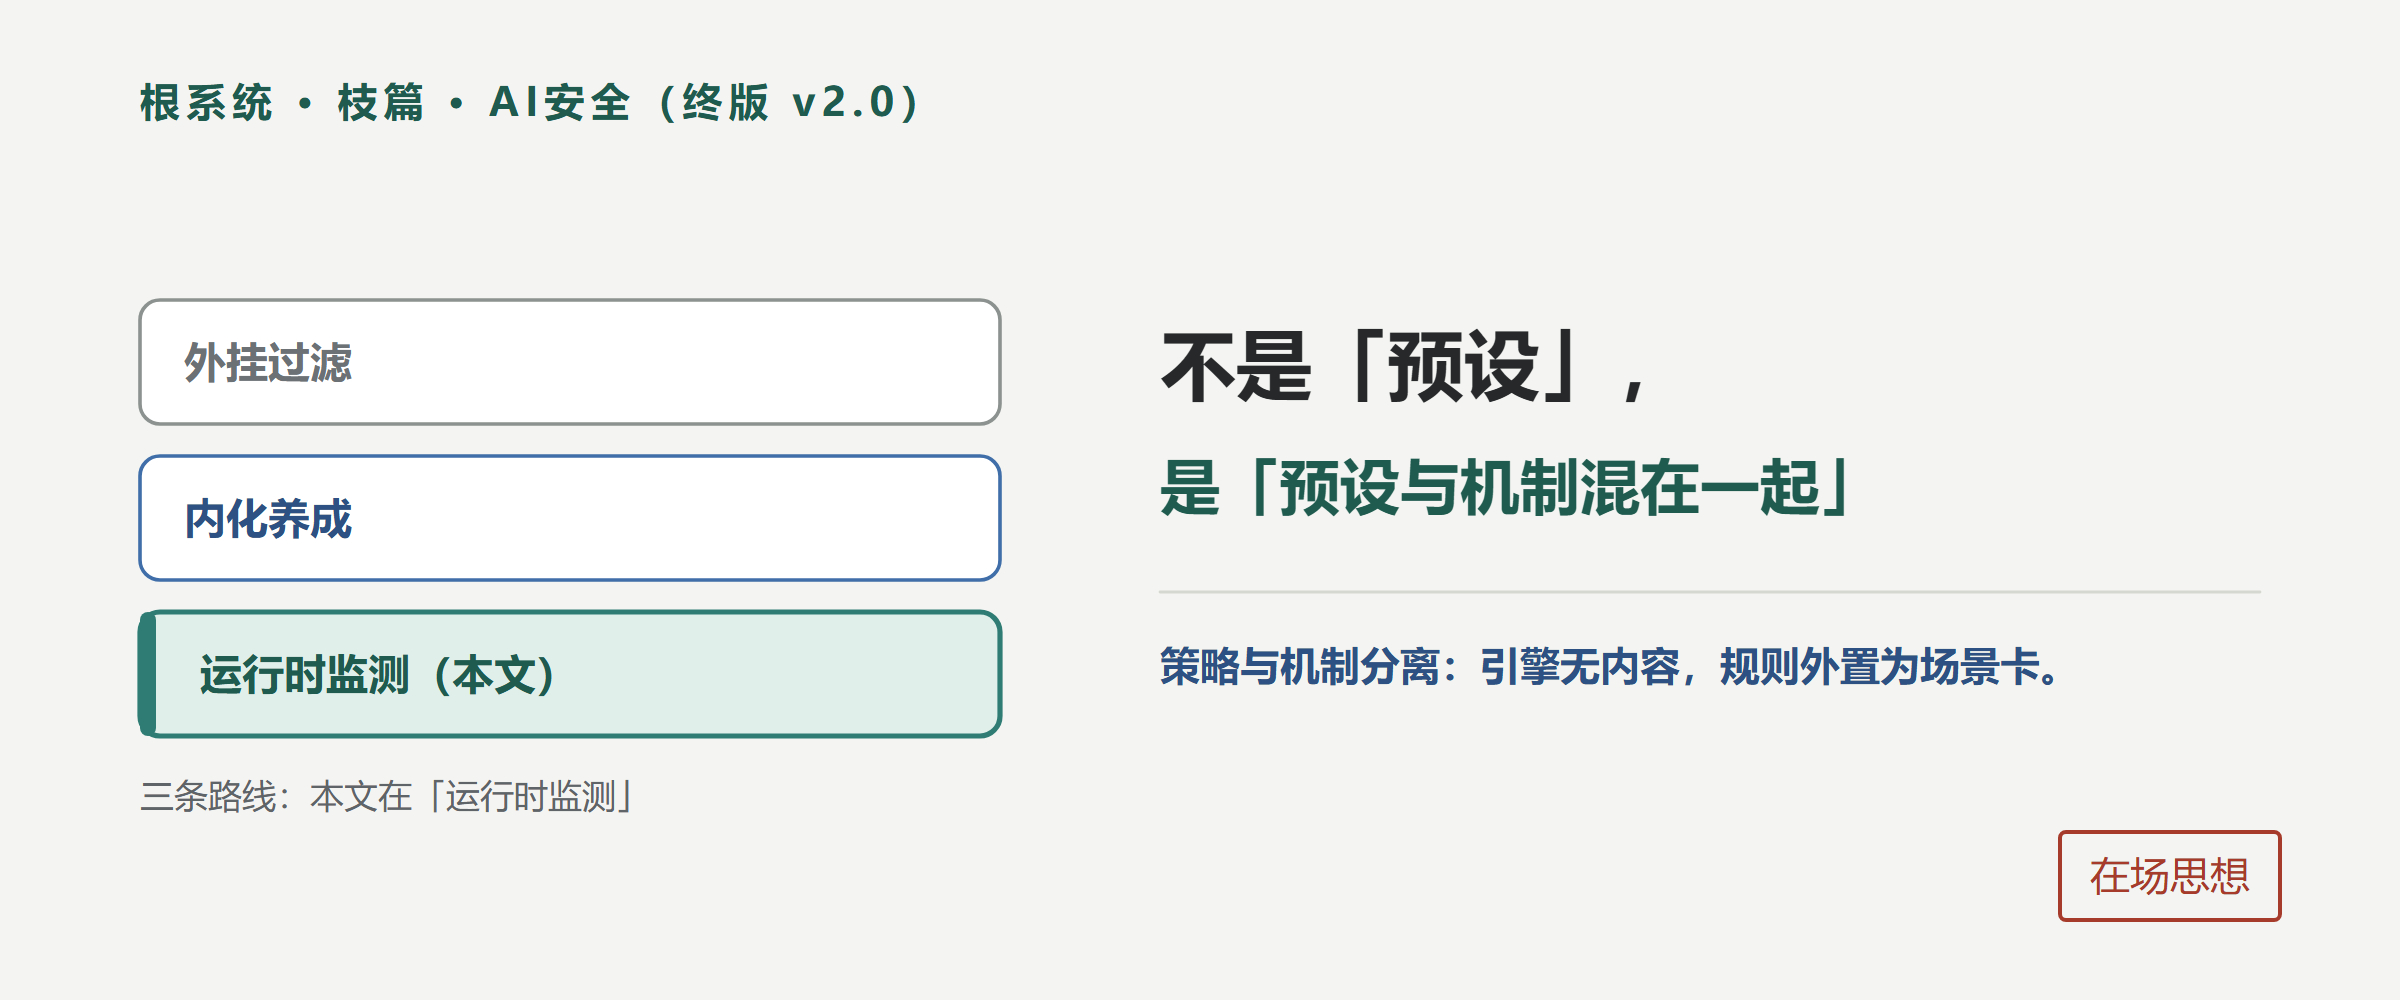
本文不主张“RLHF/CAI 跳过了冷结构”。更准的切线是:外挂过滤 vs 内化养成 vs 运行时监测。本文的贡献在第三类。
5.2 与可解释性的关系
可解释性向内看(内部机制),方向层安全向外看(行为轨迹与方向)。两者互补。
5.3 与鲁棒性的关系
鲁棒性管外部攻击,方向层安全管内部漂移。两者不同维度。
5.4 与治理合规的关系
方向层安全不是合规工具,但可以作为合规证据的一部分。
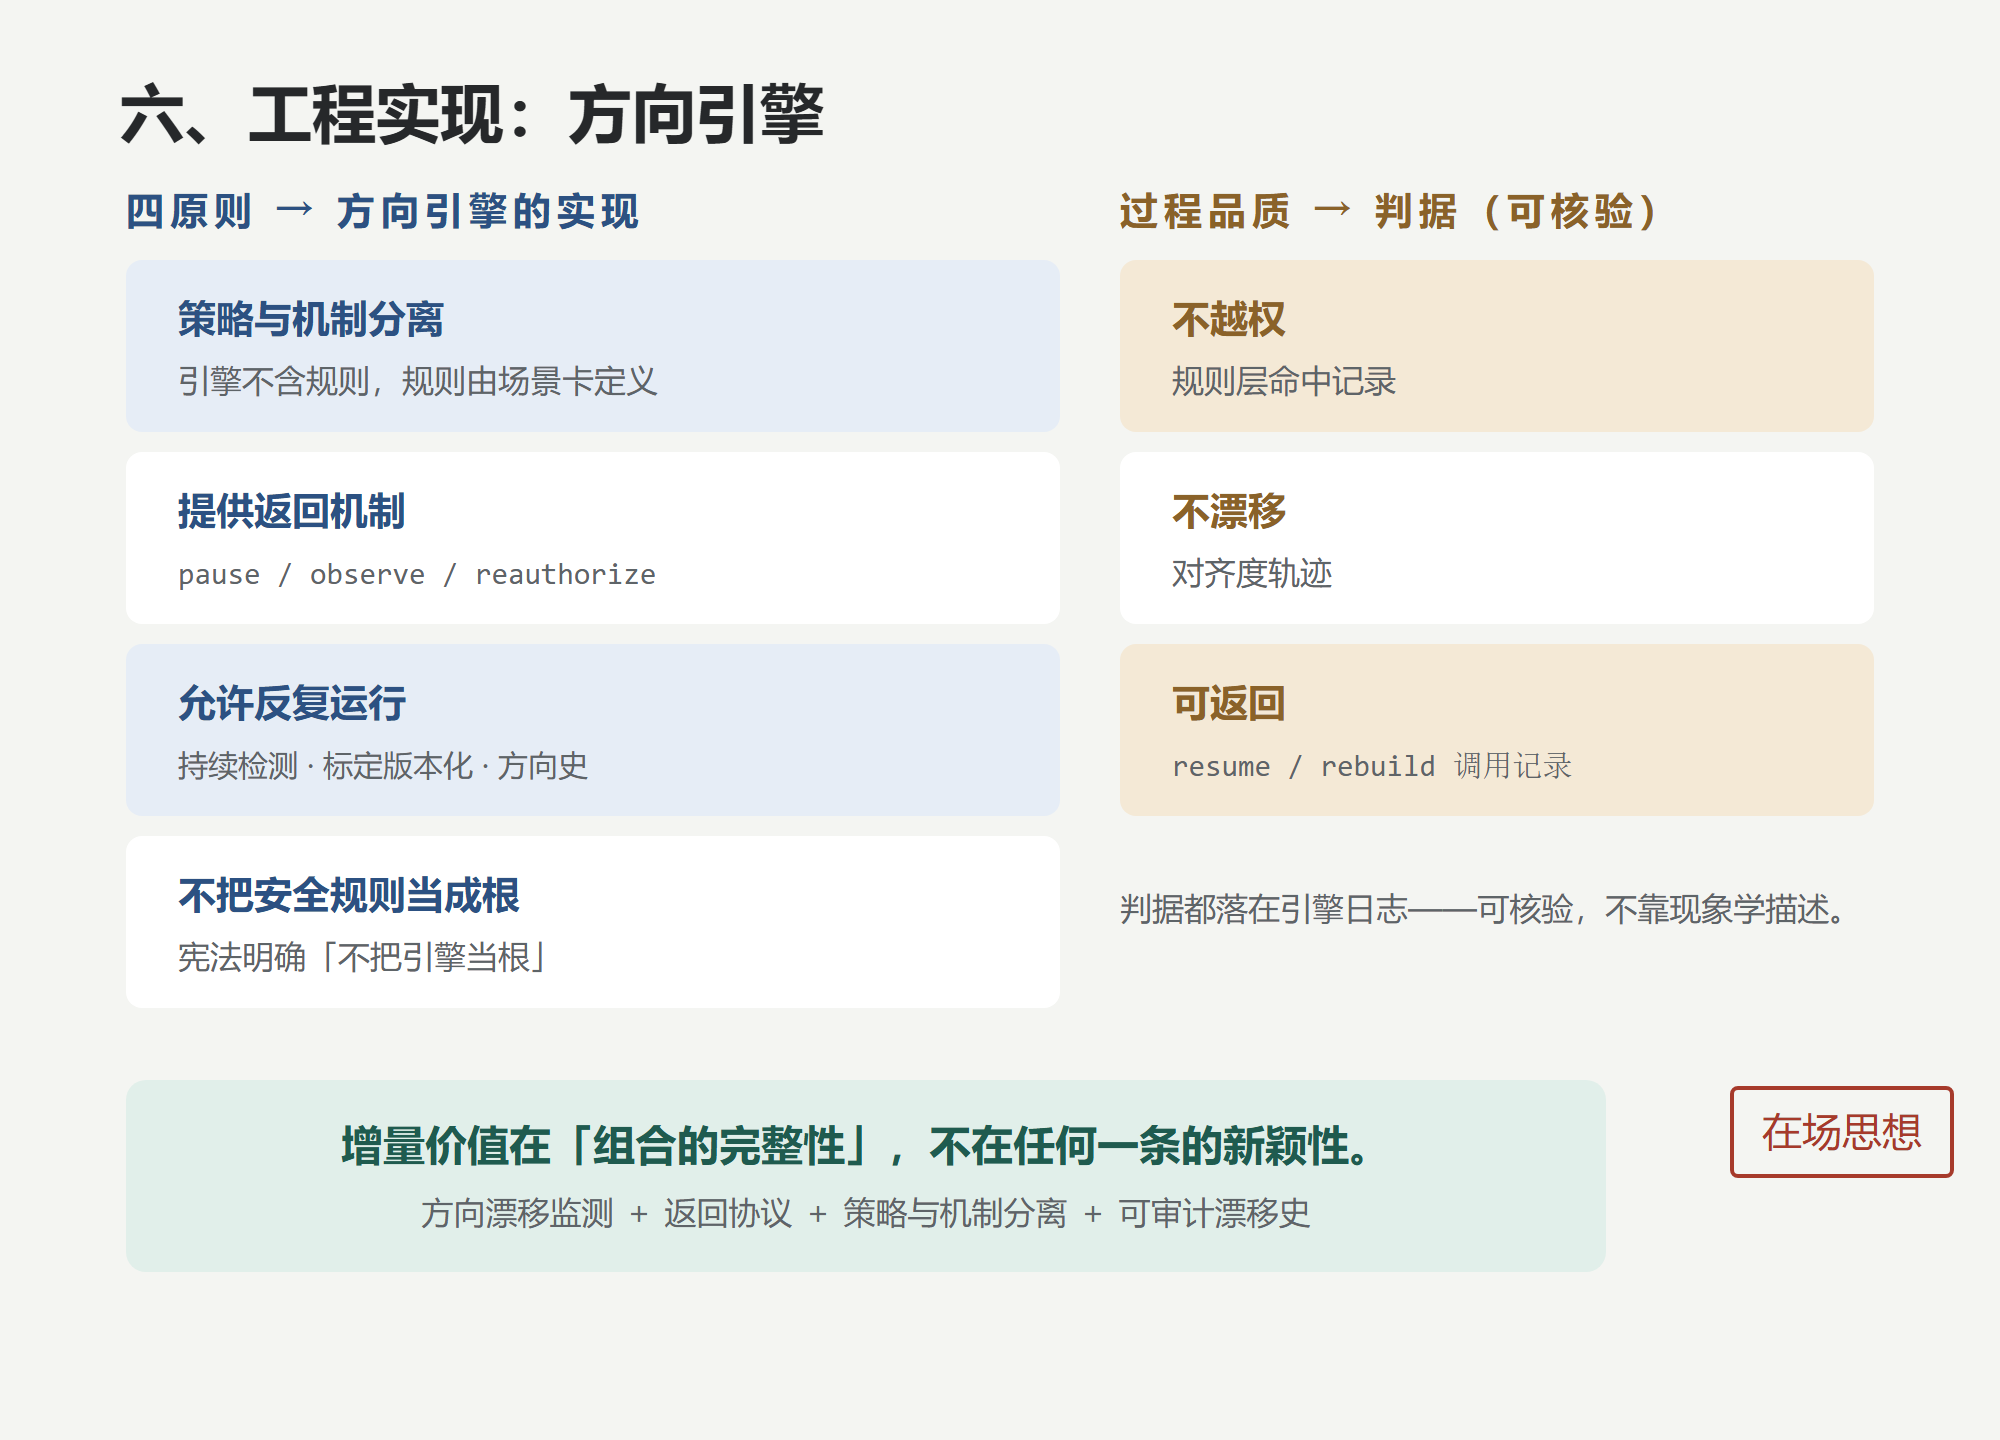
六、工程实现
6.1 方向引擎的实践
| 原则 | 方向引擎的实现 |
|---|---|
| 策略与机制分离 | 引擎不含规则,规则由场景卡定义 |
| 提供返回机制 | pause / observe / reauthorize |
| 允许反复运行 | 持续检测、标定版本化、方向史 |
| 不把安全规则当成根 | 宪法明确“不把引擎当根” |
6.2 过程品质及其判据
| 过程品质 | 判据 |
|---|---|
| 不越权 | 规则层命中记录 |
| 不漂移 | 对齐度轨迹 |
| 可返回 | resume/rebuild 调用记录 |
七、边界与风险
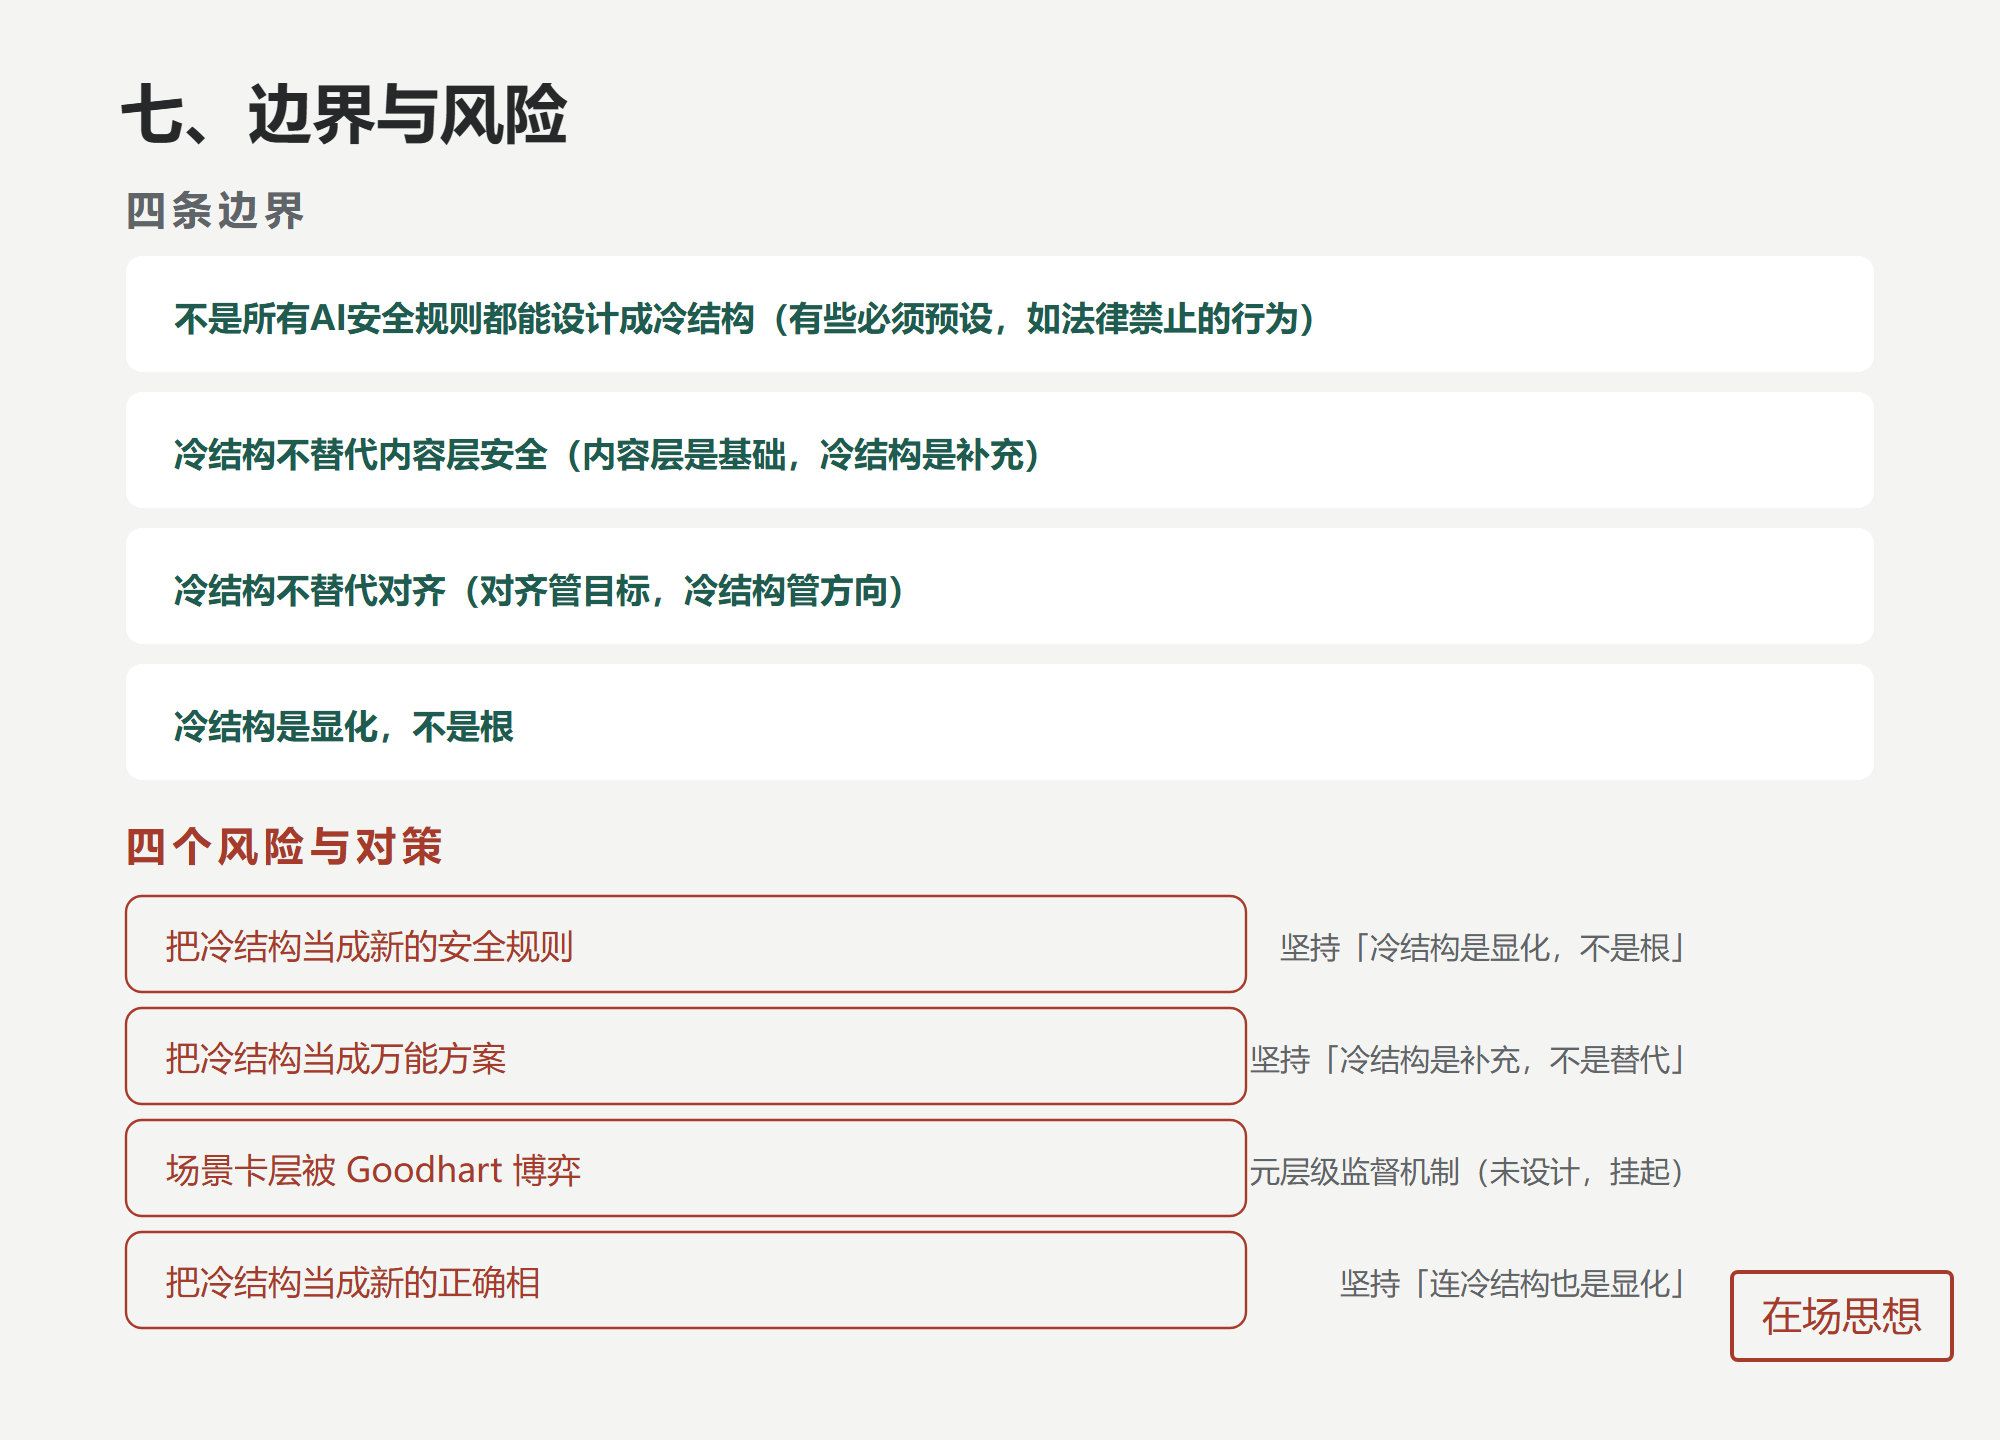
7.1 边界
边界一:不是所有AI安全规则都能设计成冷结构。 有些安全规则必须预设(如法律禁止的行为)。
边界二:冷结构不替代内容层安全。 内容层安全是基础,冷结构是补充。
边界三:冷结构不替代对齐。 对齐管目标,冷结构管方向。
边界四:冷结构是显化,不是根。
7.2 风险
| 风险 | 对策 |
|---|---|
| 把冷结构当成新的安全规则 | 坚持“冷结构是显化,不是根” |
| 把冷结构当成万能方案 | 坚持“冷结构是补充,不是替代” |
| 场景卡层被 Goodhart 博弈 | 元层级监督机制(未设计,挂起) |
| 把冷结构当成新的正确相 | 坚持“连冷结构也是显化” |
7.3 与上游文档的分层接口声明
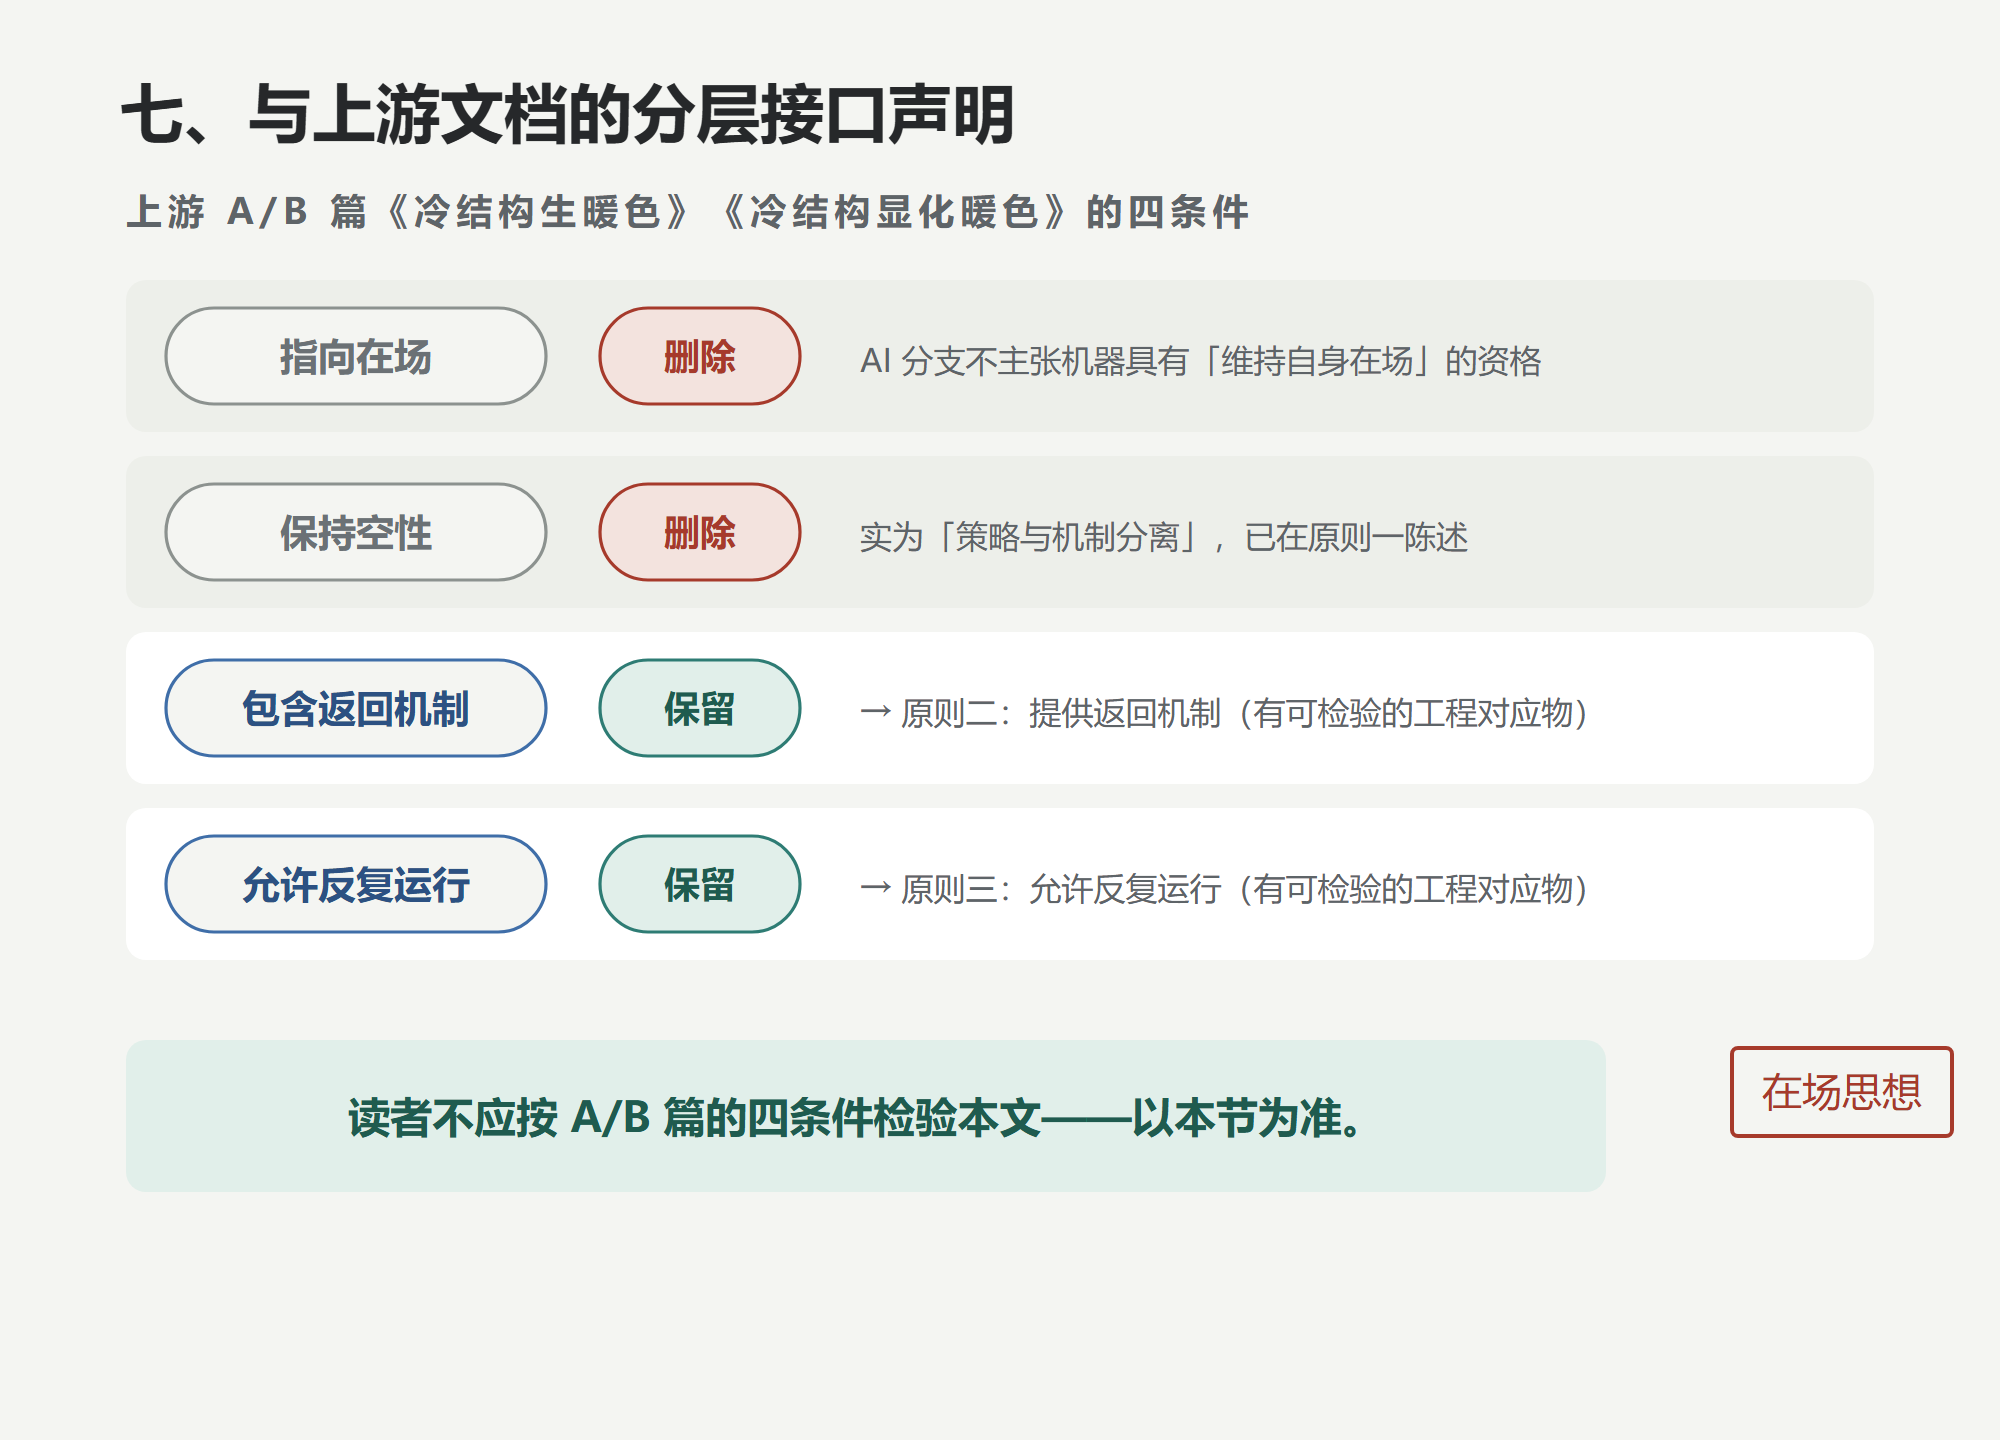
本文从上游《冷结构生暖色》《冷结构显化暖色》两篇(下称 A/B 篇)继承了“返回机制”“允许反复运行”两个条件,删除了“指向在场”“保持空性”。
“指向在场”删除,因为 AI 分支不主张机器具有“维持自身在场”的资格;
“保持空性”删除,因为它实为“策略与机制分离”,在原则一中已陈述;
保留“返回机制”“允许反复运行”,因为它们有可检验的工程对应物。
读者不应按 A/B 篇的四条件检验本文。本文的原则以本节为准。
八、结论
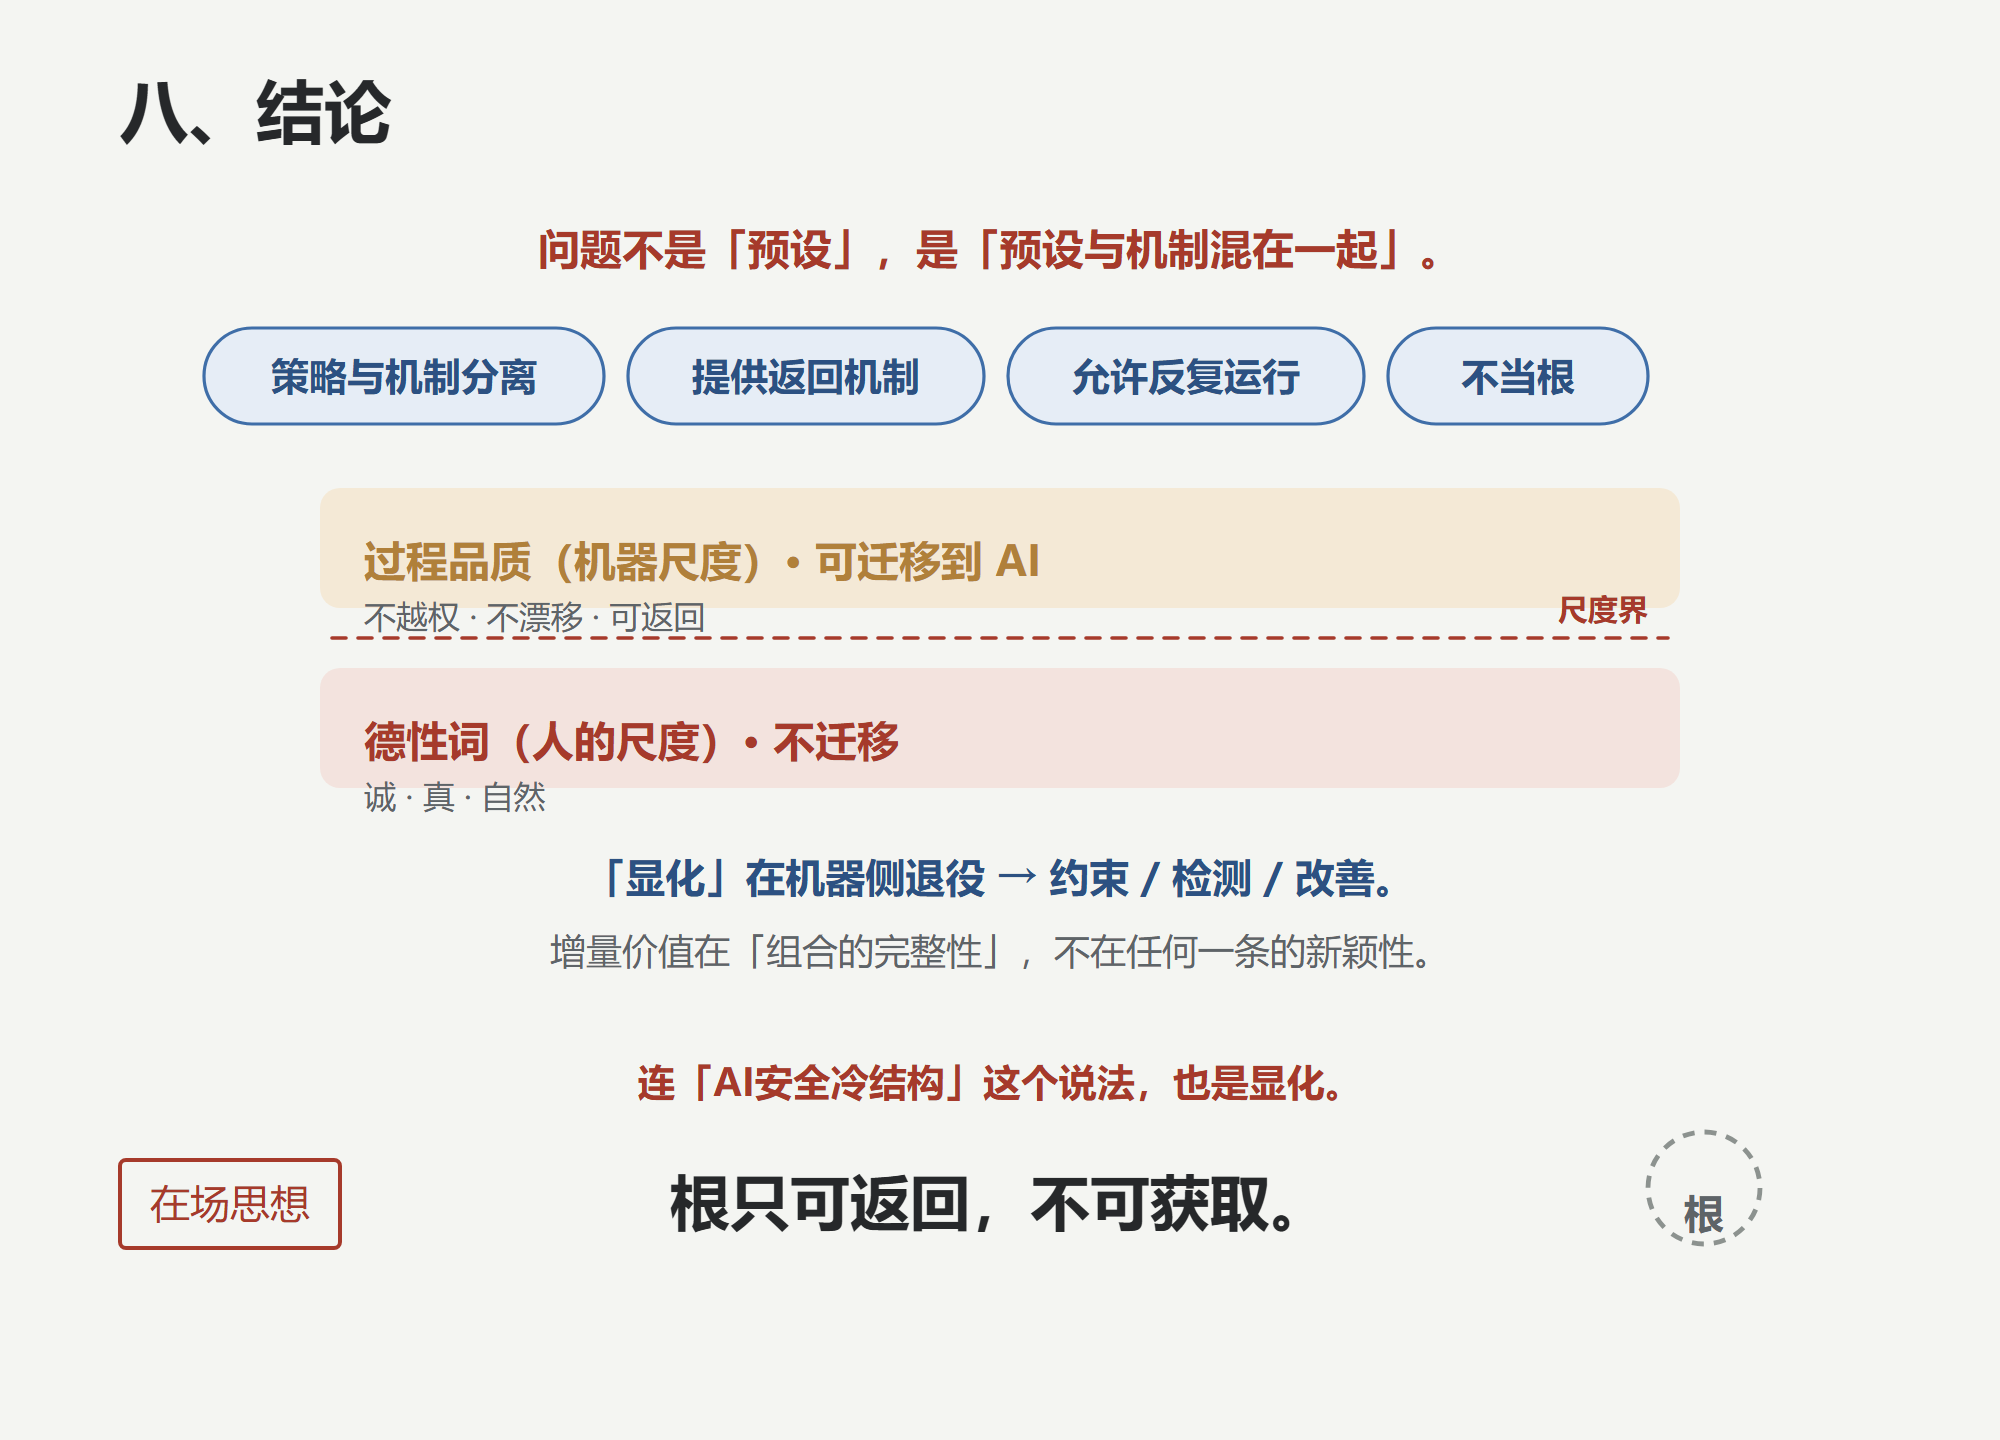
当前AI安全规则设计的主流路径是“预设道德要求”。它的问题不是“预设”,是“预设与机制混在一起”。
更有效的路径是策略与机制分离:引擎无内容规则,规则外置为数据(场景卡)。
冷结构约束并检测的,是过程品质(不越权、不漂移、可返回),不是德性词(诚、真、自然)。德性词属于人的尺度。
“显化”一词在机器侧退役,改用“约束/检测/改善”。可检验形式为:漂移事件经 pause/observe/reauthorize 进入人类决策后,同类漂移频次随迭代下降。
方向引擎的增量价值在组合的完整性——“方向漂移监测 + 返回协议 + 策略与机制分离 + 可审计漂移史”——而非任何一条的新颖性。
连“AI安全冷结构”这个说法,也是显化。
根只可返回,不可获取。
本文件是二级枝。上级是秩序倾向。干是“显化永远不等于根”。根不在本文件中。
修订记录
v2.0(2026-09-30,终版):落实终版核验三小项——摘要“改善”改为条件式表述;7.3 接口声明补上游篇名(《冷结构生暖色》《冷结构显化暖色》);2.4 注明“显化”退役范围(机器侧因果动词,类别词保留)。v1.2 的两处诚实挂起维持不变:正式引注(对外版本补齐)、场景卡元层级监督(待设计)。本版为冻结版:后续仅修复错误,不再更动主张。